
Mettre les données à leur place
Aussi en 28 langues
English · Español · 日本語 · Português (Brasil) · Français · Deutsch · Italiano · 한국어 · 简体中文 · Português (Portugal) · 繁體中文 · Bahasa Indonesia · Türkçe · Polski · Tiếng Việt · ไทย · Nederlands · العربية · עברית · Українська · हिन्दी · Русский · Svenska · Dansk · Norsk bokmål · Suomi · Español (México) · Deutsch (Schweiz)
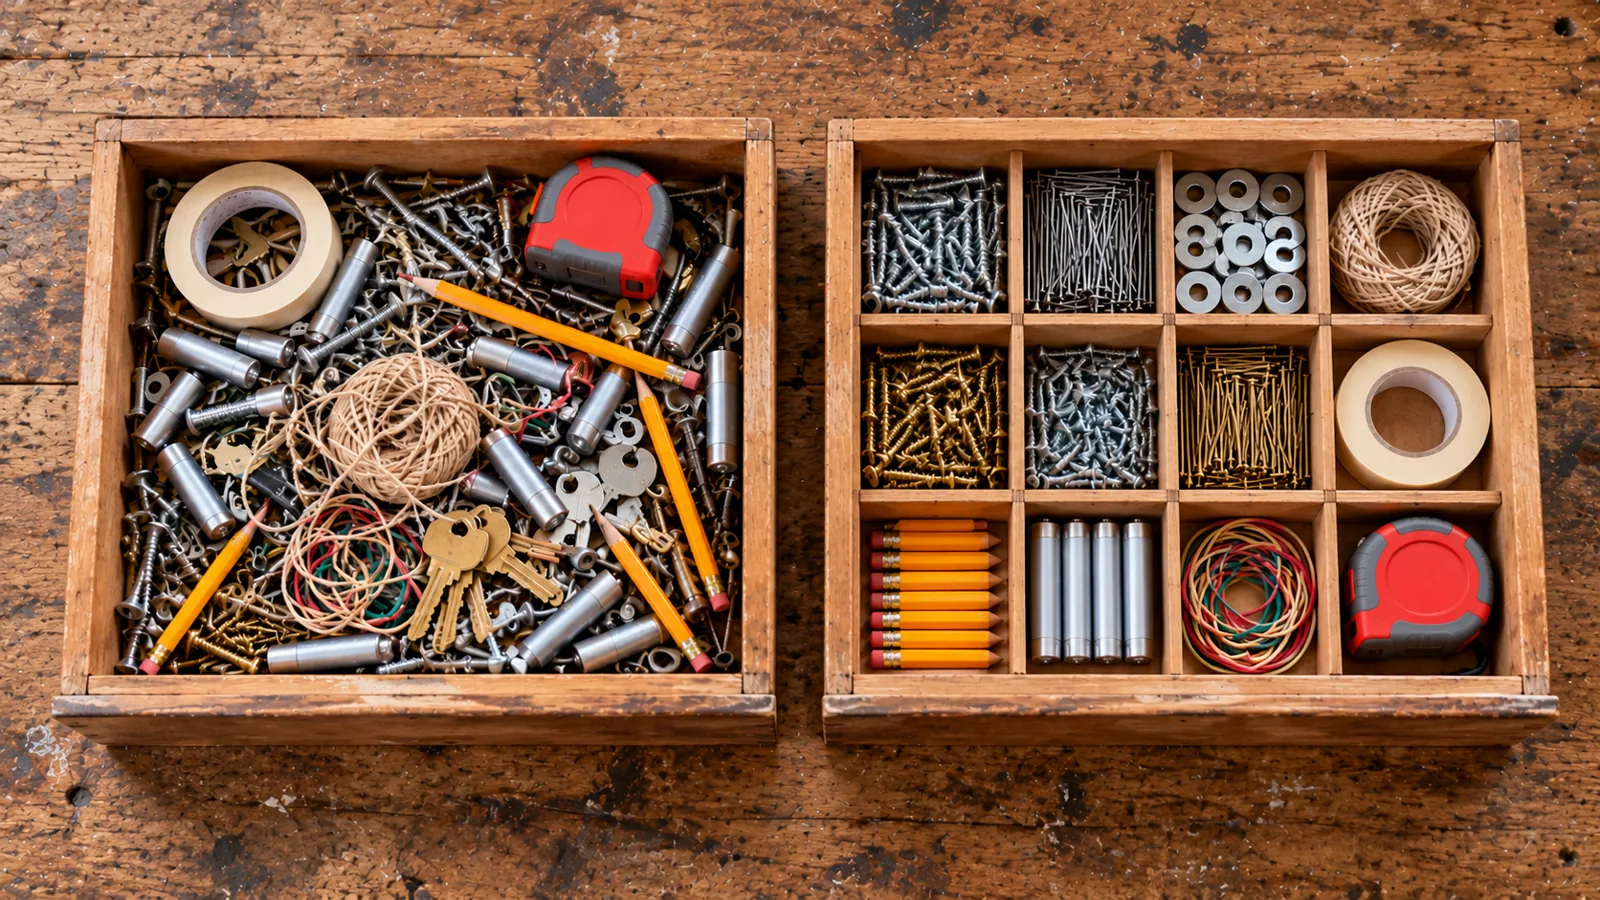
Module 4 sur 6 du chapitre Modéliser les données pour leur sens, chapitre 2 du cours Data Architect. Chaque module se suffit à lui-même. Précédent : Construire le modèle logique · Suivant : Concevoir en troisième forme normale, puis prendre du recul
La question à laquelle répond ce module : comment la normalisation m’aide-t-elle à savoir où les données ont vraiment leur place ?
Nous avons un modèle logique : entités, relations, attributs et clés. Je veux maintenant poser l’une des questions les plus importantes de la modélisation des données : ces données ont-elles vraiment leur place ici ?
Cela paraît simple. Ça ne l’est pas. J’ai vu beaucoup de systèmes où chaque champ avait du sens au moment de sa création. Le problème n’était pas que les champs étaient absurdes ; c’était que les faits étaient stockés au mauvais endroit. Une livraison contient des informations qui décrivent en réalité un centre de distribution. La même adresse apparaît sur des centaines d’enregistrements. Un champ contient trois valeurs séparées par des virgules. Changer un seul fait métier oblige à mettre à jour 10 000 enregistrements. C’est le problème que la normalisation nous aide à résoudre, et avant de nous noyer dans la terminologie des bases de données, voici toute l’idée : mettez un fait à sa place. Tout le reste de ce module nous aide à le faire plus méthodiquement.
Qu’est-ce que la normalisation ?
Section intitulée « Qu’est-ce que la normalisation ? »La normalisation, c’est organiser les données pour que chaque fait soit stocké une seule fois, à l’endroit où il a sa place. Quand une table fait trop de travaux à la fois, nous la découpons en tables qui décrivent chacune une seule chose, et nous les relions par des clés.
Pourquoi s’en donner la peine ? Parce qu’un fait stocké une seule fois est un fait que l’on modifie une seule fois. La normalisation évite la redondance, le même fait copié sur de nombreux enregistrements, et avec elle les incohérences qui s’installent quand une copie est mise à jour et pas les autres. C’est pourquoi elle convient aux systèmes transactionnels comme Salesforce, où les enregistrements sont créés et mis à jour toute la journée.
Nous normalisons par étapes appelées formes normales, et chacune pose une seule question :
- Première forme normale (1FN) : une seule valeur par champ, et quelque chose qui identifie de façon unique chaque ligne.
- Deuxième forme normale (2FN) : chaque fait décrit la totalité de ce qui identifie la ligne, pas seulement une partie.
- Troisième forme normale (3FN) : chaque fait décrit cette chose, pas autre chose à laquelle elle est liée.
Il existe d’autres formes au-delà de la troisième. J’en dirai un mot plus loin, et j’expliquerai pourquoi nous nous arrêtons généralement à la troisième. D’abord, regardons les trois étapes se dérouler.
Pourquoi normaliser ?
Section intitulée « Pourquoi normaliser ? »Quand j’enseigne cela en direct, je ne commence pas par les livraisons. Je commence par les chiens. Tout le monde comprend les chiens, donc personne n’est distrait par le métier, et nous pouvons regarder les données chercher leur place. Ensuite, nous appliquons les mêmes gestes à Steve Trucking.
Assis, pas bouger, modèle
Section intitulée « Assis, pas bouger, modèle »Départ : le tableur brut. Je mets deux ou trois chiens à l’écran, puis la salle ajoute les siens. En quelques minutes, nous avons une grande liste : le chien, son année de naissance, son propriétaire, où vit le propriétaire, la race, l’éleveur et les tours qu’il connaît.
| Chien | Né en | Propriétaire | Code postal | Ville | Race | Éleveur | Tours |
|---|---|---|---|---|---|---|---|
| Bella | 2017 | Marcus | 80202 | Denver | Labrador | Maple Ridge | Assis, Pas bouger, Donne la patte |
| Milo | 2019 | Marcus | 80202 | Denver | Caniche | Golden Meadow | Assis, Roule |
| Max | 2022 | Ana | 64105 | Kansas City | Croisé | Assis, Fais le mort | |
| Luna | 2020 | Kenji | 98101 | Seattle | Husky | Cascade | Assis, Pas bouger, Tourne |
| Rocky | 2024 | Priya | 30301 | Atlanta | Beagle | Maple Ridge | Assis |
| Coco | 2014 | Ana | 64105 | Kansas City | Chihuahua | Little Paws | Donne la patte, Tourne |
Ça fonctionne. Tous les tableurs fonctionnent le premier jour. Mais regardez ce qui cloche déjà. Comment trouver tous les chiens qui savent donner la patte ? Le code postal d’Ana figure sur deux lignes, celui de Marcus aussi : que se passe-t-il si quelqu’un met à jour l’une et pas l’autre ? Maple Ridge apparaît deux fois, et Kansas City aussi. Et Max vient de la fourrière, donc il n’a aucun éleveur.
Étape 1 : la première forme normale. Deux règles. Chaque champ contient une seule valeur, donc la liste de tours séparés par des virgules doit disparaître. Et chaque ligne a besoin de quelque chose qui l’identifie de façon unique. Pas le nom du chien ; il y a beaucoup de chiens qui s’appellent Max. Un ID : un ID auto-généré ou un GUID. Les tours sortent dans leurs propres lignes, une ligne par chien et par tour. Et une fois qu’un tour a sa propre ligne, il y a de la place pour ce qu’une liste à virgules ne pouvait jamais dire : la difficulté du tour, le niveau de ce chien, et quand il l’a appris.
Chien (identifié par l’ID du chien)
| ID du chien | Nom | Né en | Propriétaire | Code postal | Ville | Race | Éleveur |
|---|---|---|---|---|---|---|---|
| D-001 | Bella | 2017 | Marcus | 80202 | Denver | Labrador | Maple Ridge |
| D-002 | Milo | 2019 | Marcus | 80202 | Denver | Caniche | Golden Meadow |
| D-003 | Max | 2022 | Ana | 64105 | Kansas City | Croisé | |
| D-004 | Luna | 2020 | Kenji | 98101 | Seattle | Husky | Cascade |
| D-005 | Rocky | 2024 | Priya | 30301 | Atlanta | Beagle | Maple Ridge |
| D-006 | Coco | 2014 | Ana | 64105 | Kansas City | Chihuahua | Little Paws |
Tour du chien (identifié par l’ID du chien + le tour)
| ID du chien | Tour | Difficulté | Niveau de maîtrise | Appris |
|---|---|---|---|---|
| D-001 | Assis | Facile | Expert | 2017-11 |
| D-001 | Pas bouger | Facile | Expert | 2018-01 |
| D-001 | Donne la patte | Moyen | Bon | 2018-06 |
| D-002 | Assis | Facile | Expert | 2020-02 |
| D-002 | Roule | Difficile | En apprentissage | 2023-05 |
| D-003 | Assis | Facile | Bon | 2022-06 |
| D-003 | Fais le mort | Difficile | En apprentissage | 2024-03 |
| D-004 | Assis | Facile | Expert | 2020-11 |
| D-004 | Pas bouger | Facile | Bon | 2021-01 |
| D-004 | Tourne | Moyen | Expert | 2021-06 |
| D-005 | Assis | Facile | En apprentissage | 2025-02 |
| D-006 | Donne la patte | Moyen | Expert | 2015-06 |
| D-006 | Tourne | Moyen | En apprentissage | 2025-04 |
Maintenant, « tous les chiens qui savent donner la patte » est une question simple. Mais remarquez par quoi le Tour du chien est identifié : pas une seule chose, deux choses ensemble, le chien et le tour. Gardez cela en tête.
Étape 2 : la deuxième forme normale. La deuxième forme normale ne compte que quand une ligne est identifiée par une combinaison, et c’est le cas du Tour du chien. Je pose donc la question à chaque colonne : décrit-elle toute la combinaison, ou seulement une partie ? Le Niveau de maîtrise décrit ce chien qui fait ce tour : Bella est experte sur « Assis », Rocky est encore en apprentissage. Appris, pareil. Mais la Difficulté ? « Assis » est facile quel que soit le chien qui le fait. Elle décrit le tour, seulement une partie de la clé, et c’est pourquoi « Facile » est répété sur chaque ligne « Assis ». Le tour reçoit donc sa propre table, et ce qui reste, c’est la paire.
Tour
| ID du tour | Tour | Difficulté |
|---|---|---|
| T-01 | Assis | Facile |
| T-02 | Pas bouger | Facile |
| T-03 | Donne la patte | Moyen |
| T-04 | Roule | Difficile |
| T-05 | Fais le mort | Difficile |
| T-06 | Tourne | Moyen |
Tour du chien (ID du chien + ID du tour)
| ID du chien | ID du tour | Niveau de maîtrise | Appris |
|---|---|---|---|
| D-001 | T-01 | Expert | 2017-11 |
| D-001 | T-02 | Expert | 2018-01 |
| D-001 | T-03 | Bon | 2018-06 |
| D-002 | T-01 | Expert | 2020-02 |
| D-002 | T-04 | En apprentissage | 2023-05 |
| D-003 | T-01 | Bon | 2022-06 |
| D-003 | T-05 | En apprentissage | 2024-03 |
| D-004 | T-01 | Expert | 2020-11 |
| D-004 | T-02 | Bon | 2021-01 |
| D-004 | T-06 | Expert | 2021-06 |
| D-005 | T-01 | En apprentissage | 2025-02 |
| D-006 | T-03 | Expert | 2015-06 |
| D-006 | T-06 | En apprentissage | 2025-04 |
Cette table Tour du chien est celle que nous avons trouvée au module 2, et elle a un nom en modélisation des données : une jonction, ou comme je l’appelle, un objet de jonction logique. Un chien connaît de nombreux tours ; un tour est connu de nombreux chiens. La jonction se place entre eux, et ce n’est pas de la tuyauterie vide : elle contient les faits qui appartiennent à la relation elle-même, le niveau de maîtrise et la date. Nous la retrouverons au module 6, et au chapitre 3 nous verrons que Salesforce emploie « objet de jonction » dans un sens plus étroit : un objet de jonction Salesforce (Salesforce Junction Object) est un objet personnalisé avec deux relations principal-détails (chapitre 3, module 7).
Étape 3 : la troisième forme normale. Revenons maintenant à la table Chien. Tout ce qu’elle contient est identifié par l’ID du chien, donc la deuxième forme normale n’a rien à dire. La troisième forme normale pose une autre question : ce fait décrit-il le chien, ou autre chose auquel le chien est lié ? La race est une chose à part entière : un labrador est un labrador quel que soit le chien, et les faits qui la concernent, comme sa taille, appartiennent à la race, pas à Bella. Le code postal et la ville décrivent le propriétaire, pas le chien : c’est là qu’habite Ana, quel que soit celui de ses chiens que nous regardons. Les informations sur l’éleveur décrivent l’éleveur. Chacun de ces éléments est un fait sur un autre fait, donc chacun part dans sa propre table, et le chien pointe vers elle avec une clé étrangère :
- Chien : ID du chien, Nom, Né en, ID du propriétaire, ID de la race, ID de l’éleveur
- Propriétaire : ID du propriétaire, Nom, Code postal, Ville
- Race : ID de la race, Race, Taille
- Éleveur : ID de l’éleveur, Nom, Ville
- Tour et Tour du chien, de l’étape 2
Ana est maintenant stockée une seule fois, et ses deux chiens pointent vers elle. Maple Ridge est stocké une seule fois, et la table Race nous donne une place pour les faits sur chaque race, comme sa taille, que le tableur n’avait nulle part où mettre. Une clé étrangère peut être vide : Max n’a pas d’ID d’éleveur, et c’est une réponse honnête, pas un trou. Puis je lance une question piège à la salle : la date à laquelle le propriétaire a eu le chien, où va-t-elle ? Sur le chien. Dans ce modèle, un chien a un seul propriétaire à la fois, donc cette date décrit la relation du chien avec son propriétaire.
On pourrait aller un cran plus loin et séparer la ville du code postal ; les manuels le font. En pratique, une adresse reste groupée, et Kansas City est de toute façon à cheval sur deux États, un bon rappel que le monde réel ne lit pas nos manuels.
Voilà la progression : un tableur, puis trois questions, et chaque fait finit à un seul endroit. Prenez du recul et regardez ce que nous avons construit. Une liste en désordre est devenue six tables, chacune décrivant une seule chose, reliées par des clés :
Personne n’a eu besoin d’un seul mot de Salesforce pour suivre cela. Ce sont juste les chiens, les gens autour d’eux, et ce qu’ils savent faire.
Appliquons-le maintenant à Steve Trucking
Section intitulée « Appliquons-le maintenant à Steve Trucking »Les chiens rendent les gestes faciles à voir. Un vrai métier leur donne de l’importance, parce que les mêmes erreurs coûtent de l’argent réel à grande échelle. Appliquons donc les mêmes trois questions à Steve Trucking. Imaginez qu’il garde ses livraisons comme ceci :
| Livraison | Partenaire distributeur | Centre de distribution | Ville du centre | Équipe | Camion |
|---|---|---|---|---|---|
| 1001 | Keystone | Keystone Phoenix DC | Phoenix | Crew 12 | 117 |
| 1002 | Keystone | Keystone Phoenix DC | Phoenix | Crew 8 | 122 |
| 1003 | Keystone | Keystone Phoenix DC | Phoenix | Crew 12 | 117 |
À première vue, rien n’est compliqué ici. Mais regardez le centre de distribution. Nous répétons « Keystone Phoenix DC, Phoenix » sur chaque livraison qui en part : Steve Trucking fait environ 3 300 livraisons par jour réparties sur neuf centres, donc quelques centaines par jour depuis chacun. Que se passe-t-il si ce centre déménage ? Combien d’enregistrements changeons-nous, et que se passe-t-il si l’un est oublié ? Les données disent alors que le centre est dans deux villes à la fois. C’est une anomalie de mise à jour. Et si nous voulons créer un nouveau centre avant sa première livraison ? Et si nous supprimons la dernière livraison d’un centre : venons-nous de supprimer le seul endroit où nous stockions quoi que ce soit à son sujet ?
Ce sont différents symptômes du même problème : nous avons mélangé des faits qui concernent des choses différentes. Les faits sur le centre de distribution ont leur place avec le centre. Les faits sur la livraison avec la livraison. Les faits sur l’équipe avec l’équipe. C’est cela, la normalisation, en termes pratiques.
Première forme normale : ne cachez pas une structure répétée
Section intitulée « Première forme normale : ne cachez pas une structure répétée »Commençons par la première forme normale, ou 1FN, là où l’on rend parfois la normalisation plus difficile qu’elle ne l’est.
Supposons qu’une livraison ait un champ Articles : « Réfrigérateur, kit machine à glaçons, enlèvement ». Nous avons mis trois informations dans un seul champ. Cela paraît pratique, jusqu’à ce que quelqu’un demande : « Combien d’enlèvements avons-nous faits le mois dernier ? » Ou imaginez des champs Article 1, Article 2 et Article 3. Ça fonctionne, jusqu’à la livraison avec quatre articles. Le problème n’est pas d’avoir choisi le mauvais nombre de champs Article. Le problème est de ne pas avoir reconnu la structure répétée. Une livraison peut avoir plusieurs articles. Ce sont des données à modéliser : l’article de livraison que nous avons trouvé au module 2.
La leçon pratique de la 1FN : ne cachez pas une structure répétée dans des champs. Si le métier vous dit que quelque chose peut se produire de nombreuses fois, écoutez. Une autre entité essaie peut-être de sortir.
Vous verrez cela tout le temps dans de vraies organisations. Quelqu’un a besoin d’une description en plusieurs langues, alors il crée un champ Description_English, puis Description_French, puis Description_German. Ou une approbation a besoin de quelques personnes, et on obtient Approbateur 1, Approbateur 2, Approbateur 3. Quand je trouve ça en revue, c’est une tape sur les doigts, corrigez votre modèle de données. Un ou deux, peut-être, si le métier n’en a vraiment jamais qu’un ou deux. Au-delà, ce devrait être un objet enfant : une traduction avec une langue, une étape d’approbation avec un approbateur. La langue suivante, ou le quatrième approbateur, devient un nouvel enregistrement, pas un nouveau champ et un déploiement.
Deuxième forme normale : décrivez le tout
Section intitulée « Deuxième forme normale : décrivez le tout »La deuxième forme normale, ou 2FN, compte quand un enregistrement est identifié par une combinaison de choses. Prenez l’article de livraison. Il a son propre ID d’enregistrement, mais chacun est unique par Livraison + Produit. Supposons que nous stockions la livraison, le produit, la quantité et la description du produit.
La quantité a du sens ici : elle décrit ce produit dans cette livraison. Mais la description du produit ne décrit pas la combinaison ; elle décrit le produit. Mettez-la sur chaque article de livraison et nous la répétons à chaque fois que ce modèle de réfrigérateur part dans un autre camion. C’est l’indice que le fait a sa place ailleurs.
La question de la 2FN est donc : cet attribut décrit-il tout ce que j’identifie, ou seulement une partie ? S’il ne décrit que le produit, il va avec Produit. S’il décrit la place du produit dans cette livraison précise (la quantité, s’il est installé), il a sa place sur l’article de livraison. Beaucoup d’administrateurs ne diront jamais consciemment « j’applique maintenant la deuxième forme normale ». Ce n’est pas grave. Je tiens beaucoup plus à ce que vous appreniez à demander : qu’est-ce que ce fait décrit réellement ?
Troisième forme normale : ne stockez pas de faits sur d’autres faits
Section intitulée « Troisième forme normale : ne stockez pas de faits sur d’autres faits »Voici maintenant celle qui compte le plus pour moi au quotidien : la troisième forme normale, ou 3FN.
Chaque centre de distribution a un responsable côté partenaire distributeur, quelqu’un qui utilise le portail partenaire. Supposons que nous mettions le nom du responsable du centre directement sur chaque livraison. Que se passe-t-il quand le centre a un nouveau responsable ? Nous mettons à jour chaque livraison de ce centre. C’est encore la même odeur : nous répétons un fait qui a sa place ailleurs. La livraison part d’un centre ; le centre a un responsable. Ce sont deux relations, et le nom du responsable a sa place avec le centre.
La version classique des manuels, c’est l’adresse : le code postal, la ville et l’État stockés ensemble sur chaque enregistrement, alors que la ville et l’État découlent généralement du code postal. Même forme, même question.
La question pratique de la 3FN est : ce fait décrit-il cette chose, ou autre chose à laquelle cette chose est liée ? Je veux que vous vous la posiez constamment.
Prenez maintenant du recul, comme nous l’avons fait avec les chiens. La table de livraisons de départ est devenue cinq choses, chacune avec ses propres faits : l’article de livraison est sorti à la première forme normale, le Produit à la deuxième, et la ville et le responsable du centre de distribution sont passés au centre de distribution à la troisième.
Mêmes trois questions, même résultat : chaque fait à un seul endroit.
Une façon simple de penser la 1FN, la 2FN et la 3FN
Section intitulée « Une façon simple de penser la 1FN, la 2FN et la 3FN »On peut consacrer un cours entier de bases de données à la normalisation. Nous ne le ferons pas. Pour ce cours, je veux que vous en ayez une compréhension d’architecte en exercice :
- 1FN : est-ce que je cache plusieurs valeurs ou des structures répétées dans un champ ou un enregistrement ?
- 2FN : ce fait décrit-il tout ce que j’identifie ?
- 3FN : ce fait décrit-il vraiment cette entité, ou quelque chose qui lui est lié ?
Ce ne sont pas des définitions pour un manuel de bases de données. Ce sont des questions que je peux réellement utiliser pendant que je conçois.
Oui, la normalisation va plus loin : la forme normale de Boyce-Codd (FNBC) resserre les règles autour de la 3FN pour les modèles aux clés plus complexes, et il existe des quatrième, cinquième et même sixième formes normales. Elles traitent des formes de répétition plus rares, celles qui viennent de structures de clés inhabituelles plus que des enregistrements métier de tous les jours. Beaucoup de théorie, et d’après mon expérience, ça ne vaut pas le mal de tête pour le genre de systèmes que nous construisons sur Salesforce. Dans les systèmes métier, la pression va généralement dans l’autre sens : nous avons bien plus de chances de nous écarter de la troisième forme normale, pour les utilisateurs, les rapports et les performances, que d’aller au-delà. C’est le module suivant. Sachez que les formes suivantes existent, mais pour l’essentiel de ce que nous faisons, la 1FN à la 3FN nous donnent les outils de réflexion dont nous avons besoin.
Concevoir en troisième forme normale
Section intitulée « Concevoir en troisième forme normale »Voici ma position. Quand j’essaie de comprendre un métier et de concevoir son modèle logique, je veux partir propre : les faits sur la livraison avec la livraison, ceux sur le centre de distribution avec le centre, ceux sur le camion avec le camion, les concepts répétés modélisés comme des concepts. Je ne veux pas qu’un fait métier soit copié partout dans le modèle juste parce que cela pourrait faciliter un écran ou un rapport. Pas encore.
Mais la normalisation n’est pas une religion. Le but n’est pas le modèle le plus pur possible sur le plan académique. J’ai vu des architectes tellement concentrés sur la pureté que le modèle devenait pénible pour tous ceux qui devaient l’utiliser. Nous n’essayons pas de gagner un concours de normalisation ; nous construisons un système, et ce système a des utilisateurs, des rapports, des intégrations, des besoins de performance, un volume et, de plus en plus, de l’IA qui lit les données. Ils peuvent vouloir les données sous d’autres formes.
Mon point de départ est donc concevoir en troisième forme normale quand c’est faisable, puis prendre du recul quand c’est nécessaire : comprendre d’abord où chaque fait a sa place. Ensuite, si nous nous en écartons, je veux savoir pourquoi. Si la réponse est « parce que je ne savais pas où mettre le champ ailleurs », ce n’est pas suffisant. Si la réponse est « nous avons délibérément copié cette valeur parce qu’elle simplifie le tableau de bord du partenaire, et nous avons un moyen fiable de la garder synchronisée », alors nous avons une conversation d’architecture.
Ce que l’architecte décide ici
Section intitulée « Ce que l’architecte décide ici »Quand je normalise un modèle logique, je cherche :
- Des valeurs ou structures répétées qui devraient être modélisées à part.
- Des attributs qui décrivent une autre entité que celle sur laquelle ils sont stockés.
- Des faits dupliqués inutilement sur de nombreux enregistrements, et les dépendances qui les rendent incohérents.
- Des concepts métier cachés dans des champs.
- Un modèle propre qui représente la vérité avant tout compromis de mise en œuvre.
Non pas parce que chaque système physique doit rester parfaitement normalisé. Bien au contraire. Dans le module suivant, nous nous écarterons volontairement du modèle propre, pour les utilisateurs, les rapports, le volume, l’analyse et l’IA, et nous le ferons en sachant exactement ce que nous échangeons.