
Lägg data där de hör hemma
Finns även på 28 språk
English · Español · 日本語 · Português (Brasil) · Français · Deutsch · Italiano · 한국어 · 简体中文 · Português (Portugal) · 繁體中文 · Bahasa Indonesia · Türkçe · Polski · Tiếng Việt · ไทย · Nederlands · العربية · עברית · Українська · हिन्दी · Русский · Dansk · Norsk bokmål · Suomi · Español (México) · Français (Canada) · Deutsch (Schweiz)
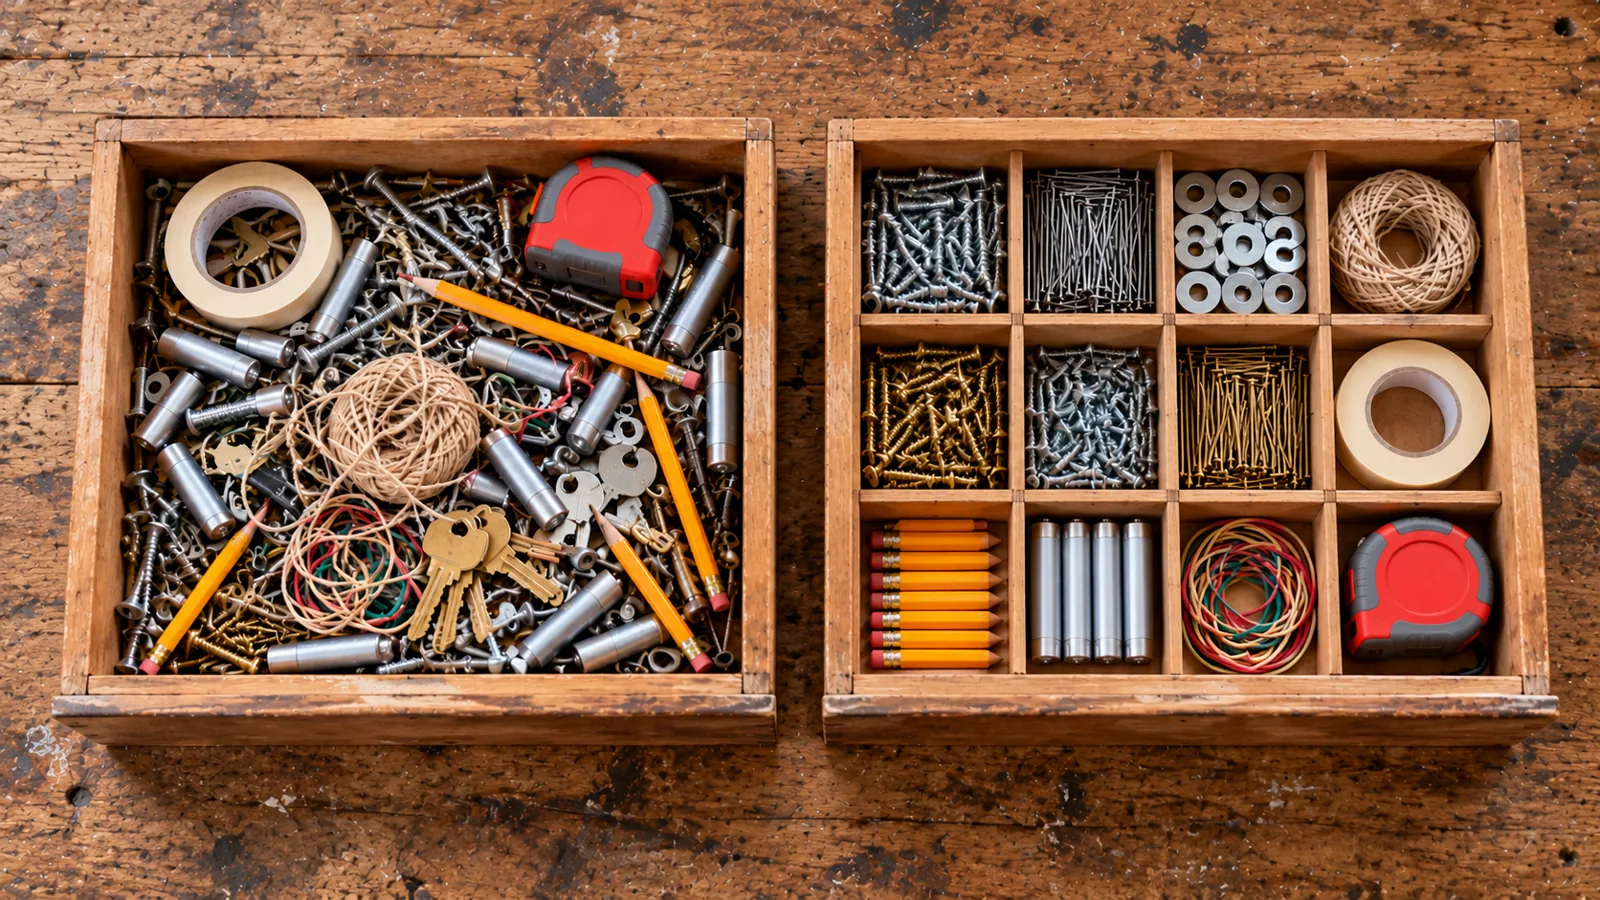
Modul 4 av 6 i kapitlet Modellera data för mening, kapitel 2 i kursen Data Architect. Varje modul står på egna ben. Föregående: Bygg den logiska modellen · Nästa: Designa till tredje normalformen, backa sedan
Frågan den här modulen besvarar: Hur hjälper normalisering mig att räkna ut var data verkligen hör hemma?
Vi har en logisk modell: entiteter, relationer, attribut och nycklar. Nu vill jag ställa en av de viktigaste frågorna i datamodellering: hör de här data faktiskt hemma här?
Det låter enkelt. Det är det inte. Jag har sett gott om system där varje fält var vettigt när någon skapade det. Problemet var inte att fälten var löjliga; det var att fakta lagrades på fel ställe. En leverans innehåller information som egentligen beskriver en distributionscentral. Samma adress finns på hundratals poster. Ett fält innehåller tre värden åtskilda med kommatecken. En ändring av ett enda affärsfaktum betyder att 10 000 poster måste uppdateras. Det är det problemet som normalisering hjälper oss att lösa, och innan vi begravs i databastermer kommer här hela idén: lägg ett faktum där det hör hemma. Allt annat i den här modulen hjälper oss att göra det mer systematiskt.
Vad är normalisering?
Section titled “Vad är normalisering? ”Normalisering är att organisera data så att varje faktum lagras en gång, på det ställe där det hör hemma. När en tabell gör för många jobb delar vi upp den i tabeller som var och en beskriver en sak, och kopplar ihop dem med nycklar.
Varför bry sig? För att ett faktum som lagras en gång är ett faktum vi ändrar en gång. Normalisering förhindrar redundans, samma faktum kopierat över många poster, och med den de inkonsekvenser som smyger sig in när en kopia uppdateras och de andra inte gör det. Därför passar den transaktionssystem som Salesforce, där poster skapas och uppdateras hela dagen.
Vi normaliserar i steg som kallas normalformer, och var och en ställer en enda fråga:
- Första normalformen (1NF): ett värde per fält, och något som unikt identifierar varje rad.
- Andra normalformen (2NF): varje faktum beskriver hela det som identifierar raden, inte bara en del av det.
- Tredje normalformen (3NF): varje faktum beskriver den här saken, inte något annat som den hänger ihop med.
Det finns fler former bortom den tredje. Jag säger några ord om dem senare, och om varför vi oftast stannar vid den tredje. Först ska vi se de tre stegen hända.
Varför normaliserar vi?
Section titled “Varför normaliserar vi? ”När jag undervisar det här live börjar jag inte med leveranser. Jag börjar med hundar. Alla förstår hundar, så ingen distraheras av verksamheten, och vi kan se hur data försöker hitta sitt hem. Sedan tar vi samma drag till Steve Trucking.
Sitt, stanna, modellera
Section titled “Sitt, stanna, modellera ”Start: det råa kalkylarket. Jag lägger upp ett par hundar på skärmen, och sedan lägger rummet till sina. Inom några minuter har vi en stor lista: hunden, året den föddes, vem som äger den, var ägaren bor, rasen, vem som födde upp den och vilka trick den kan.
| Hund | Född | Ägare | Postnummer | Ort | Ras | Uppfödare | Trick |
|---|---|---|---|---|---|---|---|
| Bella | 2017 | Marcus | 80202 | Denver | Labrador | Maple Ridge | Sitt, Stanna, Tass |
| Milo | 2019 | Marcus | 80202 | Denver | Pudel | Golden Meadow | Sitt, Rulla runt |
| Max | 2022 | Ana | 64105 | Kansas City | Blandras | Sitt, Död hund | |
| Luna | 2020 | Kenji | 98101 | Seattle | Husky | Cascade | Sitt, Stanna, Snurra |
| Rocky | 2024 | Priya | 30301 | Atlanta | Beagle | Maple Ridge | Sitt |
| Coco | 2014 | Ana | 64105 | Kansas City | Chihuahua | Little Paws | Tass, Snurra |
Det fungerar. Varje kalkylark fungerar första dagen. Men titta på vad som redan är fel. Hur hittar jag alla hundar som kan Tass? Anas postnummer står på två rader, och det gör Marcus också: vad händer om någon uppdaterar det ena och inte det andra? Maple Ridge förekommer två gånger, och det gör Kansas City också. Och Max kom från ett hundhem, så det finns ingen uppfödare alls.
Steg 1: första normalformen. Två regler. Varje fält innehåller ett enda värde, så den kommaseparerade listan med trick måste bort. Och varje rad behöver något som unikt identifierar den. Inte hundens namn; det finns väldigt många hundar som heter Max. Ett ID: ett automatiskt genererat ID eller ett GUID. Tricken flyttas ut till egna rader, en rad för varje hund och varje trick. Och när ett trick väl har en egen rad finns det plats för det vi aldrig kunde säga i en kommaseparerad lista: hur svårt tricket är, hur bra den här hunden gör det och när den lärde sig det.
Hund (identifieras av hund-ID)
| Hund-ID | Namn | Född | Ägare | Postnummer | Ort | Ras | Uppfödare |
|---|---|---|---|---|---|---|---|
| D-001 | Bella | 2017 | Marcus | 80202 | Denver | Labrador | Maple Ridge |
| D-002 | Milo | 2019 | Marcus | 80202 | Denver | Pudel | Golden Meadow |
| D-003 | Max | 2022 | Ana | 64105 | Kansas City | Blandras | |
| D-004 | Luna | 2020 | Kenji | 98101 | Seattle | Husky | Cascade |
| D-005 | Rocky | 2024 | Priya | 30301 | Atlanta | Beagle | Maple Ridge |
| D-006 | Coco | 2014 | Ana | 64105 | Kansas City | Chihuahua | Little Paws |
Hundtrick (identifieras av hund-ID + trick)
| Hund-ID | Trick | Svårighetsgrad | Färdighetsnivå | Inlärt |
|---|---|---|---|---|
| D-001 | Sitt | Lätt | Expert | 2017-11 |
| D-001 | Stanna | Lätt | Expert | 2018-01 |
| D-001 | Tass | Medel | Bra | 2018-06 |
| D-002 | Sitt | Lätt | Expert | 2020-02 |
| D-002 | Rulla runt | Svår | Lär sig | 2023-05 |
| D-003 | Sitt | Lätt | Bra | 2022-06 |
| D-003 | Död hund | Svår | Lär sig | 2024-03 |
| D-004 | Sitt | Lätt | Expert | 2020-11 |
| D-004 | Stanna | Lätt | Bra | 2021-01 |
| D-004 | Snurra | Medel | Expert | 2021-06 |
| D-005 | Sitt | Lätt | Lär sig | 2025-02 |
| D-006 | Tass | Medel | Expert | 2015-06 |
| D-006 | Snurra | Medel | Lär sig | 2025-04 |
Nu är ”alla hundar som kan Tass” en enkel fråga. Men lägg märke till vad Hundtrick identifieras av: inte en sak, utan två saker tillsammans, hunden och tricket. Håll fast vid det.
Steg 2: andra normalformen. Andra normalformen spelar bara roll när en rad identifieras av en kombination, och det gör Hundtrick. Så jag frågar om varje kolumn: beskriver den hela kombinationen, eller bara en del av den? Färdighetsnivå beskriver den här hunden som gör det här tricket: Bella är expert på Sitt, Rocky håller fortfarande på att lära sig det. Inlärt, likadant. Men svårighetsgraden? Sitt är lätt oavsett vilken hund som gör det. Den beskriver tricket, bara en del av nyckeln, och det är därför ”Lätt” upprepas på varje Sitt-rad. Så tricket får en egen tabell, och det som blir kvar är paret.
Trick
| Trick-ID | Trick | Svårighetsgrad |
|---|---|---|
| T-01 | Sitt | Lätt |
| T-02 | Stanna | Lätt |
| T-03 | Tass | Medel |
| T-04 | Rulla runt | Svår |
| T-05 | Död hund | Svår |
| T-06 | Snurra | Medel |
Hundtrick (hund-ID + trick-ID)
| Hund-ID | Trick-ID | Färdighetsnivå | Inlärt |
|---|---|---|---|
| D-001 | T-01 | Expert | 2017-11 |
| D-001 | T-02 | Expert | 2018-01 |
| D-001 | T-03 | Bra | 2018-06 |
| D-002 | T-01 | Expert | 2020-02 |
| D-002 | T-04 | Lär sig | 2023-05 |
| D-003 | T-01 | Bra | 2022-06 |
| D-003 | T-05 | Lär sig | 2024-03 |
| D-004 | T-01 | Expert | 2020-11 |
| D-004 | T-02 | Bra | 2021-01 |
| D-004 | T-06 | Expert | 2021-06 |
| D-005 | T-01 | Lär sig | 2025-02 |
| D-006 | T-03 | Expert | 2015-06 |
| D-006 | T-06 | Lär sig | 2025-04 |
Den där Hundtrick-tabellen är den vi hittade i modul 2, och den har ett namn i datamodellering: en koppling (junction), eller som jag kallar den, ett logiskt kopplingsobjekt. En hund kan många trick; ett trick kan många hundar. Kopplingen sitter mellan dem, och den är inga tomma rörledningar: den innehåller de fakta som hör till själva relationen, färdighetsnivån och datumet. Vi möter den igen i modul 6, och i kapitel 3 ser vi att Salesforce använder ”junction object” snävare: ett kopplingsobjekt i Salesforce (Salesforce Junction Object) är ett anpassat objekt med två master-detail-relationer (kapitel 3, modul 7).
Steg 3: tredje normalformen. Nu tillbaka till Hund-tabellen. Allt i den identifieras av hund-ID:t, så andra normalformen har inget att säga. Tredje normalformen ställer en annan fråga: beskriver det här faktumet hunden, eller något annat som hunden hänger ihop med? Rasen är en egen sak: en labrador är en labrador vilken hund det än är, och fakta om den, som storleken, hör till rasen, inte till Bella. Postnumret och orten beskriver ägaren, inte hunden: det är där Ana bor, vilken av hennes hundar vi än tittar på. Uppfödarens uppgifter beskriver uppfödaren. Var och en av dem är ett faktum om ett annat faktum, så var och en flyttar till en egen tabell, och hunden pekar på den med en främmande nyckel:
- Hund: hund-ID, namn, född, ägar-ID, ras-ID, uppfödar-ID
- Ägare: ägar-ID, namn, postnummer, ort
- Ras: ras-ID, ras, storlek
- Uppfödare: uppfödar-ID, namn, ort
- Trick och Hundtrick, från steg 2
Ana lagras en gång nu, och båda hennes hundar pekar på henne. Maple Ridge lagras en gång, och Ras-tabellen ger oss ett hem för fakta om varje ras, som storleken, som kalkylarket inte hade någonstans att lägga. En främmande nyckel kan vara tom: Max har inget uppfödar-ID, och det är ett ärligt svar, inte en lucka. Sedan kastar jag en kuggfråga till rummet: när ägaren fick hunden, var hamnar det datumet? På hunden. En hund har en ägare åt gången i den här modellen, så det datumet beskriver hundens relation till sin ägare.
Du skulle kunna gå ett steg längre och bryta ut orten från postnumret; läroböckerna gör det. I praktiken hålls en adress ihop, och Kansas City ligger dessutom i två delstater, en bra påminnelse om att den verkliga världen inte läser våra läroböcker.
Det är förloppet: ett kalkylark, sedan tre frågor, och varje faktum hamnar på ett ställe. Ta ett steg tillbaka och titta på vad vi byggde. En rörig lista blev sex tabeller, som var och en beskriver en sak, sammankopplade med nycklar:
Ingen behövde ett enda Salesforce-ord för att hänga med. Det är bara hundarna, människorna runt dem och vad de kan.
Nu tillämpar vi det på Steve Trucking
Section titled “Nu tillämpar vi det på Steve Trucking ”Hundarna gör dragen lätta att se. En riktig verksamhet gör dem viktiga, för samma misstag kostar riktiga pengar i stor skala. Så låt oss ta samma tre frågor till Steve Trucking. Tänk dig att företaget håller ordning på sina leveranser så här:
| Leverans | Detaljhandelspartner | Distributionscentral | DC-ort | Team | Lastbil |
|---|---|---|---|---|---|
| 1001 | Keystone | Keystone Phoenix DC | Phoenix | Team 12 | 117 |
| 1002 | Keystone | Keystone Phoenix DC | Phoenix | Team 8 | 122 |
| 1003 | Keystone | Keystone Phoenix DC | Phoenix | Team 12 | 117 |
Vid en första anblick är inget här komplicerat. Men titta på distributionscentralen. Vi upprepar ”Keystone Phoenix DC, Phoenix” på varje leverans som lämnar den: Steve Trucking gör ungefär 3 300 leveranser om dagen från nio DC:er, alltså några hundra om dagen från var och en. Vad händer om den DC:n flyttar? Hur många poster ändrar vi, och vad händer om en missas? Då säger data att DC:n ligger i två orter samtidigt. Det är en uppdateringsanomali. Tänk om vi vill lägga upp en ny DC innan dess första leverans? Tänk om vi raderar den sista leveransen från en DC: raderade vi just det enda ställe där vi lagrade något om den?
Det här är olika symptom på samma problem: vi blandade ihop fakta om olika saker. Fakta om distributionscentralen hör hemma hos distributionscentralen. Fakta om leveransen hör hemma hos leveransen. Fakta om teamet hör hemma hos teamet. Det är normalisering i praktiken.
Första normalformen: göm inte upprepad struktur
Section titled “Första normalformen: göm inte upprepad struktur ”Vi börjar med första normalformen, eller 1NF, där folk ibland gör normalisering svårare än den behöver vara.
Anta att en leverans har ett fält som heter Varor: ”Kylskåp, isbitsmaskinsats, bortforsling.” Vi har lagt tre informationsbitar i ett fält. Det verkar bekvämt, tills någon frågar: ”Hur många bortforslingar gjorde vi förra månaden?” Eller tänk dig fält som heter Vara 1, Vara 2 och Vara 3. Det fungerar, tills leveransen med fyra varor kommer. Problemet är inte att vi valde fel antal Vara-fält. Problemet är att vi inte kände igen den upprepade strukturen. En leverans kan ha flera varor. Det är data vi ska modellera: leveransraden vi hittade i modul 2.
Den praktiska lärdomen av 1NF: göm inte upprepad struktur i fält. Om verksamheten säger att något kan hända många gånger, lyssna. Det kan finnas en annan entitet som försöker ta sig ut.
Du ser det här i riktiga orgar hela tiden. Någon behöver en beskrivning på flera språk, så de skapar ett fält som heter Description_English, sedan Description_French, sedan Description_German. Eller ett godkännande behöver några personer, så vi får Approver 1, Approver 2, Approver 3. När jag hittar det i en granskning blir det en smäll på fingrarna: fixa din datamodell. Ett eller två, kanske, om verksamheten verkligen bara någonsin har ett eller två. Allt utöver det ska vara ett underordnat objekt: en översättning med ett språk, ett godkännandesteg med en godkännare. Nästa språk, eller den fjärde godkännaren, blir en ny post, inte ett nytt fält och en deploy.
Andra normalformen: beskriv hela saken
Section titled “Andra normalformen: beskriv hela saken ”Andra normalformen, eller 2NF, spelar roll när en post identifieras av en kombination av saker. Ta leveransraden. Den har ett eget post-ID, men varje leveransrad är unik genom leverans + produkt. Anta att vi lagrar leveransen, produkten, antalet och produktens beskrivning.
Antalet är vettigt här: det beskriver den här produkten på den här leveransen. Men produktbeskrivningen beskriver inte kombinationen; den beskriver produkten. Lägg den på varje leveransrad, så upprepar vi den varje gång den kylskåpsmodellen åker ut på en annan lastbil. Det är ledtråden till att faktumet hör hemma någon annanstans.
Så 2NF-frågan är: beskriver det här attributet hela den sak jag identifierar, eller bara en del av den? Om det bara beskriver produkten hör det till produkten. Om det beskriver produktens plats på just den här leveransen (antalet, om den installeras) hör det hemma på leveransraden. Många admins kommer aldrig medvetet att säga ”nu tillämpar jag andra normalformen”. Det är helt okej. Jag bryr mig mycket mer om att du lär dig fråga: vad beskriver det här faktumet egentligen?
Tredje normalformen: lagra inte fakta om andra fakta
Section titled “Tredje normalformen: lagra inte fakta om andra fakta ”Nu den jag bryr mig mest om i vardaglig modellering: tredje normalformen, eller 3NF.
Varje distributionscentral har en chef på detaljhandelspartnerns sida, någon som använder partnerportalen. Anta att vi lägger DC-chefens namn direkt på varje leverans. Vad händer när DC:n får en ny chef? Vi uppdaterar varje leverans från den DC:n. Där är lukten igen: vi upprepar ett faktum som hör hemma någon annanstans. Leveransen lämnar från en DC; DC:n har en chef. Det är två relationer, och chefens namn hör hemma hos DC:n.
Den klassiska läroboksversionen är adressen: postnummer, ort och delstat lagrade tillsammans på varje post, när ort och delstat oftast följer av postnumret. Samma form, samma fråga.
Den praktiska 3NF-frågan är: beskriver det här faktumet den här saken, eller något annat som den här saken hänger ihop med? Jag vill att du ställer den hela tiden.
Ta nu ett steg tillbaka, på samma sätt som vi gjorde med hundarna. Leveranstabellen vi började med har blivit fem saker, som var och en har sina egna fakta: leveransraden kom ut vid första normalformen, produkten vid andra, och distributionscentralens ort och chef flyttade till distributionscentralen vid tredje.
Samma tre frågor, samma resultat: varje faktum på ett ställe.
Ett enkelt sätt att tänka på 1NF, 2NF och 3NF
Section titled “Ett enkelt sätt att tänka på 1NF, 2NF och 3NF ”Du kan ägna en hel databaskurs åt normalisering. Det tänker vi inte göra. I den här kursen vill jag att du har en arbetande arkitekts förståelse:
- 1NF: gömmer jag flera värden eller upprepade strukturer i ett fält eller en post?
- 2NF: beskriver det här faktumet hela den sak jag identifierar?
- 3NF: beskriver det här faktumet verkligen den här entiteten, eller något som hänger ihop med den?
Det är inga definitioner för en databaslärobok. Det är frågor jag faktiskt kan använda medan jag designar.
Ja, normaliseringen går längre: Boyce-Codds normalform (BCNF) skärper reglerna kring 3NF för modeller med mer komplicerade nycklar, och det finns fjärde, femte och till och med sjätte normalformen. De hanterar ovanligare sorters upprepning, den sort som kommer från ovanliga nyckelstrukturer mer än från vardagliga affärsposter. Mycket teori, och enligt min erfarenhet inte värt huvudvärken för den sortens system vi bygger på Salesforce. I affärssystem går trycket oftast åt andra hållet: det är mycket troligare att vi backar från tredje normalformen, för användarnas, rapporteringens och prestandans skull, än att vi går förbi den. Det är nästa modul. Känn till att de ytterligare formerna finns, men för det mesta vi gör ger 1NF till 3NF oss de tankeverktyg vi behöver.
Designa för tredje normalformen
Section titled “Designa för tredje normalformen ”Här är min hållning. När jag försöker förstå en verksamhet och designa dess logiska modell vill jag börja rent: leveransfakta hos leveransen, fakta om distributionscentralen hos DC:n, lastbilsfakta hos lastbilen, upprepade begrepp modellerade som begrepp. Jag vill inte ha ett affärsfaktum kopierat över hela modellen bara för att det kanske gör en skärmbild eller en rapport enklare. Inte än.
Men normalisering är ingen religion. Målet är inte den mest akademiskt rena modell som går att bygga. Jag har sett arkitekter bli så fokuserade på renhet att modellen blir plågsam för alla som måste använda den. Vi försöker inte vinna en normaliseringstävling; vi bygger ett system, och det systemet har användare, rapporter, integrationer, prestandabehov, skala och, allt oftare, AI som läser data. De kan vilja ha data i andra former.
Så min utgångspunkt är designa till tredje normalformen där det är möjligt, backa sedan när det behövs: förstå först var varje faktum hör hemma. Sedan, om vi ska bryta mot det, vill jag veta varför. Om svaret är ”för att jag inte visste var jag annars skulle lägga fältet” är det inte tillräckligt bra. Om svaret är ”vi kopierade medvetet det här värdet för att det gör partnerns scorecard enkelt, och vi har ett pålitligt sätt att hålla det synkat”, då för vi ett arkitektursamtal.
Vad en arkitekt bestämmer här
Section titled “Vad en arkitekt bestämmer här ”När jag normaliserar en logisk modell letar jag efter:
- Upprepade värden eller strukturer som bör modelleras separat.
- Attribut som beskriver en annan entitet än den de lagras på.
- Fakta som i onödan dupliceras över många poster, och de beroenden som gör att de blir inkonsekventa.
- Affärsbegrepp som gömmer sig i fält.
- En ren modell som återger sanningen innan några implementationskompromisser görs.
Inte för att varje fysiskt system måste förbli perfekt normaliserat. Tvärtom. I nästa modul bryter vi medvetet mot den rena modellen, för användarnas, rapporteringens, skalans, analysens och AI:ns skull, och vi gör det med full koll på vad vi byter bort.