
डेटा मॉडल ही हड्डियाँ है
28 अन्य भाषाओं में भी उपलब्ध
English · Español · 日本語 · Português (Brasil) · Français · Deutsch · Italiano · 한국어 · 简体中文 · Português (Portugal) · 繁體中文 · Bahasa Indonesia · Türkçe · Polski · Tiếng Việt · ไทย · Nederlands · العربية · עברית · Українська · Русский · Svenska · Dansk · Norsk bokmål · Suomi · Español (México) · Français (Canada) · Deutsch (Schweiz)
मॉड्यूल 2 (कुल 7 में से) — अध्याय डेटा आर्किटेक्ट की तरह सोचना, Data Architect कोर्स का अध्याय 1। हर मॉड्यूल अपने आप में पूरा है। पिछला: आर्किटेक्ट की तरह सोचना · अगला: पलटने की कसौटी
यह मॉड्यूल किस सवाल का जवाब देता है: डेटा मॉडल उस पर बनी किसी भी चीज़ से ज़्यादा मायने क्यों रखता है, और आप उसे कैसे परखते हैं?
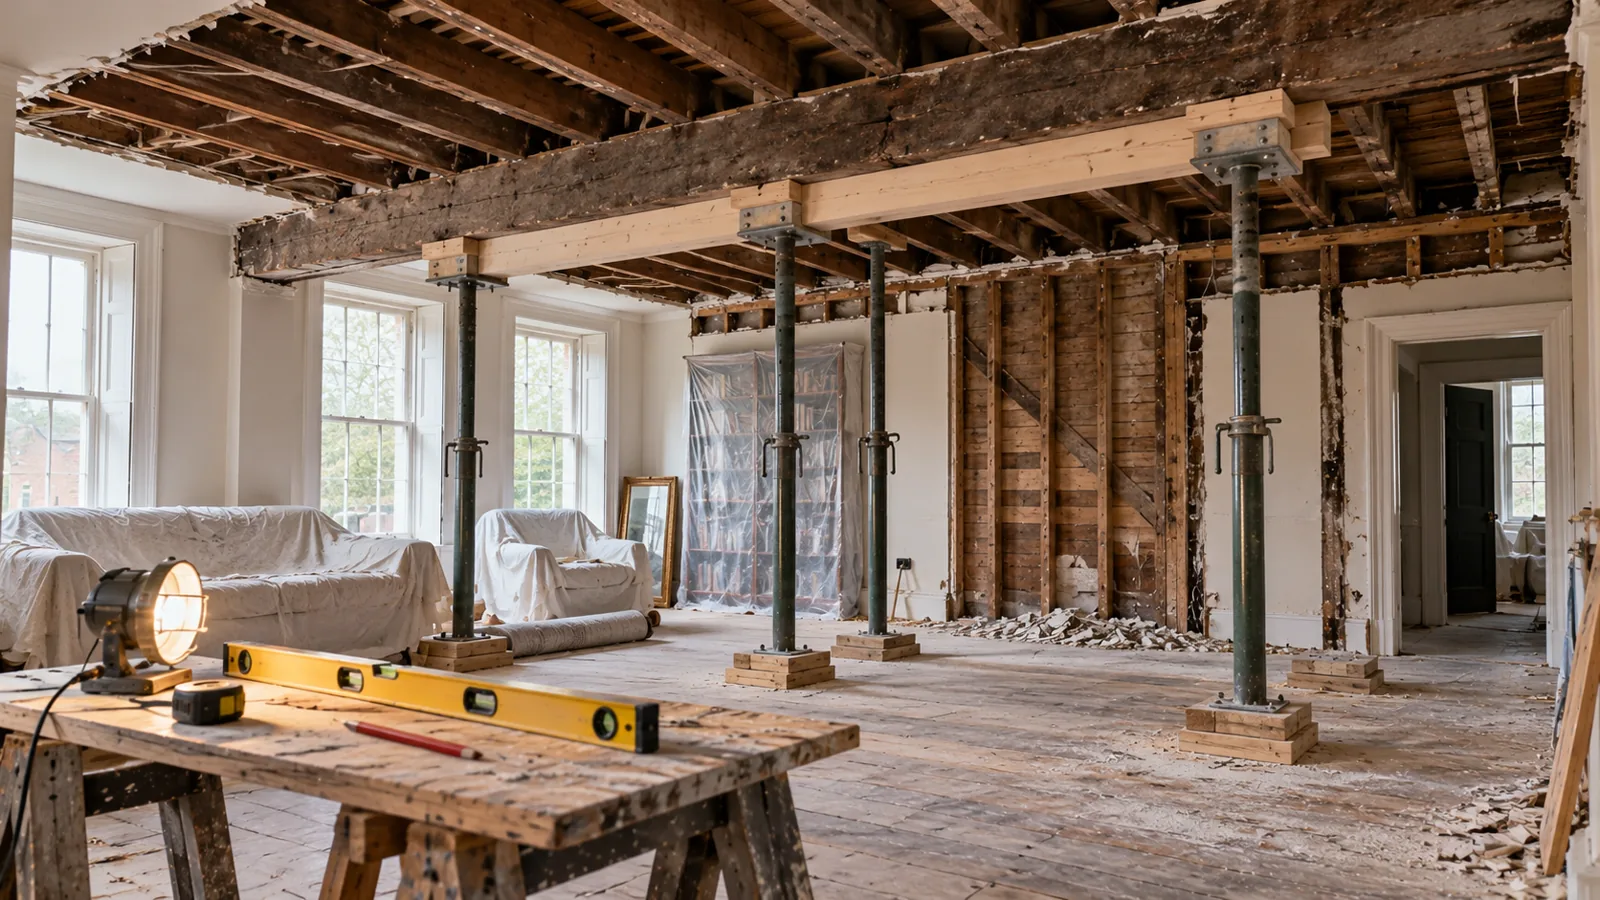
जब मैं डेटा आर्किटेक्चर पढ़ाता हूँ, तो एक वाक्य पर मैं बार-बार लौटता हूँ: डेटा मॉडल ही हड्डियाँ है।
डेटा मॉडल सिस्टम की हड्डियाँ है। बाकी सब कुछ उसके इर्द-गिर्द बनता है, और वही बाकी शरीर को जोड़े रखता है। किसी को देखते समय आपको उसकी हड्डियाँ नहीं दिखतीं, लेकिन वही तय करती हैं कि वह व्यक्ति कितना लंबा खड़ा होता है, कैसे चलता-फिरता है, और कितना वज़न उठा सकता है।
सोचिए कि एक Salesforce इम्प्लीमेंटेशन में हम क्या-क्या बनाते हैं। हम डेटा मॉडल के इर्द-गिर्द ऑटोमेशन बनाते हैं। हम उस पर Apex लिखते हैं, और ऐसे Flows जो उसे पढ़ते और अपडेट करते हैं। हम ऐसे इंटीग्रेशन बनाते हैं जो उसमें डेटा भेजते हैं और उससे डेटा निकालते हैं। हम उस पर रिपोर्ट और एनालिटिक्स बनाते हैं, और उसके इर्द-गिर्द सिक्योरिटी डिज़ाइन करते हैं। और अब तो हम ऐसे AI एजेंट भी बनाते हैं जिन्हें उस डेटा को समझना और उस पर काम करना होता है। यह सब नीचे के ढाँचे पर निर्भर है।
इसीलिए डेटा मॉडल को शुरू में ही सही बनाना इतना मायने रखता है। हड्डियाँ आप बाद में भी बदल सकते हैं। लेकिन शायद दर्द होगा।
बिज़नेस से शुरुआत करें
Section titled “बिज़नेस से शुरुआत करें ”एक अच्छा डेटा मॉडल एक सीधे सवाल से शुरू होता है: बिज़नेस को असल में क्या दर्शाना है? यह नहीं कि “हमारे पास कौन-से Salesforce ऑब्जेक्ट हैं?” और यह तो बिल्कुल नहीं कि “मैं जल्दी से क्या बना सकता हूँ?”
हम पहले बिज़नेस को समझने की कोशिश कर रहे हैं। इस बिज़नेस में अहम चीज़ें कौन-सी हैं? वे आपस में कैसे जुड़ी हैं? उनका मालिक कौन है? समय के साथ वे कैसे बदलती हैं? क्या याद रखना ज़रूरी है, और कौन-सी चीज़ें कई बिज़नेस प्रोसेस में साझा होती हैं? इन बातों को समझने के बाद ही हमें उन्हें ऑब्जेक्ट, फ़ील्ड और संबंधों में बदलना शुरू करना चाहिए।
यह सुनने में ज़ाहिर-सी बात लगती है। व्यवहार में इसे उल्टा कर देना बहुत आसान है। कोई ऐसी चीज़ पहचान लेता है जो Opportunity, Case या Asset जैसी दिखती है और फ़ौरन उसके इर्द-गिर्द डिज़ाइन करने लगता है। कभी-कभी यह बिल्कुल सही होता है। कभी-कभी हम चौकोर खूँटी को गोल छेद में डालने की कोशिश कर रहे होते हैं, और जब उस फ़ैसले के इर्द-गिर्द काफ़ी कुछ बन चुका होता है, तो खूँटी को वापस निकालना बहुत महँगा पड़ता है।
यह सवाल मैं हर समय सुनता हूँ। किसी ग्राहक के बिज़नेस में डिलीवरी की कई लोकेशन हो सकती हैं। क्या हर लोकेशन एक Account होनी चाहिए, या एक कस्टम ऑब्जेक्ट? जवाब देने से पहले देखें कि आपको पहले क्या जानना होगा: इस बिज़नेस के लिए लोकेशन का मतलब क्या है, और उसके साथ क्या होता है। यही ऑब्जेक्ट से पहले बिज़नेस का मॉडल बनाना है। (मेरा जवाब मैं अध्याय 3 में दूँगा।)
सहारा। विकास। प्रदर्शन।
Section titled “सहारा। विकास। प्रदर्शन। ”जब मैं किसी डेटा मॉडल को देखता हूँ, तो चाहता हूँ कि वह तीन कसौटियों पर खरा उतरे: बिज़नेस को सहारा दे, बिज़नेस के साथ बढ़े, और अच्छा प्रदर्शन करे।
सहारा। मॉडल को उस काम में सहारा देना चाहिए जो बिज़नेस असल में करना चाहता है। ऐसे मॉडल में जो तकनीकी रूप से डेटा रख सकता है, और ऐसे मॉडल में जो सच में बिज़नेस को अच्छी तरह दर्शाता है, बड़ा फ़र्क है। अगर मैं लगातार अजीब फ़ील्ड, खास फ़्लैग, पेचीदा ऑटोमेशन और अपवाद जोड़ता जा रहा हूँ क्योंकि मॉडल ठीक से फ़िट नहीं बैठता, तो मैं पूछने लगता हूँ कि क्या समस्या सच में ऑटोमेशन में है। शायद मॉडल ही गलत है। एक अच्छे मॉडल से बिज़नेस को समझना आसान होना चाहिए, मुश्किल नहीं।
विकास। जब मैं बढ़ने की बात करता हूँ, तो मेरा मतलब सिर्फ़ ज़्यादा रिकॉर्ड नहीं होता। वॉल्यूम मायने रखता है: दस हज़ार रिकॉर्ड और सौ मिलियन रिकॉर्ड बिल्कुल अलग समस्याएँ खड़ी करते हैं। लेकिन बिज़नेस जटिलता में भी बढ़ते हैं। वे प्रोडक्ट जोड़ते हैं, नए बाज़ारों में जाते हैं, कंपनियाँ खरीदते हैं, प्रोसेस बदलते हैं, चैनल जोड़ते हैं और नए सिस्टम जोड़ते हैं। उन्हें पता चलता है कि जिसे वे एक चीज़ समझते थे, वह असल में पाँच अलग चीज़ें हैं। जो मॉडल आज के लिए बढ़िया काम करता है, वह जाल बन सकता है अगर उसमें कल के लिए जगह न हो। इसीलिए मैं ऐसे डिज़ाइन पसंद करता हूँ जो कुछ जोड़कर बढ़ते हैं, न कि ऐसे डिज़ाइन जो पहले से मौजूद चीज़ों को बार-बार बदलते रहते हैं। कुछ नया जोड़ना आम तौर पर उस चीज़ को नए सिरे से परिभाषित करने से आसान होता है जिस पर दर्जनों दूसरी चीज़ें निर्भर हैं।
प्रदर्शन। डेटा बस पड़ा नहीं रहता। हम उसे लिखते हैं, ढूँढ़ते हैं, क्वेरी करते हैं, शेयर करते हैं, उस पर रिपोर्ट बनाते हैं और उसे इंटीग्रेट करते हैं, और अब AI सिस्टम भी कोई काम करने से पहले उसे संदर्भ के रूप में निकालते हैं। कोई मॉडल डायग्राम पर खूबसूरत दिख सकता है और फिर भी चलाने में बेहद खराब हो सकता है। इसलिए हम दोनों के लिए डिज़ाइन करते हैं: डेटा कैसे रखा जाता है, और डेटा का इस्तेमाल कैसे होगा।
और उसे अच्छा प्रदर्शन करते रहना होगा। उसे बड़े पैमाने पर प्रदर्शन करना होगा: जब यूज़र्स की संख्या बढ़े, जब डेटा का वॉल्यूम बढ़े, असल दुनिया की परिस्थितियों में और पीक पर, साल के औसत दिन पर नहीं बल्कि सबसे व्यस्त दिन पर। और जब कुछ अनपेक्षित हो, तब भी उसे प्रदर्शन करते रहना होगा।
सहारा। विकास। प्रदर्शन। इस पूरे कोर्स में हम इन तीन कसौटियों पर बार-बार लौटेंगे।
बहुत सपाट, बहुत पेचीदा, या बस गलत
Section titled “बहुत सपाट, बहुत पेचीदा, या बस गलत ”मैंने डेटा मॉडल को तीन तरह से गलत होते देखा है।
पहला है शुरुआत में ही गलत चीज़ चुन लेना। हम कोई स्टैंडर्ड ऑब्जेक्ट इसलिए इस्तेमाल कर लेते हैं क्योंकि वह काफ़ी करीब दिखता है, फिर बरसों अपवाद जोड़ते रहते हैं क्योंकि वह कभी सही फ़िट था ही नहीं। यही चौकोर खूँटी है।
दूसरा है मॉडल को बहुत सपाट बना देना। सब कुछ एक ही ऑब्जेक्ट में चला जाता है, और शुरू में यह कमाल का सरल लगता है। फिर बिज़नेस बढ़ता है, और हमें पता चलता है कि उनमें से कुछ चीज़ों का अपना लाइफ़साइकल है, उनके कई इंस्टेंस हो सकते हैं, उन्हें अपनी सिक्योरिटी चाहिए, या उनके अपने संबंध हैं। अचानक हम एक one-to-many संबंध को Field 1, Field 2 और Field 3 से दर्शा रहे होते हैं, या लगातार पेचीदा होते फ़्लैग और ऑटोमेशन से। मॉडल ने हमें बढ़ने की कोई जगह ही नहीं छोड़ी।
तीसरा इसकी उल्टी गलती है: हम ज़रूरत से ज़्यादा नॉर्मलाइज़ कर देते हैं। हम एक सुंदर डायग्राम बनाते हैं जिसमें एक के बाद एक ऑब्जेक्ट है, हर कॉन्सेप्ट पूरी तरह अलग। तकनीकी रूप से खूबसूरत, व्यवहार में तकलीफ़देह। यूज़र्स को इसे समझने में मुश्किल होती है, और पेज लेआउट और Lightning पेज, एक के बाद एक related list के साथ, अंतहीन गहरे लगने लगते हैं। क्वेरी पेचीदा हो जाती हैं, ऑटोमेशन ज़्यादा संबंधों को पार करता है, रिपोर्टिंग मुश्किल हो जाती है, और प्लेटफ़ॉर्म को आम बिज़नेस सवालों के जवाब देने के लिए ज़्यादा काम करना पड़ता है।
तो सही क्या है, सपाट या नॉर्मलाइज़्ड? इसका कोई फ़ॉर्मूला नहीं है। आप अपने दिमाग में आदर्श मॉडल की एक तस्वीर रखते हैं और उससे दूर जाते हुए ट्रेड-ऑफ़ को समझते हैं। यही आर्किटेक्चर की कला है, और हम इस पर मॉड्यूल 4 में और अगले अध्याय में लौटेंगे, जहाँ हम मॉडल बनाना सीखेंगे। अभी के लिए इतना पहचान लें कि ढाँचा खुद एक आर्किटेक्चरल फ़ैसला है।
हड्डियाँ बदलने में सावधान रहें
Section titled “हड्डियाँ बदलने में सावधान रहें ”एक बार सिस्टम चल पड़े, तो मैं डेटा मॉडल में बुनियादी बदलावों को लेकर बहुत सतर्क हो जाता हूँ।
मान लीजिए एक टेक्स्ट फ़ील्ड बरसों से मौजूद है, और कोई कहता है, “अब हम इसे उस तरह इस्तेमाल नहीं करते। चलो इसे नंबर में बदल देते हैं।” यह एक फ़ील्ड का बदलाव लगता है। लेकिन उस फ़ील्ड पर क्या-क्या निर्भर है? Flows, Apex, रिपोर्ट, इंटीग्रेशन, डेटा पाइपलाइन, बाहरी एप्लिकेशन, AI एजेंट। और पुराने डेटा का क्या होगा? जब तक कोड या flows किसी फ़ील्ड को रेफ़र करते हैं, प्लेटफ़ॉर्म खुद आपको उसका टाइप बदलने नहीं देता, और इसी से पता चलता है कि यह बदलाव कहाँ तक पहुँचता है।
कभी-कभी सही जवाब यह होता है कि जो पहले से मौजूद है उसे बदला ही न जाए। बदलाव कितना गंभीर है, उसके हिसाब से मैं कुछ नया बनाना, सोच-समझकर माइग्रेट करना, और पुराने ढाँचे को डिप्रिकेट करना बेहतर समझूँगा:
बदलने के बजाय जोड़ें। चौंकाने के बजाय डिप्रिकेट करें।
Salesforce आपको मेटाडेटा में यह कहने का तरीका भी देता है: किसी फ़ील्ड का Field Usage DeprecateCandidate पर सेट किया जा सकता है, यानी “डिप्रिकेशन के लिए नियोजित और अब इस्तेमाल में नहीं।” इससे ऑब्जेक्ट को पढ़ने वाले हर व्यक्ति के लिए फ़ील्ड पर निशान लग जाता है; यह फ़ील्ड को छिपाता नहीं, इसलिए उसे रिटायर करना फिर भी एक फ़ैसला है जिसे आपको खुद लागू करना होता है।
क्योंकि जब आर्किटेक्चर के दूसरे हिस्से किसी चीज़ पर निर्भर हो जाते हैं, तो उसका मतलब बदलना उसका नाम बदलने से कहीं ज़्यादा खतरनाक हो सकता है। सबसे बुरा रूप वह फ़ील्ड है जिसका नाम वही रहता है पर अंदर की सामग्री बदल जाती है: आगे की हर चीज़ अब भी उस नाम पर भरोसा करती है।
किसी फ़ील्ड पर Required (अनिवार्य) बॉक्स टिक करने जैसी सीधी-सी बात भी टाइम बम बन सकती है। अगर आप पहले से डेटा इकट्ठा कर चुके हैं, तो कुछ रिकॉर्ड में वह फ़ील्ड भरी नहीं होगी। फिर कुछ दिन, हफ़्ते या महीने बाद, कोई उनमें से किसी रिकॉर्ड को अपडेट करता है, और अनिवार्य फ़ील्ड की वजह से सेव फ़ेल हो जाता है, और वह वैल्यू किसी के पास नहीं होती। किसी फ़ील्ड को अनिवार्य बनाने जैसे सीधे बदलाव के अनचाहे और देर से सामने आने वाले नतीजे हो सकते हैं। Required पर, और यह कि कोई वैल्यू असल में कब पता होती है, हम अध्याय 3 में लौटेंगे।
परीक्षा से आगे: AI भी हड्डियों पर ही बनाता है। किसी AI टूल से एप्लिकेशन बनाने को कहें, और वह मिनटों में ऑब्जेक्ट, फ़ील्ड, Flows, Apex, कंपोनेंट और टेस्ट बना देगा। अगर मूल डेटा मॉडल गलत था, तो हमने बुरे फ़ैसले के नतीजों से बचाव नहीं किया; हमने उन्हें और तेज़ कर दिया है, क्योंकि बनी हुई हर परत उस ढाँचे पर निर्भर एक और चीज़ है। इसीलिए मैं चाहता हूँ कि AI से बने डेटा मॉडल की समीक्षा एक इंसानी आर्किटेक्ट करे, उसे समझे और उसकी ज़िम्मेदारी ले। मॉड्यूल 7 इसे और आगे ले जाता है।
हड्डियाँ सबसे पहले
Section titled “हड्डियाँ सबसे पहले ”इस कोर्स में आगे बढ़ते हुए हम बहुत सारी टेक्नोलॉजी की बात करेंगे: ऑब्जेक्ट और संबंध, बड़े डेटा वॉल्यूम, क्वेरी, इंटीग्रेशन, माइग्रेशन, ट्रांज़ैक्शन, सिक्योरिटी, Data 360 और AI। इन सबके नीचे डेटा मॉडल है।
अगर मॉडल बिज़नेस को सहारा देता है, बिज़नेस के साथ बढ़ सकता है, और डेटा के जिन तरीकों से हम इस्तेमाल करने वाले हैं उनके लिए अच्छा प्रदर्शन करता है, तो हमने एक मज़बूत नींव बना ली है। अगर नींव गलत हो गई, तो उसके बाद सब कुछ मुश्किल हो जाता है।
डेटा मॉडल ही हड्डियाँ है। हड्डियाँ डिज़ाइन करते समय आर्किटेक्ट्स को बहुत सावधान रहना चाहिए। मौजूदा ढाँचों में बदलाव के नतीजे एक के बाद एक फैलते जा सकते हैं।
आर्किटेक्ट यहाँ क्या तय करता है
Section titled “आर्किटेक्ट यहाँ क्या तय करता है ”- क्या मॉडल बिज़नेस को सहारा देता है, उसके साथ बढ़ सकता है, और डेटा के इस्तेमाल के तरीकों के लिए अच्छा प्रदर्शन करता है।
- कोई कॉन्सेप्ट किसी स्टैंडर्ड ऑब्जेक्ट में फ़िट बैठता है या वह चौकोर खूँटी है।
- मॉडल को कितना सपाट या कितना नॉर्मलाइज़्ड बनाना है, और क्यों।
- हड्डियों में कोई बदलाव जगह पर ही किया जाए, या उसकी जगह कुछ जोड़ा जाए, माइग्रेट किया जाए या डिप्रिकेट किया जाए।
और जानें
Section titled “और जानें ”- Considerations for Converting the Field Type of a Custom Field (opens in a new tab), Salesforce Help (अंग्रेज़ी में, 2026-10-02 को जाँचा गया; 2026-10-12 को दोबारा जाँचा गया): टाइप के कौन-से बदलाव डेटा मिटा सकते हैं, और आप उस फ़ील्ड का टाइप क्यों नहीं बदल सकते जिसे Apex, flows या processes रेफ़र करते हैं।
- Data Classification Metadata Fields (opens in a new tab), Salesforce Help (अंग्रेज़ी में, 2026-10-02 को जाँचा गया; 2026-10-12 को दोबारा जाँचा गया): Field Usage की वैल्यू (Active, DeprecateCandidate, Hidden), और बाकी क्लासिफ़िकेशन फ़ील्ड।