
El modelo de datos es el esqueleto
También en 28 idiomas
English · Español · 日本語 · Português (Brasil) · Français · Deutsch · Italiano · 한국어 · 简体中文 · Português (Portugal) · 繁體中文 · Bahasa Indonesia · Türkçe · Polski · Tiếng Việt · ไทย · Nederlands · العربية · עברית · Українська · हिन्दी · Русский · Svenska · Dansk · Norsk bokmål · Suomi · Français (Canada) · Deutsch (Schweiz)
Módulo 2 de 7 del capítulo Pensar como un arquitecto de datos, el primer capítulo del curso Data Architect. Cada módulo se sostiene por sí solo. Anterior: Pensar como un arquitecto · Siguiente: La Prueba de Reversibilidad
La pregunta que responde este módulo: ¿Por qué el modelo de datos importa más que cualquier cosa construida sobre él, y cómo se juzga uno?
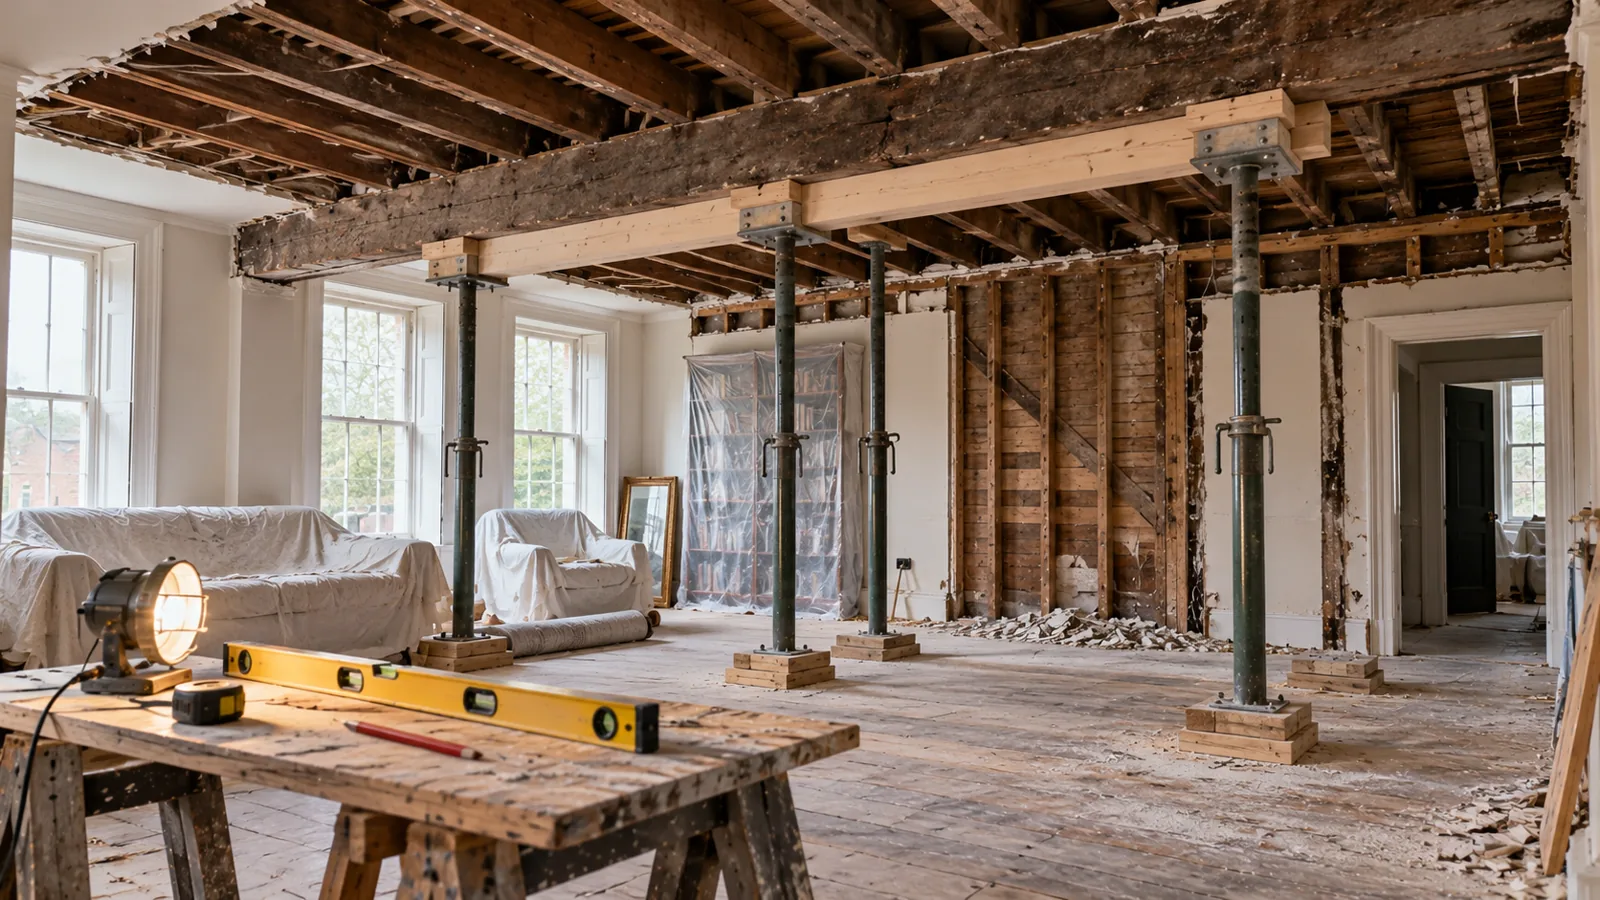
Cuando enseño arquitectura de datos, hay una frase a la que vuelvo una y otra vez: el modelo de datos es el esqueleto.
El modelo de datos es el esqueleto del sistema. Todo lo demás se construye a su alrededor, y es lo que mantiene unido el resto del cuerpo. Cuando miras a alguien no ves sus huesos, pero ellos deciden qué tan alto se para esa persona, cómo se mueve y cuánto puede cargar.
Piensa en todo lo que construimos en una implementación de Salesforce. Construimos automatización alrededor del modelo de datos. Escribimos Apex contra él, y Flows que lo leen y lo actualizan. Construimos integraciones que meten datos en él y los sacan. Creamos informes y analítica sobre él, y diseñamos la seguridad a su alrededor. Y, cada vez más, construimos agentes de IA que necesitan entender esos datos y actuar sobre ellos. Todo depende de la estructura que hay debajo.
Por eso importa tanto acertar pronto con el modelo de datos. Puedes cambiar el esqueleto más adelante. Pero probablemente va a doler.
Empieza por el negocio
Sección titulada «Empieza por el negocio »Un buen modelo de datos empieza con una pregunta sencilla: ¿qué necesita representar realmente el negocio? No “¿qué objetos de Salesforce tenemos?”. Y definitivamente no “¿qué puedo construir rápido?”.
Intentamos entender primero el negocio. ¿Cuáles son las cosas importantes en este negocio? ¿Cómo se relacionan? ¿Quién es su dueño? ¿Cómo cambian con el tiempo? ¿Qué hay que recordar y qué se comparte entre procesos de negocio? Solo después de entender esas cosas deberíamos empezar a traducirlas en objetos, campos y relaciones.
Suena obvio. En la práctica, es muy fácil hacerlo al revés. Alguien reconoce algo que parece una oportunidad, un caso o un activo e inmediatamente empieza a diseñar a su alrededor. A veces eso es exactamente lo correcto. A veces estamos intentando meter una clavija cuadrada en un agujero redondo, y una vez que se ha construido lo suficiente alrededor de esa decisión, sacar la clavija se vuelve muy costoso.
Esta es una pregunta que escucho todo el tiempo. El negocio de un cliente puede tener muchos lugares de entrega. ¿Cada lugar debería ser una cuenta o un objeto personalizado? Antes de responder, fíjate en lo que necesitarías saber primero: qué significa un lugar para este negocio y qué le pasa. Eso es modelar el negocio antes que los objetos. (Te daré mi respuesta en el capítulo 3.)
Sostener. Crecer. Rendir.
Sección titulada «Sostener. Crecer. Rendir. »Cuando miro un modelo de datos, quiero que pase tres pruebas: sostener el negocio, crecer con el negocio y rendir.
Sostener. El modelo tiene que sostener lo que el negocio intenta lograr de verdad. Hay una gran diferencia entre un modelo que técnicamente puede guardar los datos y uno que realmente representa bien el negocio. Si estoy agregando constantemente campos extraños, indicadores especiales, automatización complicada y excepciones porque el modelo no termina de encajar, empiezo a preguntarme si el problema es de verdad la automatización. Quizá el modelo esté mal. Un buen modelo debería hacer el negocio más fácil de entender, no más difícil.
Crecer. Cuando digo crecer, no me refiero solo a más registros. El volumen importa: diez mil registros y cien millones crean problemas muy distintos. Pero los negocios también crecen en complejidad. Agregan productos, entran en nuevos mercados, adquieren empresas, cambian procesos, suman canales y conectan sistemas nuevos. Descubren que algo que creían que era una sola cosa en realidad son cinco cosas distintas. Un modelo que funciona de maravilla para hoy puede volverse una trampa si no deja espacio para mañana. Por eso prefiero diseños que crecen por adición en lugar de diseños que cambian una y otra vez lo que ya existe. Agregar algo nuevo suele ser más fácil que redefinir algo de lo que dependen decenas de otras cosas.
Rendir. Los datos no se quedan quietos. Los escribimos, los buscamos, los consultamos, los compartimos, informamos sobre ellos y los integramos, y cada vez más los sistemas de IA los recuperan como contexto antes de actuar. Un modelo puede verse precioso en un diagrama y aun así ser terrible de operar. Así que diseñamos tanto para cómo se guardan los datos como para cómo se van a usar.
Y tiene que seguir rindiendo. Tiene que rendir a escala: cuando aumenta el número de usuarios, cuando aumenta el volumen de datos, en condiciones reales y en los picos, el día de más actividad del año y no el día promedio. Y tiene que seguir rindiendo cuando pasa algo inesperado.
Sostener. Crecer. Rendir. Volveremos a esas tres pruebas a lo largo de todo el curso.
Demasiado plano, demasiado complicado o simplemente equivocado
Sección titulada «Demasiado plano, demasiado complicado o simplemente equivocado »He visto modelos de datos salir mal de tres maneras.
La primera es elegir lo equivocado desde el principio. Usamos un objeto estándar porque parece lo bastante parecido y luego pasamos años agregando excepciones porque nunca fue el ajuste correcto. Esa es la clavija cuadrada.
La segunda es hacer el modelo demasiado plano. Todo va a un solo objeto y, al principio, parece maravillosamente simple. Luego el negocio crece y descubrimos que algunas de esas cosas tienen su propio ciclo de vida, pueden tener varias instancias, necesitan su propia seguridad o tienen sus propias relaciones. De pronto estamos representando una relación de uno a muchos con Campo 1, Campo 2 y Campo 3, o con indicadores y automatización cada vez más complicados. El modelo no nos dejó ningún lugar para crecer.
La tercera es el error contrario: normalizamos de más. Creamos un diagrama elegante con objeto tras objeto, cada concepto perfectamente separado. Técnicamente precioso, en la práctica un suplicio. A los usuarios les cuesta entenderlo, y los formatos de página y las páginas Lightning, con lista relacionada tras lista relacionada, pueden empezar a parecer interminablemente profundos. Las consultas se complican, la automatización cruza más relaciones, los informes se vuelven más difíciles y la plataforma trabaja más para responder preguntas de negocio corrientes.
Entonces, ¿qué es lo correcto, plano o normalizado? No hay una fórmula. Tienes en la cabeza una imagen del modelo óptimo y entiendes las compensaciones a medida que te alejas de él. Ese es el arte de la arquitectura, y volveremos a él en el módulo 4 y en el próximo capítulo, donde aprendemos a modelar. Por ahora, reconoce que la estructura en sí es una decisión de arquitectura.
Cuidado con cambiar el esqueleto
Sección titulada «Cuidado con cambiar el esqueleto »Una vez que un sistema está en marcha, me vuelvo muy cauteloso con los cambios fundamentales en el modelo de datos.
Supón que un campo de texto existe desde hace años y alguien dice: “En realidad ya no lo usamos así. Cambiémoslo a número”. Suena a un cambio de campo. Pero ¿qué depende de ese campo? Flows, Apex, informes, integraciones, canalizaciones de datos, aplicaciones externas, agentes de IA. ¿Y qué pasa con los datos históricos? La propia plataforma no te deja cambiar el tipo de un campo mientras el código o los flujos todavía hacen referencia a él, lo que te dice hasta dónde llega el cambio.
A veces la respuesta correcta no es mutar lo que ya existe. Según lo grave que sea el cambio, prefiero crear algo nuevo, migrar de forma deliberada y dejar obsoleta la estructura antigua:
Agrega en lugar de mutar. Deja obsoleto en lugar de sorprender.
Salesforce incluso te da una forma de decirlo en los metadatos: el Field Usage (uso del campo) de un campo se puede establecer en DeprecateCandidate, “previsto para quedar obsoleto y ya no se usa”. Eso marca el campo para todos los que leen el objeto; no oculta el campo, así que retirarlo sigue siendo una decisión que tienes que ejecutar.
Porque, una vez que otras partes de la arquitectura dependen de algo, cambiar su significado puede ser mucho más peligroso que cambiar su nombre. La peor versión es el campo cuyo nombre sigue igual mientras su contenido cambia: todo lo que viene después sigue confiando en el nombre.
Incluso algo tan simple como marcar la casilla Obligatorio en un campo puede convertirse en una bomba de tiempo. Si ya recopilaste datos, algunos registros no tendrán ese campo completado. Luego, días, semanas o meses después, alguien actualiza uno de esos registros y el guardado falla por el campo obligatorio, y nadie tiene ese valor. Un cambio simple como marcar un campo como obligatorio puede tener consecuencias imprevistas y tardías. Volveremos a Obligatorio, y a cuándo se conoce realmente un valor, en el capítulo 3.
Más allá del examen: la IA también construye sobre el esqueleto. Pídele a una herramienta de IA que construya una aplicación y generará los objetos, campos, Flows, Apex, componentes y pruebas en minutos. Si el modelo de datos original estaba mal, no hemos evitado las consecuencias de una mala decisión; las hemos acelerado, porque cada capa generada es una cosa más que depende de esa estructura. Por eso quiero que un arquitecto humano revise el modelo de datos generado por IA, lo entienda y responda por él. El módulo 7 lleva esto más lejos.
El esqueleto va primero
Sección titulada «El esqueleto va primero »A lo largo de este curso hablaremos de mucha tecnología: objetos y relaciones, grandes volúmenes de datos, consultas, integración, migración, transacciones, seguridad, Data 360 e IA. Debajo de todo eso está el modelo de datos.
Si el modelo sostiene el negocio, puede crecer con él y rinde para las formas en que vamos a usar los datos, hemos construido una base sólida. Si nos equivocamos con la base, todo lo que viene después se vuelve más difícil.
El modelo de datos es el esqueleto. Los arquitectos deberían tener mucho cuidado cuando diseñan el esqueleto. Hacer cambios en estructuras existentes puede tener consecuencias en cascada.
Lo que decide aquí un arquitecto
Sección titulada «Lo que decide aquí un arquitecto »- Si el modelo sostiene el negocio, puede crecer con él y rinde para las formas en que se usarán los datos.
- Si un concepto encaja en un objeto estándar o es una clavija cuadrada.
- Qué tan plano o qué tan normalizado hacer el modelo, y por qué.
- Si un cambio en el esqueleto debería ser una adición, una migración o una obsolescencia, en lugar de un cambio en el mismo lugar.
Explora
Sección titulada «Explora »- Considerations for Converting the Field Type of a Custom Field (opens in a new tab), Ayuda de Salesforce (en inglés, consultado el 2026-10-02; verificado de nuevo el 2026-10-12): qué cambios de tipo pueden perder datos, y por qué no puedes cambiar el tipo de un campo al que hacen referencia Apex, flujos o procesos.
- Data Classification Metadata Fields (opens in a new tab), Ayuda de Salesforce (en inglés, consultado el 2026-10-02; verificado de nuevo el 2026-10-12): los valores de Field Usage (Active, DeprecateCandidate, Hidden) y los demás campos de clasificación.