
Das Datenmodell ist das Skelett
Auch in 28 Sprachen
English · Español · 日本語 · Português (Brasil) · Français · Italiano · 한국어 · 简体中文 · Português (Portugal) · 繁體中文 · Bahasa Indonesia · Türkçe · Polski · Tiếng Việt · ไทย · Nederlands · العربية · עברית · Українська · हिन्दी · Русский · Svenska · Dansk · Norsk bokmål · Suomi · Español (México) · Français (Canada) · Deutsch (Schweiz)
Modul 2 von 7 im Kapitel Denken wie Datenarchitekt:innen, dem ersten Kapitel des Kurses Data Architect. Jedes Modul steht für sich. Zurück: Denken wie Architekt:innen · Weiter: Der Umkehrbarkeitstest
Die Frage, die dieses Modul beantwortet: Warum ist das Datenmodell wichtiger als alles, was darauf gebaut wird, und wie beurteilt man eines?
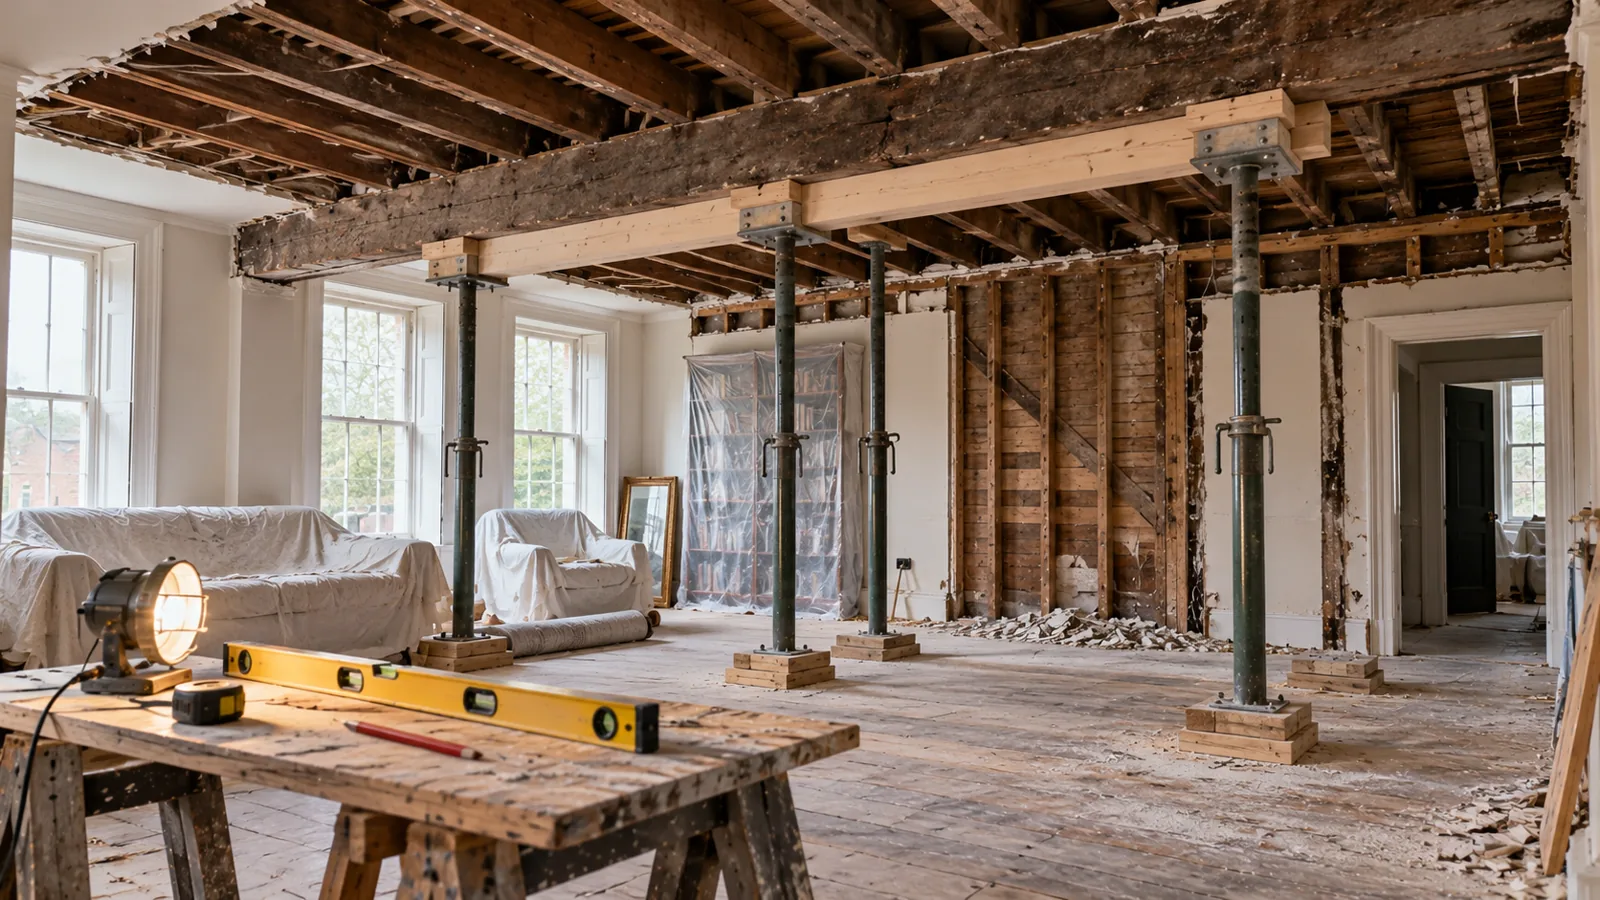
Wenn ich Datenarchitektur unterrichte, komme ich immer wieder auf einen Satz zurück: Das Datenmodell ist das Skelett.
Das Datenmodell ist das Skelett des Systems. Alles andere wird darum herum gebaut, und es hält den Rest des Körpers zusammen. Wenn Sie jemanden ansehen, sehen Sie die Knochen nicht, aber sie bestimmen, wie groß diese Person ist, wie sie sich bewegt und was sie tragen kann.
Denken Sie an alles, was wir in einer Salesforce-Implementierung bauen. Wir bauen Automatisierung um das Datenmodell herum. Wir schreiben Apex dagegen und Flows, die es lesen und aktualisieren. Wir bauen Integrationen, die Daten hineinschicken und herausholen. Wir erstellen Berichte und Analysen darauf, und wir entwerfen die Sicherheit darum herum. Und zunehmend bauen wir KI-Agenten, die diese Daten verstehen und danach handeln müssen. All das hängt von der Struktur darunter ab.
Deshalb ist es so wichtig, das Datenmodell früh richtig hinzubekommen. Sie können das Skelett später ändern. Aber es wird wahrscheinlich wehtun.
Beginnen Sie mit dem Geschäft
Abschnitt betitelt „Beginnen Sie mit dem Geschäft “Ein gutes Datenmodell beginnt mit einer einfachen Frage: Was muss das Geschäft eigentlich abbilden? Nicht: „Welche Salesforce-Objekte haben wir?“ Und schon gar nicht: „Was kann ich schnell bauen?“
Wir versuchen zuerst, das Geschäft zu verstehen. Was sind die wichtigen Dinge in diesem Geschäft? Wie hängen sie zusammen? Wem gehören sie? Wie verändern sie sich im Lauf der Zeit? Was muss festgehalten werden, und was wird über Geschäftsprozesse hinweg geteilt? Erst wenn wir das verstanden haben, sollten wir beginnen, es in Objekte, Felder und Beziehungen zu übersetzen.
Das klingt selbstverständlich. In der Praxis gerät es sehr leicht in die falsche Reihenfolge. Jemand erkennt etwas, das wie eine Opportunity, ein Kundenvorgang oder ein Asset aussieht, und fängt sofort an, darum herum zu entwerfen. Manchmal ist das genau richtig. Manchmal versuchen wir, einen eckigen Pflock in ein rundes Loch zu stecken, und sobald genug um diese Entscheidung herum gebaut ist, wird es sehr teuer, den Pflock wieder herauszuziehen.
Hier ist eine Frage, die ich ständig höre. Das Unternehmen eines Kunden kann viele Lieferorte haben. Sollte jeder Ort ein Account sein oder ein benutzerdefiniertes Objekt? Bevor Sie antworten, beachten Sie, was Sie zuerst wissen müssten: was ein Ort für dieses Geschäft bedeutet und was mit ihm geschieht. Das heißt, das Geschäft vor den Objekten zu modellieren. (Meine Antwort gebe ich Ihnen in Kapitel 3.)
Tragen. Wachsen. Leisten.
Abschnitt betitelt „Tragen. Wachsen. Leisten. “Wenn ich mir ein Datenmodell ansehe, soll es drei Prüfungen bestehen: das Geschäft tragen, mit dem Geschäft wachsen und Leistung bringen.
Tragen. Das Modell muss tragen, was das Geschäft tatsächlich erreichen will. Es ist ein großer Unterschied, ob ein Modell die Daten technisch speichern kann oder ob es das Geschäft wirklich gut abbildet. Wenn ich ständig seltsame Felder, besondere Kennzeichen, komplizierte Automatisierung und Ausnahmen hinzufüge, weil das Modell nicht ganz passt, frage ich mich irgendwann, ob das Problem wirklich die Automatisierung ist. Vielleicht ist das Modell falsch. Ein gutes Modell sollte das Geschäft leichter verständlich machen, nicht schwerer.
Wachsen. Mit Wachsen meine ich nicht nur mehr Datensätze. Das Volumen zählt: Zehntausend Datensätze und hundert Millionen verursachen sehr unterschiedliche Probleme. Aber Unternehmen wachsen auch an Komplexität. Sie fügen Produkte hinzu, erschließen neue Märkte, kaufen Firmen, ändern Prozesse, ergänzen Kanäle und binden neue Systeme an. Sie stellen fest, dass etwas, das sie für eine Sache hielten, eigentlich fünf verschiedene Dinge sind. Ein Modell, das für heute wunderbar funktioniert, kann zur Falle werden, wenn es keinen Platz für morgen gibt. Deshalb bevorzuge ich Entwürfe, die durch Hinzufügen wachsen, statt solche, die ständig verändern, was schon existiert. Etwas Neues hinzuzufügen ist meist einfacher, als etwas neu zu definieren, von dem Dutzende andere Dinge abhängen.
Leisten. Daten liegen nicht einfach herum. Wir schreiben sie, suchen sie, fragen sie ab, geben sie frei, berichten darüber und integrieren sie, und zunehmend rufen KI-Systeme sie als Kontext ab, bevor sie handeln. Ein Modell kann auf einem Diagramm wunderschön aussehen und sich trotzdem schrecklich betreiben lassen. Also entwerfen wir für beides: wie die Daten gespeichert werden und wie die Daten genutzt werden.
Und es muss dauerhaft Leistung bringen. Es muss im großen Maßstab funktionieren: wenn die Zahl der Benutzer steigt, wenn das Datenvolumen steigt, unter realen Bedingungen und in Spitzenzeiten, am geschäftigsten Tag des Jahres statt an einem durchschnittlichen. Und es muss weiter funktionieren, wenn etwas Unerwartetes passiert.
Tragen. Wachsen. Leisten. Auf diese drei Prüfungen kommen wir in diesem Kurs immer wieder zurück.
Zu flach, zu kompliziert oder einfach falsch
Abschnitt betitelt „Zu flach, zu kompliziert oder einfach falsch “Ich habe Datenmodelle auf drei Arten scheitern sehen.
Die erste ist, von Anfang an das Falsche zu wählen. Wir verwenden ein Standardobjekt, weil es nah genug aussieht, und fügen dann jahrelang Ausnahmen hinzu, weil es nie wirklich gepasst hat. Das ist der eckige Pflock.
Die zweite ist, das Modell zu flach zu machen. Alles kommt in ein Objekt, und anfangs wirkt das herrlich einfach. Dann wächst das Geschäft, und wir stellen fest, dass manche dieser Dinge einen eigenen Lebenszyklus haben, mehrfach vorkommen können, eigene Sicherheit brauchen oder eigene Beziehungen haben. Plötzlich bilden wir eine Eins-zu-viele-Beziehung mit Feld 1, Feld 2 und Feld 3 ab oder mit immer komplizierteren Kennzeichen und Automatisierungen. Das Modell hat uns keinen Raum zum Wachsen gelassen.
Die dritte ist der umgekehrte Fehler: Wir übernormalisieren. Wir erstellen ein elegantes Diagramm mit Objekt um Objekt, jedes Konzept sauber getrennt. Technisch schön, praktisch elend. Die Benutzer tun sich schwer, es zu verstehen, und die Seitenlayouts und Lightning-Seiten mit einer Themenliste nach der anderen wirken irgendwann endlos tief. Abfragen werden komplizierter, Automatisierung überquert mehr Beziehungen, Berichte werden schwieriger, und die Plattform leistet mehr Arbeit, um gewöhnliche Geschäftsfragen zu beantworten.
Was ist also richtig, flach oder normalisiert? Es gibt keine Formel. Sie haben ein Bild des optimalen Modells im Kopf und verstehen die Abwägungen, wenn Sie davon abweichen. Das ist die Kunst der Architektur, und wir kommen in Modul 4 und im nächsten Kapitel darauf zurück, wo wir das Modellieren lernen. Für jetzt erkennen Sie: Die Struktur selbst ist eine Architekturentscheidung.
Vorsicht beim Ändern des Skeletts
Abschnitt betitelt „Vorsicht beim Ändern des Skeletts “Sobald ein System läuft, werde ich bei grundlegenden Änderungen am Datenmodell sehr vorsichtig.
Angenommen, ein Textfeld existiert seit Jahren, und jemand sagt: „Wir nutzen es gar nicht mehr so. Machen wir eine Zahl daraus.“ Das klingt nach einer Feldänderung. Aber was hängt von diesem Feld ab? Flows, Apex, Berichte, Integrationen, Datenpipelines, externe Anwendungen, KI-Agenten. Und was passiert mit den historischen Daten? Die Plattform selbst lässt Sie den Typ eines Felds nicht ändern, solange Code oder Flows noch darauf verweisen, und das zeigt Ihnen, wie weit die Änderung reicht.
Manchmal ist die richtige Antwort, das Bestehende nicht zu verändern. Je nachdem, wie gravierend die Änderung ist, erstelle ich lieber etwas Neues, migriere bewusst und setze die alte Struktur außer Betrieb:
Hinzufügen statt verändern. Abkündigen statt überraschen.
Salesforce gibt Ihnen sogar eine Möglichkeit, das in den Metadaten auszudrücken: Die Field Usage eines Felds kann auf DeprecateCandidate gesetzt werden, „zur Abkündigung vorgesehen und nicht mehr in Gebrauch“. Das markiert das Feld für alle, die das Objekt lesen; es blendet das Feld nicht aus, das Stilllegen bleibt also eine Entscheidung, die Sie umsetzen müssen.
Denn sobald andere Teile der Architektur von etwas abhängen, kann eine Änderung seiner Bedeutung viel gefährlicher sein als eine Änderung seines Namens. Am schlimmsten ist das Feld, dessen Name gleich bleibt, während sich sein Inhalt ändert: Alles nachgelagerte vertraut weiterhin dem Namen.
Selbst etwas so Einfaches wie das Ankreuzen von Erforderlich bei einem Feld kann zur Zeitbombe werden. Wenn Sie schon Daten erfasst haben, ist das Feld bei manchen Datensätzen nicht befüllt. Tage, Wochen oder Monate später aktualisiert jemand einen dieser Datensätze, und das Speichern schlägt wegen des Pflichtfelds fehl, und niemand hat diesen Wert. Eine einfache Änderung wie das Kennzeichnen eines Felds als erforderlich kann unbeabsichtigte und verzögerte Folgen haben. Wir kommen auf Pflichtfelder, und darauf, wann ein Wert tatsächlich bekannt ist, in Kapitel 3 zurück.
Über die Prüfung hinaus: Auch KI baut auf dem Skelett. Bitten Sie ein KI-Werkzeug, eine Anwendung zu bauen, und es erzeugt die Objekte, Felder, Flows, Apex, Komponenten und Tests in wenigen Minuten. Wenn das ursprüngliche Datenmodell falsch war, haben wir die Folgen einer schlechten Entscheidung nicht vermieden; wir haben sie beschleunigt, denn jede erzeugte Schicht ist eine weitere Sache, die von dieser Struktur abhängt. Deshalb möchte ich, dass ein Mensch aus der Architektur ein von KI erzeugtes Datenmodell prüft, versteht und dafür verantwortlich ist. Modul 7 führt das weiter.
Das Skelett kommt zuerst
Abschnitt betitelt „Das Skelett kommt zuerst “Im Verlauf dieses Kurses sprechen wir über viel Technologie: Objekte und Beziehungen, große Datenvolumen, Abfragen, Integration, Migration, Transaktionen, Sicherheit, Data 360 und KI. Unter all dem liegt das Datenmodell.
Wenn das Modell das Geschäft trägt, mit dem Geschäft wachsen kann und für die Art, wie wir die Daten nutzen werden, Leistung bringt, haben wir ein starkes Fundament gebaut. Wenn wir das Fundament falsch machen, wird alles danach schwieriger.
Das Datenmodell ist das Skelett. Architekt:innen sollten sehr sorgfältig sein, wenn sie das Skelett entwerfen. Änderungen an bestehenden Strukturen können Folgen nach sich ziehen, die sich kaskadenartig ausbreiten.
Was Architekt:innen hier entscheiden
Abschnitt betitelt „Was Architekt:innen hier entscheiden “- Ob das Modell das Geschäft trägt, mit ihm wachsen kann und für die Art, wie die Daten genutzt werden, Leistung bringt.
- Ob ein Konzept zu einem Standardobjekt passt oder ein eckiger Pflock ist.
- Wie flach oder wie normalisiert das Modell sein soll, und warum.
- Ob eine Änderung am Skelett ein Hinzufügen, eine Migration oder eine Abkündigung sein sollte statt einer Änderung an Ort und Stelle.
Weiterlesen
Abschnitt betitelt „Weiterlesen “- Considerations for Converting the Field Type of a Custom Field (opens in a new tab), Salesforce-Hilfe (auf Englisch, geprüft am 2026-10-02; erneut geprüft am 2026-10-12): welche Typänderungen Daten verlieren können und warum Sie den Typ eines Felds, auf das Apex, Flows oder Prozesse verweisen, nicht ändern können.
- Data Classification Metadata Fields (opens in a new tab), Salesforce-Hilfe (auf Englisch, geprüft am 2026-10-02; erneut geprüft am 2026-10-12): die Werte von Field Usage (Active, DeprecateCandidate, Hidden) und die anderen Klassifizierungsfelder.