
把資料放在該放的地方
另有 28 種語言版本
English · Español · 日本語 · Português (Brasil) · Français · Deutsch · Italiano · 한국어 · 简体中文 · Português (Portugal) · Bahasa Indonesia · Türkçe · Polski · Tiếng Việt · ไทย · Nederlands · العربية · עברית · Українська · हिन्दी · Русский · Svenska · Dansk · Norsk bokmål · Suomi · Español (México) · Français (Canada) · Deutsch (Schweiz)
第 4 個模組,共 6 個,屬於為含義建模資料一章,即 Data Architect 課程的第 2 章。每個模組都可以獨立閱讀。 上一篇:構建邏輯模型 · 下一篇:設計到第三範式,然後適度回退
**本模組回答的問題:**規範化如何幫助我弄清資料真正屬於哪裡?
我們已經有了一個邏輯模型:實體、關係、屬性和鍵。現在我想問資料建模中最重要的問題之一:這些資料真的屬於這裡嗎?
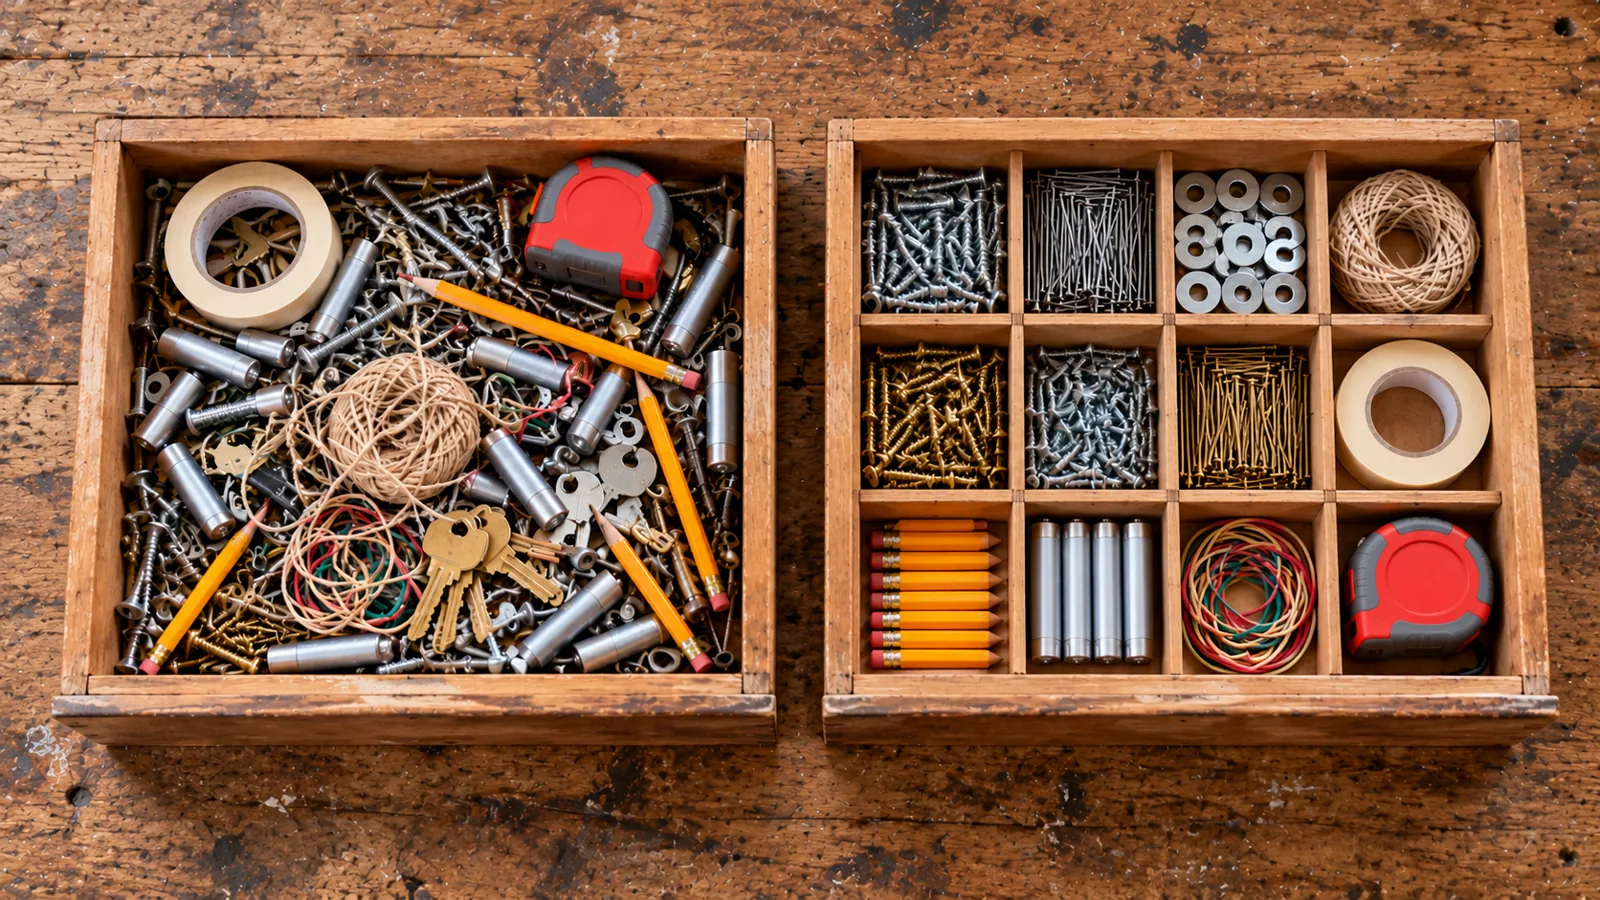
這聽起來很簡單,其實不然。我見過很多系統,其中每個欄位在有人建立它的時候都說得通。問題不在於欄位荒唐,而在於事實存錯了地方。一條配送記錄裡存著其實是在描述配送中心的資訊。同一個地址出現在幾百條記錄上。一個欄位裡存著用逗號隔開的三個值。改動一個業務事實,就意味著要更新 10,000 條記錄。這正是規範化幫我們解決的問題。在我們被資料庫術語淹沒之前,先把整個思路說清楚:**把事實放在它該在的地方。**本模組的其餘內容,都是幫我們更系統地做到這一點。
什麼是規範化?
Section titled “什麼是規範化? ”規範化就是組織資料,讓每個事實只儲存一次,存在它該在的地方。當一張表承擔了太多職責時,我們就把它拆成幾張表,每張表只描述一樣東西,再用鍵把它們連線起來。
何必這麼麻煩?因為只存一次的事實,也只需要改一次。規範化能防止冗餘,也就是同一個事實被複制到許多記錄上,同時也防止一份副本更新了、其他副本沒更新時悄悄出現的不一致。這就是為什麼它適合 Salesforce 這樣的交易系統:記錄整天都在被建立和更新。
我們分步驟進行規範化,這些步驟叫作範式,每一步只問一個問題:
- **第一範式(1NF):**每個欄位一個值,並且有某樣東西能唯一標識每一行。
- **第二範式(2NF):**每個事實都描述標識這一行的全部內容,而不只是其中一部分。
- **第三範式(3NF):**每個事實都描述這樣東西本身,而不是與它相關的別的東西。
第三範式之後還有更多範式。我稍後會簡單談談它們,以及為什麼我們通常止步於第三範式。首先,我們來看看這三個步驟是怎麼發生的。
為什麼要規範化?
Section titled “為什麼要規範化? ”我在現場授課時,不從配送講起,而是從狗狗講起。每個人都懂狗,所以沒人會被業務分心,我們可以看著資料努力找到自己的家。然後,我們再把同樣的步驟用到 Steve Trucking 上。
坐下、別動、建模
Section titled “坐下、別動、建模 ”**起點:原始電子表格。**我會在螢幕上放幾隻狗,然後全班同學再加上他們自己的。幾分鐘之內,我們就有了一張大清單:狗的名字、出生年份、主人是誰、主人住在哪裡、品種、繁育者是誰,以及它會哪些技能。
| 狗狗 | 出生年份 | 主人 | 郵編 | 城市 | 品種 | 繁育者 | 技能 |
|---|---|---|---|---|---|---|---|
| Bella | 2017 | Marcus | 80202 | Denver | 拉布拉多 | Maple Ridge | 坐下、別動、握手 |
| Milo | 2019 | Marcus | 80202 | Denver | 貴賓犬 | Golden Meadow | 坐下、打滾 |
| Max | 2022 | Ana | 64105 | Kansas City | 混種 | 坐下、裝死 | |
| Luna | 2020 | Kenji | 98101 | Seattle | 哈士奇 | Cascade | 坐下、別動、轉圈 |
| Rocky | 2024 | Priya | 30301 | Atlanta | 比格犬 | Maple Ridge | 坐下 |
| Coco | 2014 | Ana | 64105 | Kansas City | 吉娃娃 | Little Paws | 握手、轉圈 |
它能用。每張電子表格在第一天都能用。但看看已經出了什麼問題。我要怎麼找出所有會「握手」的狗?Ana 的郵編出現在兩行上,Marcus 的也是:如果有人只更新了其中一行,會怎樣?Maple Ridge 出現了兩次,Kansas City 也是。還有,Max 是從收容所領養的,所以根本沒有繁育者。
**第 1 步:第一範式。兩條規則。每個欄位只存一個值,所以用逗號隔開的技能清單必須拿掉。並且每一行都需要某樣能唯一標識它的東西。**不是狗的名字,叫 Max 的狗多得是。而是一個 ID:一個自動生成的 ID,或者一個 GUID。技能被拆出來,放進它們自己的行裡,每隻狗的每項技能一行。而一旦一項技能有了自己的行,就有地方記錄逗號清單裡永遠說不出來的東西:這項技能有多難,這隻狗掌握得怎麼樣,以及它是什麼時候學會的。
狗狗(按狗狗 ID 標識)
| 狗狗 ID | 名字 | 出生年份 | 主人 | 郵編 | 城市 | 品種 | 繁育者 |
|---|---|---|---|---|---|---|---|
| D-001 | Bella | 2017 | Marcus | 80202 | Denver | 拉布拉多 | Maple Ridge |
| D-002 | Milo | 2019 | Marcus | 80202 | Denver | 貴賓犬 | Golden Meadow |
| D-003 | Max | 2022 | Ana | 64105 | Kansas City | 混種 | |
| D-004 | Luna | 2020 | Kenji | 98101 | Seattle | 哈士奇 | Cascade |
| D-005 | Rocky | 2024 | Priya | 30301 | Atlanta | 比格犬 | Maple Ridge |
| D-006 | Coco | 2014 | Ana | 64105 | Kansas City | 吉娃娃 | Little Paws |
狗狗技能(Dog Trick)(按狗狗 ID + 技能標識)
| 狗狗 ID | 技能 | 難度 | 熟練程度 | 學會時間 |
|---|---|---|---|---|
| D-001 | 坐下 | 簡單 | 精通 | 2017-11 |
| D-001 | 別動 | 簡單 | 精通 | 2018-01 |
| D-001 | 握手 | 中等 | 良好 | 2018-06 |
| D-002 | 坐下 | 簡單 | 精通 | 2020-02 |
| D-002 | 打滾 | 困難 | 學習中 | 2023-05 |
| D-003 | 坐下 | 簡單 | 良好 | 2022-06 |
| D-003 | 裝死 | 困難 | 學習中 | 2024-03 |
| D-004 | 坐下 | 簡單 | 精通 | 2020-11 |
| D-004 | 別動 | 簡單 | 良好 | 2021-01 |
| D-004 | 轉圈 | 中等 | 精通 | 2021-06 |
| D-005 | 坐下 | 簡單 | 學習中 | 2025-02 |
| D-006 | 握手 | 中等 | 精通 | 2015-06 |
| D-006 | 轉圈 | 中等 | 學習中 | 2025-04 |
現在,「所有會握手的狗」就是一個簡單的問題了。但請注意狗狗技能是靠什麼標識的:不是一樣東西,而是兩樣東西合在一起,狗和技能。先記住這一點。
**第 2 步:第二範式。**只有當一行是由一個組合來標識時,第二範式才有意義,而狗狗技能正是如此。所以我對每一列都問:**它描述的是整個組合,還是隻是其中一部分?**熟練程度描述的是這隻狗做這項技能:Bella 的「坐下」已經精通,Rocky 還在學。學會時間也一樣。但難度呢?不管哪隻狗做,「坐下」都很簡單。它描述的是技能,只是鍵的一部分,這就是為什麼「簡單」在每一行「坐下」上都重複出現。所以技能有了自己的表,剩下的就是這一對組合。
技能
| 技能 ID | 技能 | 難度 |
|---|---|---|
| T-01 | 坐下 | 簡單 |
| T-02 | 別動 | 簡單 |
| T-03 | 握手 | 中等 |
| T-04 | 打滾 | 困難 |
| T-05 | 裝死 | 困難 |
| T-06 | 轉圈 | 中等 |
狗狗技能(狗狗 ID + 技能 ID)
| 狗狗 ID | 技能 ID | 熟練程度 | 學會時間 |
|---|---|---|---|
| D-001 | T-01 | 精通 | 2017-11 |
| D-001 | T-02 | 精通 | 2018-01 |
| D-001 | T-03 | 良好 | 2018-06 |
| D-002 | T-01 | 精通 | 2020-02 |
| D-002 | T-04 | 學習中 | 2023-05 |
| D-003 | T-01 | 良好 | 2022-06 |
| D-003 | T-05 | 學習中 | 2024-03 |
| D-004 | T-01 | 精通 | 2020-11 |
| D-004 | T-02 | 良好 | 2021-01 |
| D-004 | T-06 | 精通 | 2021-06 |
| D-005 | T-01 | 學習中 | 2025-02 |
| D-006 | T-03 | 精通 | 2015-06 |
| D-006 | T-06 | 學習中 | 2025-04 |
這張狗狗技能表,就是我們在模組 2 中發現的那張,它在資料建模中有個名字:聯接,或者照我的叫法,邏輯交叉物件。一隻狗會很多項技能;一項技能也有很多隻狗會。交叉物件位於兩者之間,而且它不是空洞的管道:它存放著屬於這段關係本身的事實,也就是熟練程度和日期。我們會在模組 6 中再次遇到它;在第 3 章中我們還會看到,Salesforce 對「交叉物件」的用法更窄:**Salesforce 交叉物件(Junction Object)**是一個帶有兩個主要-詳細資料關係的自訂物件(第 3 章,模組 7)。
**第 3 步:第三範式。**現在回到狗狗表。表上的一切都由狗狗 ID 標識,所以第二範式沒什麼可說的。第三範式問的是另一個問題:**這個事實描述的是這隻狗,還是這隻狗相關的別的東西?**品種是一個獨立的東西:拉布拉多就是拉布拉多,不管是哪隻狗,而關於它的事實,比如體型,屬於品種,而不屬於 Bella。郵編和城市描述的是主人,而不是狗:那是 Ana 住的地方,不管我們看的是她的哪隻狗。繁育者的詳細資訊描述的是繁育者。這些都是關於另一個事實的事實,所以每一項都移到它自己的表裡,狗用一個外部索引鍵指向它:
- **狗狗:**狗狗 ID、名字、出生年份、主人 ID、品種 ID、繁育者 ID
- **主人:**主人 ID、姓名、郵編、城市
- **品種:**品種 ID、品種、體型
- **繁育者:**繁育者 ID、名稱、城市
- 技能和狗狗技能,來自第 2 步
現在 Ana 只儲存一次,她的兩隻狗都指向她。Maple Ridge 只儲存一次,而品種表為每個品種的事實(比如體型)提供了一個家,這些事實在電子表格里根本沒地方放。外部索引鍵可以為空:Max 沒有繁育者 ID,這是一個誠實的答案,而不是缺漏。然後我會給全班出一道陷阱題:主人是什麼時候得到這隻狗的,這個日期放在哪裡?放在狗上。在這個模型裡,一隻狗同一時間只有一個主人,所以這個日期描述的是這隻狗與它主人之間的關係。
你還可以再進一步,把城市從郵編中拆出來;教科書就是這麼做的。但在實踐中,一個地址會保持在一起,況且 Kansas City 本來就橫跨兩個州,這很好地提醒我們:現實世界可不讀我們的教科書。
這就是整個過程:一張電子表格,然後三個問題,每個事實最後都落在一個地方。退後一步,看看我們建了什麼。一張雜亂的清單變成了六張表,每張描述一樣東西,用鍵連線起來:
跟上這個過程,不需要任何一個 Salesforce 術語。它只是狗、狗身邊的人,以及它們會什麼。
現在把它用到 Steve Trucking 上
Section titled “現在把它用到 Steve Trucking 上 ”狗狗讓這些步驟一目瞭然。而真實的業務讓它們變得要緊,因為同樣的錯誤在規模化之後要花真金白銀。所以,我們把同樣的三個問題帶到 Steve Trucking。假設它是這樣記錄配送的:
| 配送 | 零售合作夥伴 | 配送中心 | 配送中心城市 | 配送小組 | 卡車 |
|---|---|---|---|---|---|
| 1001 | Keystone | Keystone Phoenix DC | Phoenix | 配送小組 12 | 117 |
| 1002 | Keystone | Keystone Phoenix DC | Phoenix | 配送小組 8 | 122 |
| 1003 | Keystone | Keystone Phoenix DC | Phoenix | 配送小組 12 | 117 |
乍一看,這裡沒什麼複雜的。但看看配送中心。我們在每一條從它出發的配送上重複寫著「Keystone Phoenix DC, Phoenix」:Steve Trucking 每天在九個配送中心之間大約完成 3,300 次配送,所以每個配送中心每天有幾百次。如果那個配送中心搬遷了怎麼辦?我們要改多少條記錄?如果漏掉一條又會怎樣?現在資料說這個配送中心同時位於兩個城市。這就是更新異常。如果我們想在一個新配送中心的第一次配送之前就把它建立起來,怎麼辦?如果我們刪除了某個配送中心的最後一次配送:我們是不是剛剛把唯一存放著它的資訊的地方也刪掉了?
這些是同一個問題的不同症狀:**我們把關於不同事物的事實混在了一起。**配送中心的事實屬於配送中心。配送的事實屬於配送。配送小組的事實屬於配送小組。這就是實踐中的規範化。
第一範式:不要隱藏重複結構
Section titled “第一範式:不要隱藏重複結構 ”我們從第一範式,也就是 1NF 開始。人們有時會在這裡把規範化弄得比實際需要更難。
假設一次配送有個叫「項目」的欄位:「冰箱、製冰機套件、舊機拉走。」我們把三條資訊放進了一個欄位。這看起來很方便,直到有人問:「上個月我們做了多少次舊機拉走?」或者想像有叫項目 1、項目 2 和項目 3 的欄位。這也能用,直到出現有四個項目的配送。問題不在於我們選錯了項目欄位的數量,而在於我們沒有認出這個重複結構。一次配送可以有好幾個項目。這是我們應該建模的資料:也就是我們在模組 2 中發現的配送項目。
1NF 的實踐經驗是:**不要把重複結構藏在欄位裡。**如果業務告訴你某件事可以發生很多次,就要認真聽。可能有另一個實體正想冒出來。
在真實的 org 裡,你會經常看到這種情況。有人需要幾種語言的描述,於是建立了一個叫 Description_English 的欄位,然後是 Description_French,再然後是 Description_German。或者一項審批需要幾個人,於是我們就有了審批人 1、審批人 2、審批人 3。我在評審中發現這種情況時,就是打一下手,去修你的資料模型。如果業務確實永遠只有一兩個,一兩個欄位也許還行。超過這個數,就應該是一個子物件:一個帶有語言的翻譯(Translation),一個帶有審批人的審批步驟(Approval Step)。下一種語言,或者第四位審批人,就變成一條新記錄,而不是一個新欄位外加一次部署。
第二範式:描述整個東西
Section titled “第二範式:描述整個東西 ”第二範式,也就是 2NF,在一條記錄由多樣東西的組合來標識時才有意義。以配送項目為例。它有自己的記錄 ID,但每一條都按配送 + 產品唯一。假設我們儲存配送、產品、數量和產品的描述。
數量在這裡說得通:它描述的是這次配送上的這個產品。但產品描述描述的並不是這個組合,而是產品本身。把它放在每一條配送項目上,那麼這個型號的冰箱每次裝上另一輛卡車,我們都要重複一遍。這就是線索:這個事實屬於別的地方。
所以 2NF 的問題是:**這個屬性描述的是我正在標識的整個東西,還是隻是其中一部分?**如果它只描述產品,它就歸產品。如果它描述的是產品在這次特定配送中的情況(數量、是否需要安裝),它就屬於配送項目。很多管理員永遠不會有意識地說:「我現在正在應用第二範式。」這沒關係。我更在意的是,你學會問:這個事實實際上描述的是什麼?
第三範式:不要儲存關於其他事實的事實
Section titled “第三範式:不要儲存關於其他事實的事實 ”現在說說日常建模中我最看重的那個:第三範式,也就是 3NF。
每個配送中心在零售合作夥伴那邊都有一位經理,這個人會使用合作夥伴入口網站。假設我們把配送中心經理的姓名直接放在每一次配送上。配送中心換了新經理時會怎樣?我們要更新從那個配送中心出發的每一次配送。又是那股味道:我們在重複一個屬於別處的事實。配送從一個配送中心出發;配送中心有一位經理。這是兩段關係,經理的姓名屬於配送中心。
經典的教科書例子是地址:郵編、城市和州一起儲存在每條記錄上,而城市和州通常可以由郵編推出來。同樣的形狀,同樣的問題。
實用的 3NF 問題是:**這個事實描述的是這樣東西,還是與這樣東西相關的別的東西?**我希望你時刻都在問這個問題。
現在退後一步,就像我們對狗狗做的那樣。我們一開始的那張配送表變成了五樣東西,每樣都存放自己的事實:配送項目在第一範式時被拆出來,產品在第二範式時被拆出來,而配送中心的城市和經理在第三範式時移到了配送中心。
同樣的三個問題,同樣的結果:每個事實都在一個地方。
理解 1NF、2NF 和 3NF 的簡單方法
Section titled “理解 1NF、2NF 和 3NF 的簡單方法 ”你可以花一整門資料庫課程來講規範化。我們不打算這麼做。在這門課裡,我希望你有一個在職架構師的理解:
- **1NF:**我是不是把多個值或者重複結構藏在了一個欄位或一條記錄裡?
- **2NF:**這個事實描述的是我正在標識的整個東西嗎?
- **3NF:**這個事實真的在描述這個實體,還是在描述與它相關的東西?
這些不是資料庫教科書裡的定義,而是我在設計時真正能用上的問題。
是的,規範化還能走得更遠:**Boyce-Codd 範式(BCNF)**針對鍵更復雜的模型收緊了 3NF 周圍的規則,此外還有第四、第五甚至第六範式。它們處理的是更少見的重複,這類重複更多來自不尋常的鍵結構,而不是日常的業務記錄。理論很多,而根據我的經驗,對於我們在 Salesforce 上構建的這類系統,不值得為它們頭疼。在業務系統中,壓力通常朝著相反的方向:出於使用者、報表和效能的考慮,我們從第三範式適度回退的可能性,遠遠大於越過它。這是下一個模組的內容。知道還有更高的範式存在就好,但對於我們做的大多數事情,1NF 到 3NF 就給了我們所需的思考工具。
按第三範式來設計
Section titled “按第三範式來設計 ”我的立場是這樣的。當我試圖理解一個業務並設計它的邏輯模型時,我想從乾淨的狀態開始:配送的事實歸配送,配送中心的事實歸配送中心,卡車的事實歸卡車,重複的概念作為概念來建模。我不想僅僅因為可能讓某個介面或報表更方便,就把一個業務事實複製得滿模型都是。至少現在還不要。
但規範化不是宗教。目標不是做出學術上最純粹的模型。我見過一些架構師太專注於純粹,結果模型讓每個必須使用它的人都很痛苦。我們不是要贏得一場規範化比賽;我們是在構建一個系統,而這個系統有使用者、報表、整合、效能需求、規模,以及越來越多讀取資料的 AI。它們可能想要不同形狀的資料。
所以我的起點是在可行的情況下設計到第三範式,然後在必要時適度回退:先弄清每個事實屬於哪裡。然後,如果我們要偏離它,我想知道為什麼。如果答案是「因為我不知道這個欄位還能放哪兒」,那就不夠好。如果答案是「我們有意複製了這個值,因為它讓合作夥伴記分卡變得簡單,而且我們有可靠的方法讓它保持同步」,那我們就是在進行一場架構對話了。
架構師在這裡決定什麼
Section titled “架構師在這裡決定什麼 ”在對邏輯模型做規範化時,我會尋找:
- 應該單獨建模的重複值或重複結構。
- 描述的實體與它們所存放的實體不同的屬性。
- 在許多記錄上不必要地重複的事實,以及讓它們變得不一致的依賴關係。
- 藏在欄位裡的業務概念。
- 一個在任何實現妥協之前就能呈現真相的乾淨模型。
這不是因為每個物理系統都必須保持完美的規範化。恰恰相反。在下一個模組中,我們會出於使用者、報表、規模、分析和 AI 的考慮,有意偏離乾淨的模型,而且我們會清楚地知道自己在用什麼做交換。