
Wo liegen diese Daten?
Auch in 28 Sprachen
English · Español · 日本語 · Português (Brasil) · Français · Deutsch · Italiano · 한국어 · 简体中文 · Português (Portugal) · 繁體中文 · Bahasa Indonesia · Türkçe · Polski · Tiếng Việt · ไทย · Nederlands · العربية · עברית · Українська · हिन्दी · Русский · Svenska · Dansk · Norsk bokmål · Suomi · Español (México) · Français (Canada)
Modul 4 von 10 im Kapitel Salesforce-Datenarchitektur, Kapitel 3 des Kurses Data Architect. Jedes Modul steht für sich. Zurück: Selbst gebaut: benutzerdefinierte Objekte · Weiter: Das richtige Objekt wählen
Die Frage, die dieses Modul beantwortet: Bevor Sie ein Objekt erstellen, wo sollten diese Daten eigentlich liegen: auf dem Core in Salesforce, referenziert dort, wo sie schon liegen, oder archiviert?
Ich stelle Ihnen eine Frage. Eine neue Anforderung landet auf Ihrem Tisch. Was tun Sie als Erstes?
Wenn Sie wie die meisten von uns sind, öffnen Sie das Setup und erstellen ein benutzerdefiniertes Objekt. Ich verstehe das. In zehn Minuten haben Sie eine Registerkarte, ein Seitenlayout und eine Listenansicht. Und das sage ich jedem Kurs: In dem Moment, in dem Sie dieses neue Objekt erstellen, denken Sie bereits wie Architekt:innen, ob Sie es wollten oder nicht. Denn jedes Objekt, das Sie erstellen, ist eine Verpflichtung. Es braucht Speicher. Es unterliegt Grenzen. Es bekommt ein Freigabemodell, ob Sie eines entworfen haben oder nicht. Es braucht eine Lizenz für jede Person, die es anfasst. Und sobald Menschen und Integrationen davon abhängen, viel Glück beim Wegnehmen.
Die erste Architekturentscheidung ist also nicht, welches Objekt. Es ist: Wo sollten diese Daten liegen? Machen Sie das richtig, und der Objekttyp wählt sich fast von selbst.
Auf dem Core und ausserhalb des Core
Abschnitt betitelt „Auf dem Core und ausserhalb des Core “Zuerst ein Wort, das ich oft verwenden werde: Core. Der Core ist die Salesforce-Plattform, auf der Ihre Org läuft: die metadatengesteuerte, mandantenfähige Plattform aus Modul 1, auf der die Sales- und Service-Objekte aus Modul 2 liegen, und jedes benutzerdefinierte Objekt, das Sie in Modul 3 bauen. Wenn ich sage, Daten liegen auf dem Core, meine ich, dass sie in Ihrer Org gespeichert sind, in deren Objekten.
Nicht alle Daten liegen dort. Data 360 hält seine Daten in einem eigenen Speicher, ausserhalb der Objekte Ihrer Org (es liegt nahe am Core (Near-Core): auf dem Core verwaltet, seine Daten ausserhalb des Core gehostet; mehr dazu in Kapitel 4). Und dann gibt es alles, was Ihr Unternehmen betreibt und was gar nicht Salesforce ist: das ERP, das Warehouse, das Auftragssystem, die Plattform des Partners. All das liegt ausserhalb des Core. Salesforce kann es erreichen, anzeigen und nutzen, aber Ihre Org speichert es nicht.
Auf dem Core gibt es zwei Arten von Objekten, die Ihre Datensätze tatsächlich halten: sObjects, Standard und benutzerdefiniert (__c), und Big Objects (__b). Ausserhalb des Core erreichen Sie Daten über externe Objekte (__x) und die anderen Integrationswerkzeuge. Behalten Sie diese Suffixe aus Modul 3 im Kopf; sie sagen Ihnen schon am Namen, wo ein Stück Daten liegt.
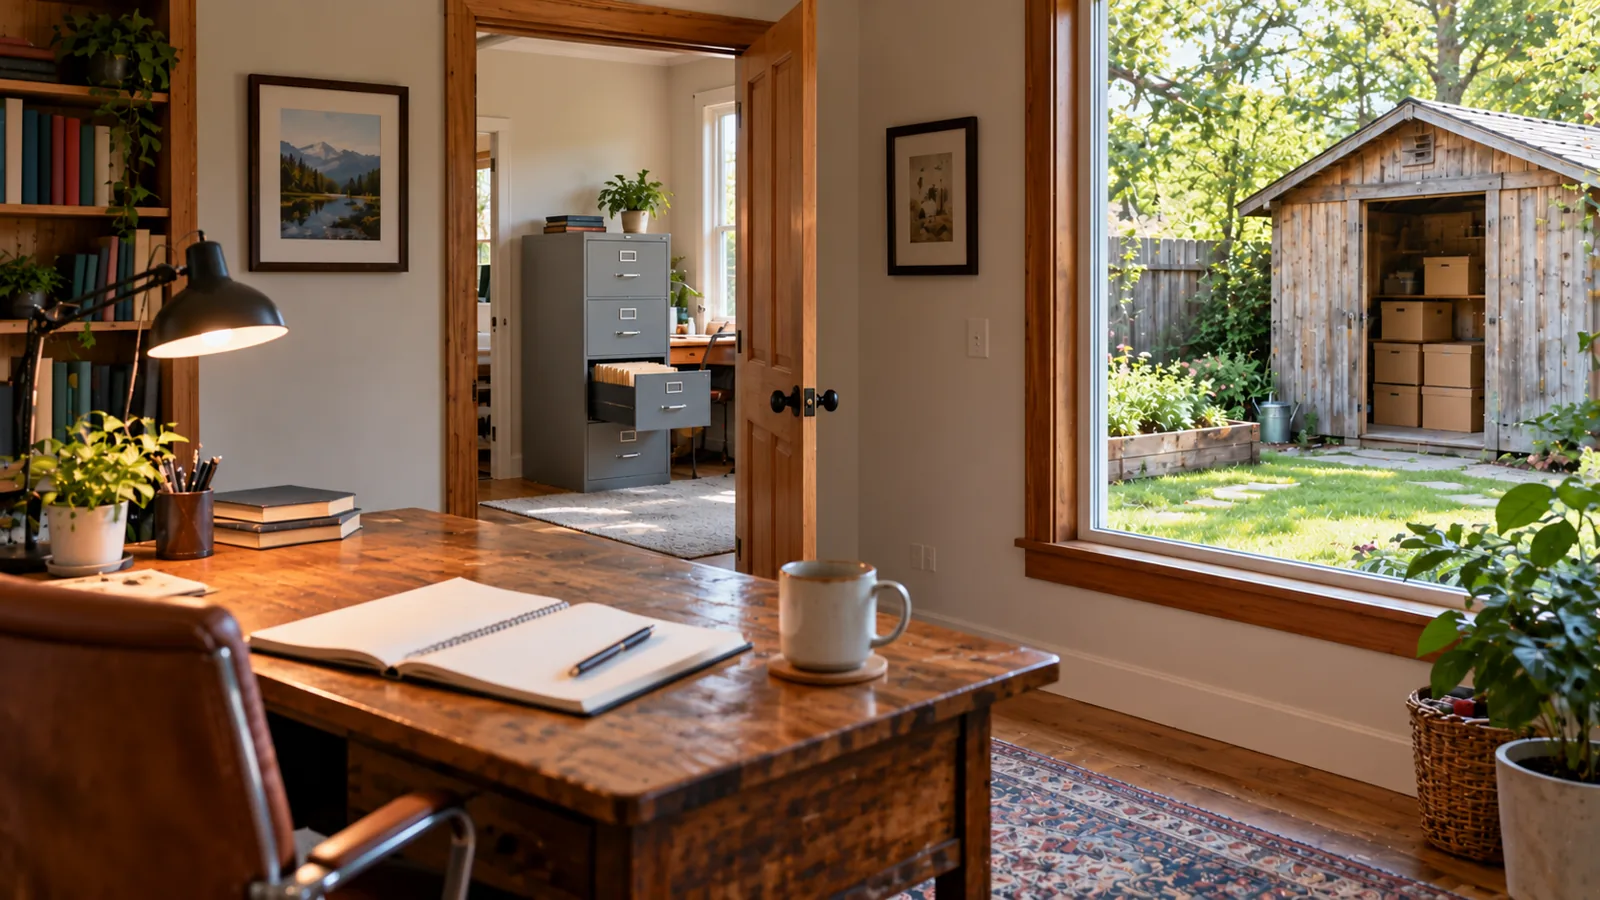
Ich stelle es mir wie ein Büro vor. Manches gehört auf Ihren Schreibtisch, wo Sie es jeden Tag benutzen. Manches müssen Sie nur im Aktenschrank von jemand anderem nachschlagen. Und manches kommt in Kartons in den Schuppen hinterm Haus. Das ergibt drei Antworten.
1. Auf dem Core: Es liegt auf Ihrem Schreibtisch
Abschnitt betitelt „1. Auf dem Core: Es liegt auf Ihrem Schreibtisch “Die Daten werden jeden Tag in Salesforce erstellt, geändert und genutzt: Accounts, Kundenvorgänge, Opportunities, Arbeitsaufträge. Sie in sObjects zu halten ist, als würden Sie sie vorn in Ihrem Büro aufbewahren. Dafür sind Standard- und benutzerdefinierte Objekte da, und Sie bekommen alles: Seitenlayouts, Freigabe, Automatisierung, Berichte, Suche und jetzt die KI-Funktionen, die auf dem Datenmodell aufbauen.
Ihr Schreibtisch ist allerdings nicht kostenlos. Daten auf dem Core kosten Speicher, gezählt so, wie Salesforce zählt, Datensatz für Datensatz, nicht Spalte für Spalte, und Dokumente belasten den Dateispeicher gesondert. Beides haben wir in Modul 2 behandelt. Grosse Mengen an Fotos und Scans gehören oft ausserhalb des Core, und Salesforce behält nur einen Link.
2. Referenziert: Es liegt im Aktenschrank von jemand anderem
Abschnitt betitelt „2. Referenziert: Es liegt im Aktenschrank von jemand anderem “Die Daten gehören einem anderen System (dem ERP, einem Data Warehouse, einer Auftragsplattform), und dieses System bleibt die Quelle der Wahrheit. Die Benutzer müssen sie in Salesforce sehen, vielleicht mit einem Datensatz verknüpfen, aber Salesforce braucht keine eigene Kopie. Man nennt solche Daten auch virtuelle Daten: Sie erscheinen virtuell in Salesforce, ohne je dort gespeichert zu werden.
Das sind externe Objekte, über Salesforce Connect. Ich sage gern: Es sieht aus wie eine Ente und watschelt wie eine Ente, aber es ist keine Ente. Es erscheint wie ein sObject: Sie können es auf Seitenlayouts und in Themenlisten setzen und mit externen und indirekten Nachschlagefeldern mit Ihren eigenen Datensätzen verknüpfen. Aber die Daten werden nicht auf dem Core gespeichert. Bei jedem Zugriff gibt es einen Callout. Öffnen Sie einen Datensatz, laden Sie eine Themenliste, führen Sie einen Bericht aus, und Salesforce fragt das andere System. Das heisst Latenz, und Ihre Seite ist nur so verfügbar wie das System dahinter.
Die Leute wehren sich gegen die Lizenzkosten, also rechnen Sie so, wie ich es im Kurs tue. Connect wird pro Endpunkt lizenziert, und ein Endpunkt kann viele Objekte hereinbringen. Fragen Sie jetzt, was es kostet, die Alternative zu bauen und zu warten: eine benutzerdefinierte Komponente, den Callout-Code dahinter und jemanden aus der Entwicklung in Rufbereitschaft, wenn es bricht. Oft ist die Lizenz billiger, und Ihre Administration kann es konfigurieren, ohne eine Zeile Code zu schreiben. Wo es scheitert: bei Daten, die Ihre Benutzer den ganzen Tag bearbeiten oder über die sie intensiv berichten.
Auch Dokumente lassen sich referenzieren. Wenn ein Vertrag bereits in SharePoint Online, OneDrive, Google Drive oder Box liegt, lässt Files Connect die Benutzer ihn aus Salesforce erreichen, ohne ihn hineinzukopieren.
Salesforce Connect ist nicht der einzige Weg, Daten zu referenzieren. Manchmal ist es eigene Logik: Code, der das andere System in Echtzeit aufruft und dessen Daten auf der Seite darstellt, ohne eine Kopie zu behalten. Das gibt Ihnen volle Kontrolle und volle Verantwortung für den Callout, die Fehler und die Wartung. Und auch Data 360 kann föderieren, ohne zu kopieren. Diese Wahl hat ein eigenes Kapitel (Virtualization, Federation, and Zero-Copy). Hier geht es um die Entscheidung selbst: referenzieren, nicht kopieren.
3. Archiviert: Es kommt in den Schuppen hinterm Haus
Abschnitt betitelt „3. Archiviert: Es kommt in den Schuppen hinterm Haus “Historie, Prüfpfade, alte Transaktionen. Sie müssen sie aufbewahren, manchmal jahrelang, aber fast niemand öffnet sie. Und genau das schieben Teams vor sich her. Wenn mir ein Kurs erzählt, er habe ein Objekt mit 50 Millionen Datensätzen, und fragt, warum er archivieren sollte, frage ich zurück: Wenn Sie heute nicht archivieren, werden Sie es dann je tun? Bei 50 Millionen heute steuern Sie auf 100, 150, 200 Millionen zu.
Es gibt zwei Schuppen. Der eine liegt auf dem Core: Big Objects. Stellen Sie sie sich vor wie Daten in der Garage. Sie können eine riesige Zahl von Datensätzen speichern, aber Sie können sie nicht auf ein Seitenlayout setzen, es gibt keine Standardoberfläche und keine Standardberichte, und Sie fragen über den Index des Big Objects ab, per exakter Übereinstimmung oder Bereich (Big Objects Best Practices (opens in a new tab), auf Englisch). Die Sicherheit beschränkt sich auf Objekt- und Feldberechtigungen, ohne Datensatzfreigabe, und Automatisierung läuft nicht darauf. Salesforce Connect habe ich Dutzende Male eingesetzt, Big Objects nur ein- oder zweimal. Sie funktionieren, aber sie sind umständlich, und ich habe so manchen Workaround geschrieben, um an die Daten zu kommen. Mein Rat also: Bauen Sie einen Prototyp, bevor Sie es vorschlagen, und planen Sie, wie Menschen die Daten finden, bevor Sie sich dafür entscheiden.
Der andere Schuppen liegt ausserhalb des Core: ein Warehouse oder eine Datenbank anderswo (Designing for Scale). Oft ist das der bessere Schuppen, und er muss nicht aus dem Blick sein. Archivierte Daten ausserhalb des Core können über Werkzeuge wie Tableau weiterhin in Berichten erscheinen, und sie können aus Salesforce weiterhin erreichbar sein, über Salesforce Connect oder einen anderen Weg der Virtualisierung, wenn jemand zurückschauen muss.
Ich erzähle Ihnen von einem Projekt, bei dem wir das von Anfang an richtig gemacht haben. Ein Handelskunde hatte über 1’200 Standorte. Sie sagten mir: «Wir machen nur hundert Termine am Tag pro Filiale. Keine grosse Sache.» Dann habe ich gerechnet: hundert am Tag, sechs Tage die Woche (etwa 305 Tage im Jahr), über 1’200 Standorte, das sind über 36 Millionen Termine im Jahr. Dann erwähnten sie, dass jeder Besuch zwei Termine erzeugte, einen am Tresen vorn und einen für die Werkstatt hinten: über 73 Millionen Datensätze im Jahr. Dann wollten sie fünf Jahre Historie: mehr als 360 Millionen Datensätze, noch vor jedem Wachstum. Wir waren noch nicht live, und ich sah den Zug schon direkt auf den Bahnhof der grossen Datenvolumen zurasen. Also wurde das Archiv gebaut, bevor wir einen einzigen Termin erfasst hatten: Ältere Termine wanderten in Big Objects, und der Suchbildschirm zeigte die aktuellen Termine mit den archivierten direkt darunter. Jahre später läuft es immer noch problemlos.
Angewendet: Steve Trucking
Abschnitt betitelt „Angewendet: Steve Trucking “Steve Trucking ist unser durchgehendes Szenario: ein Familienunternehmen für Lieferungen auf der letzten Meile, das Haushaltsgeräte und Elektronik in den Verteilzentren grosser Handelsketten abholt und sie dann bei den Kunden zu Hause liefert und installiert. Vier Arten seiner Daten, drei Antworten:
| Daten | Wo sie liegen | Warum |
|---|---|---|
| Die heutigen Lieferungen, Crews und Termine | Auf dem Core | Disposition und Crews arbeiten den ganzen Tag darin |
| Die Auftragsdetails des Händlers | Referenziert (oder eine schlanke Kopie auf dem Core) | Das System des Händlers ist die Quelle der Wahrheit |
| Lieferhistorie von vor drei Jahren | Archiviert | Aufbewahrt für Reklamationen und Trends; fast niemand öffnet sie |
| Lieferfotos | Ausserhalb des Core, verlinkt | Tausende am Tag; ausserhalb von Salesforce gespeichert, mit einem Link auf der Lieferung |
Hier dasselbe als Datenmodell. Die Lieferung (Delivery) liegt auf dem Core, wo Menschen den ganzen Tag darin arbeiten. Nach drei Jahren wandert sie in den Lieferverlauf (Delivery History), ein Big Object: immer noch auf dem Core, aber draussen im Schuppen. Der Auftrag des Partners erscheint als externes Objekt, __x: Salesforce verknüpft die Lieferung damit, aber die Daten bleiben im System des Händlers. Und die Fotos liegen ganz ausserhalb des Core, mit einem Link von der Lieferung. Ein Modell, drei Zuhause.
Jede echte Org hat alle drei. Die, die in Schwierigkeiten geraten, haben alles auf den Core gelegt, weil ein Objekt zu erstellen der Standardknopf war.
Was Architekt:innen hier entscheiden
Abschnitt betitelt „Was Architekt:innen hier entscheiden “- Das Zuhause für jede Art von Daten, bevor irgendein Objekt entworfen wird: auf dem Core, referenziert oder archiviert.
- Die Quelle der Wahrheit. Wenn ein anderes System die Daten besitzt, sollte Salesforce nicht stillschweigend zu einem zweiten Master werden.
- Den Zugriffsweg für alles ausserhalb des Core. Referenzierte Daten brauchen eine verfügbare Quelle und akzeptable Latenz; archivierte Daten brauchen einen Weg, auf dem Menschen sie finden.
- Das Speicherwachstum. Rechnen Sie jetzt (Datensätze pro Tag mal Wachstum mal Aufbewahrung), nicht erst, wenn die Speicherwarnung kommt.
Über die Prüfung hinaus: KI erhöht den Einsatz bei «auf dem Core». KI-Funktionen und Agenten arbeiten am besten mit Daten, die die Plattform versteht: Daten in Standard- und benutzerdefinierten Objekten, gut benannt und gut beschrieben. Das zieht in Richtung, mehr auf den Core zu legen. Widerstehen Sie dem bei den falschen Daten. Ein Agent, der sich auf eine veraltete Kopie von ERP-Daten stützt, gibt selbstbewusste, falsche Antworten. Oft ist es besser, die Live-Quelle zu referenzieren oder einen kleinen, gut beschriebenen Ausschnitt auf dem Core zu halten. Wo die KI die Daten liest, gehört jetzt zur Entscheidung, wo die Daten liegen.
Weiterlesen
Abschnitt betitelt „Weiterlesen “- Big Objects Best Practices (opens in a new tab), Salesforce Developers (auf Englisch, geprüft am 2026-09-25)
- Files Connect FAQ (opens in a new tab), Salesforce-Hilfe (auf Englisch, geprüft am 2026-09-25)
- In diesem Kurs: Virtualization, Federation, and Zero-Copy und Designing for Scale