
Daten dorthin, wo sie hingehören
Auch in 28 Sprachen
English · Español · 日本語 · Português (Brasil) · Français · Deutsch · Italiano · 한국어 · 简体中文 · Português (Portugal) · 繁體中文 · Bahasa Indonesia · Türkçe · Polski · Tiếng Việt · ไทย · Nederlands · العربية · עברית · Українська · हिन्दी · Русский · Svenska · Dansk · Norsk bokmål · Suomi · Español (México) · Français (Canada)
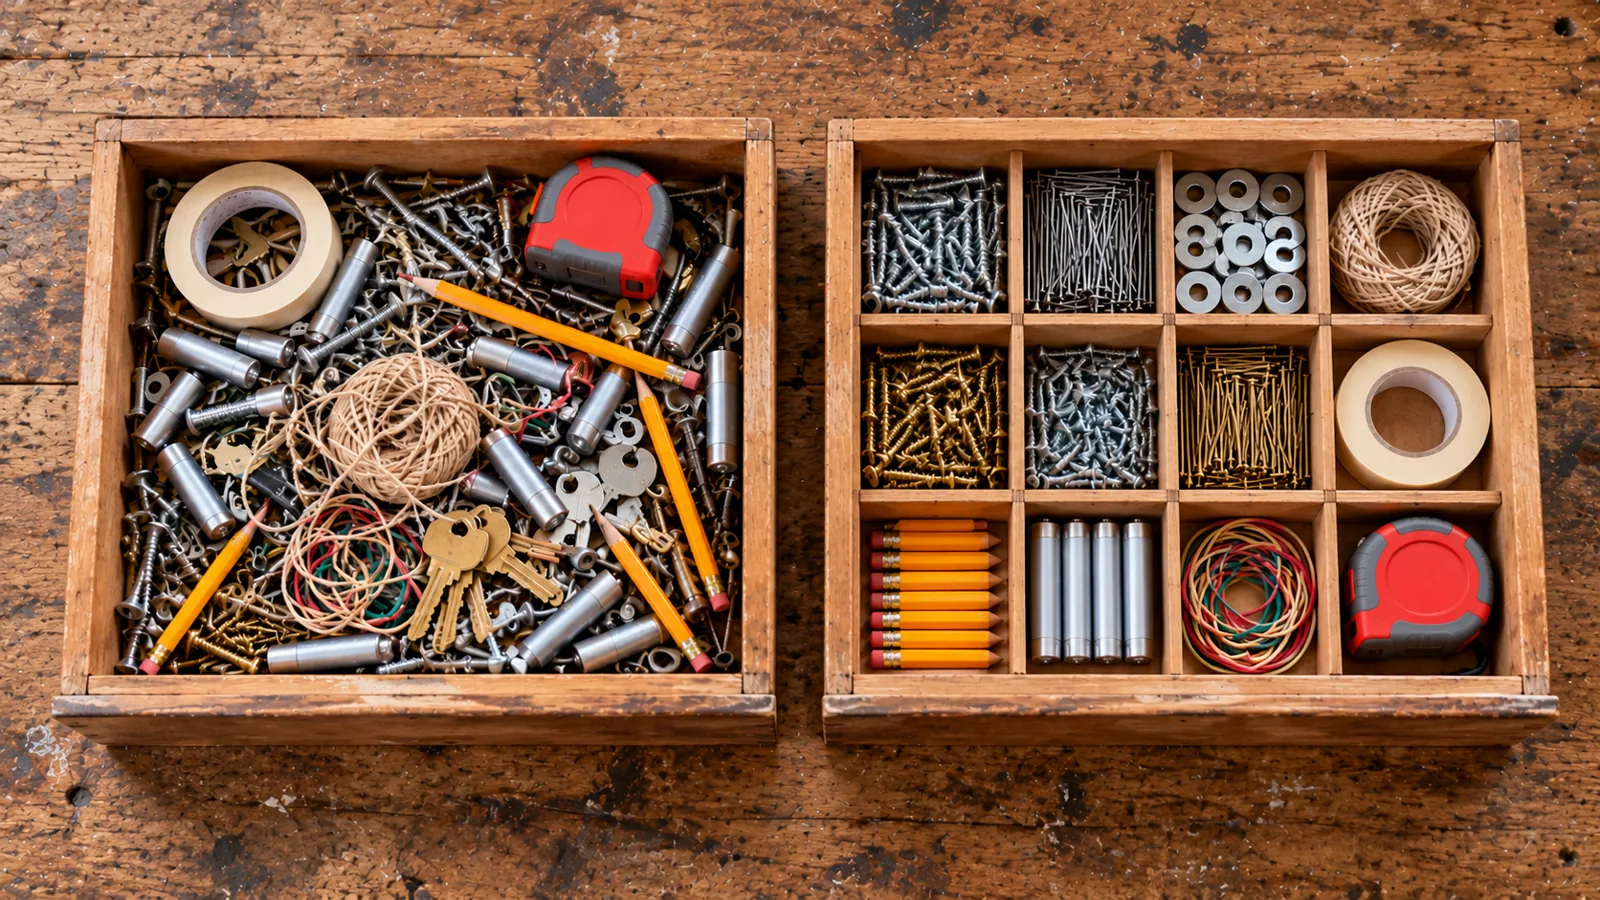
Modul 4 von 6 im Kapitel Daten nach ihrer Bedeutung modellieren, Kapitel 2 des Kurses Data Architect. Jedes Modul steht für sich. Zurück: Das logische Modell aufbauen · Weiter: Bis zur dritten Normalform entwerfen, dann zurückrudern
Die Frage, die dieses Modul beantwortet: Wie hilft mir die Normalisierung herauszufinden, wohin Daten wirklich gehören?
Wir haben ein logisches Modell: Entitäten, Beziehungen, Attribute und Schlüssel. Jetzt möchte ich eine der wichtigsten Fragen der Datenmodellierung stellen: Gehören diese Daten wirklich hierher?
Das klingt einfach. Ist es nicht. Ich habe viele Systeme gesehen, in denen jedes Feld Sinn ergab, als jemand es anlegte. Das Problem war nicht, dass die Felder lächerlich waren; es war, dass die Tatsachen an der falschen Stelle gespeichert waren. Eine Lieferung enthält Informationen, die eigentlich ein Verteilzentrum beschreiben. Dieselbe Adresse steht auf Hunderten von Datensätzen. Ein Feld enthält drei durch Kommas getrennte Werte. Eine Änderung an einer Geschäftstatsache bedeutet, 10’000 Datensätze zu aktualisieren. Dieses Problem hilft uns die Normalisierung zu lösen, und bevor wir in Datenbankbegriffen versinken, hier die ganze Idee: Legen Sie eine Tatsache dorthin, wo sie hingehört. Alles andere in diesem Modul hilft uns, das systematischer zu tun.
Was ist Normalisierung?
Abschnitt betitelt „Was ist Normalisierung? “Normalisierung heisst, Daten so zu ordnen, dass jede Tatsache einmal gespeichert wird, an der Stelle, an die sie gehört. Wenn eine Tabelle zu viele Aufgaben erledigt, teilen wir sie in Tabellen auf, die jeweils ein Ding beschreiben, und verbinden sie über Schlüssel.
Wozu der Aufwand? Weil eine Tatsache, die einmal gespeichert ist, eine Tatsache ist, die wir einmal ändern. Normalisierung verhindert Redundanz, also dieselbe Tatsache über viele Datensätze kopiert, und damit die Inkonsistenzen, die sich einschleichen, wenn eine Kopie aktualisiert wird und die anderen nicht. Deshalb passt sie zu Transaktionssystemen wie Salesforce, in denen den ganzen Tag Datensätze angelegt und aktualisiert werden.
Wir normalisieren in Schritten, die Normalformen heissen, und jede stellt eine einzige Frage:
- Erste Normalform (1NF): ein Wert pro Feld und etwas, das jede Zeile eindeutig identifiziert.
- Zweite Normalform (2NF): Jede Tatsache beschreibt das Ganze dessen, was die Zeile identifiziert, nicht nur einen Teil davon.
- Dritte Normalform (3NF): Jede Tatsache beschreibt dieses Ding, nicht etwas anderes, mit dem es zusammenhängt.
Es gibt weitere Formen jenseits der dritten. Zu ihnen sage ich später ein Wort, und dazu, warum wir meist bei der dritten aufhören. Sehen wir zuerst zu, wie die drei Schritte ablaufen.
Warum normalisieren wir?
Abschnitt betitelt „Warum normalisieren wir? “Wenn ich das live unterrichte, beginne ich nicht mit Lieferungen. Ich beginne mit Hunden. Alle verstehen Hunde, also lenkt das Geschäft niemanden ab, und wir können zusehen, wie die Daten versuchen, ihr Zuhause zu finden. Dann übertragen wir dieselben Schritte auf Steve Trucking.
Sitz, Bleib, Modell
Abschnitt betitelt „Sitz, Bleib, Modell “Start: die rohe Tabelle. Ich zeige ein paar Hunde auf dem Bildschirm, und dann ergänzt der Raum seine eigenen. Nach ein paar Minuten haben wir eine grosse Liste: der Hund, sein Geburtsjahr, wem er gehört, wo die haltende Person wohnt, die Rasse, wer ihn gezüchtet hat und welche Tricks er kann.
| Hund | Geboren | Halter:in | PLZ | Ort | Rasse | Züchter:in | Tricks |
|---|---|---|---|---|---|---|---|
| Bella | 2017 | Marcus | 80202 | Denver | Labrador | Maple Ridge | Sitz, Bleib, Pfote |
| Milo | 2019 | Marcus | 80202 | Denver | Pudel | Golden Meadow | Sitz, Rolle |
| Max | 2022 | Ana | 64105 | Kansas City | Mischling | Sitz, Toter Hund | |
| Luna | 2020 | Kenji | 98101 | Seattle | Husky | Cascade | Sitz, Bleib, Dreh |
| Rocky | 2024 | Priya | 30301 | Atlanta | Beagle | Maple Ridge | Sitz |
| Coco | 2014 | Ana | 64105 | Kansas City | Chihuahua | Little Paws | Pfote, Dreh |
Es funktioniert. Jede Tabelle funktioniert am ersten Tag. Aber sehen Sie, was schon jetzt nicht stimmt. Wie finde ich jeden Hund, der Pfote kann? Anas PLZ steht in zwei Zeilen, die von Marcus ebenso: Was passiert, wenn jemand eine aktualisiert und die andere nicht? Maple Ridge kommt zweimal vor, Kansas City auch. Und Max kommt aus dem Tierheim, es gibt also überhaupt keinen Zuchtbetrieb.
Schritt 1: erste Normalform. Zwei Regeln. Jedes Feld enthält einen einzigen Wert, also muss die kommagetrennte Liste der Tricks weg. Und jede Zeile braucht etwas, das sie eindeutig identifiziert. Nicht den Namen des Hundes; es gibt viele Hunde namens Max. Eine ID: eine automatisch vergebene ID oder eine GUID. Die Tricks wandern in eigene Zeilen, eine Zeile pro Hund und Trick. Und sobald ein Trick eine eigene Zeile hat, ist Platz für das, was wir in einer kommagetrennten Liste nie sagen konnten: wie schwer der Trick ist, wie gut dieser Hund ihn macht und wann er ihn gelernt hat.
Hund (identifiziert durch die Hunde-ID)
| Hunde-ID | Name | Geboren | Halter:in | PLZ | Ort | Rasse | Züchter:in |
|---|---|---|---|---|---|---|---|
| D-001 | Bella | 2017 | Marcus | 80202 | Denver | Labrador | Maple Ridge |
| D-002 | Milo | 2019 | Marcus | 80202 | Denver | Pudel | Golden Meadow |
| D-003 | Max | 2022 | Ana | 64105 | Kansas City | Mischling | |
| D-004 | Luna | 2020 | Kenji | 98101 | Seattle | Husky | Cascade |
| D-005 | Rocky | 2024 | Priya | 30301 | Atlanta | Beagle | Maple Ridge |
| D-006 | Coco | 2014 | Ana | 64105 | Kansas City | Chihuahua | Little Paws |
Hundetrick (identifiziert durch Hunde-ID + Trick)
| Hunde-ID | Trick | Schwierigkeit | Niveau | Gelernt |
|---|---|---|---|---|
| D-001 | Sitz | Leicht | Profi | 2017-11 |
| D-001 | Bleib | Leicht | Profi | 2018-01 |
| D-001 | Pfote | Mittel | Gut | 2018-06 |
| D-002 | Sitz | Leicht | Profi | 2020-02 |
| D-002 | Rolle | Schwer | Lernt noch | 2023-05 |
| D-003 | Sitz | Leicht | Gut | 2022-06 |
| D-003 | Toter Hund | Schwer | Lernt noch | 2024-03 |
| D-004 | Sitz | Leicht | Profi | 2020-11 |
| D-004 | Bleib | Leicht | Gut | 2021-01 |
| D-004 | Dreh | Mittel | Profi | 2021-06 |
| D-005 | Sitz | Leicht | Lernt noch | 2025-02 |
| D-006 | Pfote | Mittel | Profi | 2015-06 |
| D-006 | Dreh | Mittel | Lernt noch | 2025-04 |
Jetzt ist «jeder Hund, der Pfote kann» eine einfache Frage. Aber beachten Sie, wodurch der Hundetrick identifiziert wird: nicht durch ein Ding, sondern durch zwei Dinge zusammen, den Hund und den Trick. Behalten Sie das im Kopf.
Schritt 2: zweite Normalform. Die zweite Normalform zählt nur, wenn eine Zeile durch eine Kombination identifiziert wird, und beim Hundetrick ist das so. Also frage ich bei jeder Spalte: Beschreibt sie die ganze Kombination oder nur einen Teil davon? Das Niveau beschreibt diesen Hund bei diesem Trick: Bella ist Profi bei Sitz, Rocky lernt es noch. Gelernt ebenso. Aber die Schwierigkeit? Sitz ist leicht, egal welcher Hund es macht. Sie beschreibt den Trick, nur einen Teil des Schlüssels, und deshalb steht «Leicht» in jeder Sitz-Zeile. Also bekommt der Trick seine eigene Tabelle, und übrig bleibt das Paar.
Trick
| Trick-ID | Trick | Schwierigkeit |
|---|---|---|
| T-01 | Sitz | Leicht |
| T-02 | Bleib | Leicht |
| T-03 | Pfote | Mittel |
| T-04 | Rolle | Schwer |
| T-05 | Toter Hund | Schwer |
| T-06 | Dreh | Mittel |
Hundetrick (Hunde-ID + Trick-ID)
| Hunde-ID | Trick-ID | Niveau | Gelernt |
|---|---|---|---|
| D-001 | T-01 | Profi | 2017-11 |
| D-001 | T-02 | Profi | 2018-01 |
| D-001 | T-03 | Gut | 2018-06 |
| D-002 | T-01 | Profi | 2020-02 |
| D-002 | T-04 | Lernt noch | 2023-05 |
| D-003 | T-01 | Gut | 2022-06 |
| D-003 | T-05 | Lernt noch | 2024-03 |
| D-004 | T-01 | Profi | 2020-11 |
| D-004 | T-02 | Gut | 2021-01 |
| D-004 | T-06 | Profi | 2021-06 |
| D-005 | T-01 | Lernt noch | 2025-02 |
| D-006 | T-03 | Profi | 2015-06 |
| D-006 | T-06 | Lernt noch | 2025-04 |
Die Tabelle Hundetrick ist die, die wir in Modul 2 gefunden haben, und sie hat in der Datenmodellierung einen Namen: eine Verbindung (Junction), oder wie ich sie nenne, ein logisches Verbindungsobjekt. Ein Hund kann viele Tricks; ein Trick wird von vielen Hunden beherrscht. Die Verbindung sitzt dazwischen, und sie ist keine leere Verrohrung: Sie enthält die Tatsachen, die zur Beziehung selbst gehören, das Niveau und das Datum. Wir begegnen ihr in Modul 6 wieder, und in Kapitel 3 sehen wir, dass Salesforce «Verbindungsobjekt» enger fasst: Ein Salesforce-Verbindungsobjekt (Junction Object) ist ein benutzerdefiniertes Objekt mit zwei Master-Detail-Beziehungen (Kapitel 3, Modul 7).
Schritt 3: dritte Normalform. Jetzt zurück zur Tabelle Hund. Alles darin wird durch die Hunde-ID identifiziert, die zweite Normalform hat also nichts zu sagen. Die dritte Normalform stellt eine andere Frage: Beschreibt diese Tatsache den Hund oder etwas anderes, mit dem der Hund zusammenhängt? Die Rasse ist ein eigenes Ding: Ein Labrador ist ein Labrador, egal welcher Hund es ist, und Tatsachen darüber, etwa die Grösse, gehören zur Rasse, nicht zu Bella. PLZ und Ort beschreiben die haltende Person, nicht den Hund: Dort wohnt Ana, egal welchen ihrer Hunde wir ansehen. Die Angaben zum Zuchtbetrieb beschreiben den Zuchtbetrieb. Jede davon ist eine Tatsache über eine andere Tatsache, also wandert jede in eine eigene Tabelle, und der Hund verweist mit einem Fremdschlüssel darauf:
- Hund: Hunde-ID, Name, Geboren, Halter-ID, Rassen-ID, Züchter-ID
- Halter:in: Halter-ID, Name, PLZ, Ort
- Rasse: Rassen-ID, Rasse, Grösse
- Züchter:in: Züchter-ID, Name, Ort
- Trick und Hundetrick, aus Schritt 2
Ana ist jetzt einmal gespeichert, und beide ihrer Hunde verweisen auf sie. Maple Ridge ist einmal gespeichert, und die Tabelle Rasse gibt uns ein Zuhause für Tatsachen über jede Rasse, etwa ihre Grösse, für die die Tabelle keinen Platz hatte. Ein Fremdschlüssel darf leer sein: Max hat keine Züchter-ID, und das ist eine ehrliche Antwort, keine Lücke. Dann stelle ich dem Raum eine Fangfrage: Wenn die haltende Person den Hund bekommen hat, wohin gehört dieses Datum? Zum Hund. Ein Hund hat in diesem Modell immer nur eine haltende Person, also beschreibt dieses Datum die Beziehung des Hundes zu ihr.
Man könnte noch einen Schritt weitergehen und den Ort von der PLZ trennen; Lehrbücher tun das. In der Praxis bleibt eine Adresse zusammen, und Kansas City liegt ohnehin in zwei Bundesstaaten, eine schöne Erinnerung daran, dass die echte Welt unsere Lehrbücher nicht liest.
Das ist der Ablauf: eine Tabelle, dann drei Fragen, und jede Tatsache landet an einer Stelle. Treten Sie einen Schritt zurück und sehen Sie, was wir gebaut haben. Aus einer unordentlichen Liste wurden sechs Tabellen, jede beschreibt ein Ding, verbunden über Schlüssel:
Niemand brauchte ein einziges Salesforce-Wort, um dem zu folgen. Es sind nur die Hunde, die Menschen um sie herum und was sie können.
Jetzt wenden wir es auf Steve Trucking an
Abschnitt betitelt „Jetzt wenden wir es auf Steve Trucking an “Die Hunde machen die Schritte leicht sichtbar. Ein echtes Geschäft macht sie wichtig, weil dieselben Fehler im grossen Massstab echtes Geld kosten. Stellen wir also dieselben drei Fragen Steve Trucking. Angenommen, das Unternehmen führt seine Lieferungen so:
| Lieferung | Handelspartner | Verteilzentrum | Stadt des VZ | Crew | Lastwagen |
|---|---|---|---|---|---|
| 1001 | Keystone | Keystone Phoenix DC | Phoenix | Crew 12 | 117 |
| 1002 | Keystone | Keystone Phoenix DC | Phoenix | Crew 8 | 122 |
| 1003 | Keystone | Keystone Phoenix DC | Phoenix | Crew 12 | 117 |
Auf den ersten Blick ist hier nichts kompliziert. Aber sehen Sie sich das Verteilzentrum an. Wir wiederholen «Keystone Phoenix DC, Phoenix» bei jeder Lieferung, die von dort abgeht: Steve Trucking macht etwa 3’300 Lieferungen am Tag über neun Verteilzentren, also ein paar Hundert am Tag aus jedem. Was passiert, wenn dieses Verteilzentrum umzieht? Wie viele Datensätze ändern wir, und was passiert, wenn einer vergessen wird? Dann sagen die Daten, das Verteilzentrum liege gleichzeitig in zwei Städten. Das ist eine Änderungsanomalie. Was, wenn wir ein neues Verteilzentrum vor seiner ersten Lieferung anlegen wollen? Was, wenn wir die letzte Lieferung eines Verteilzentrums löschen: Haben wir dann gerade die einzige Stelle gelöscht, an der wir etwas darüber gespeichert hatten?
Das sind verschiedene Symptome desselben Problems: Wir haben Tatsachen über verschiedene Dinge vermischt. Tatsachen über das Verteilzentrum gehören zum Verteilzentrum. Tatsachen über die Lieferung gehören zur Lieferung. Tatsachen über die Crew gehören zur Crew. Das ist Normalisierung, praktisch ausgedrückt.
Erste Normalform: Verstecken Sie keine sich wiederholende Struktur
Abschnitt betitelt „Erste Normalform: Verstecken Sie keine sich wiederholende Struktur “Beginnen wir mit der ersten Normalform, kurz 1NF, bei der man die Normalisierung manchmal schwerer macht, als sie sein muss.
Angenommen, eine Lieferung hat ein Feld namens Artikel: «Kühlschrank, Eiswürfelbereiter-Set, Mitnahme.» Wir haben drei Informationen in ein Feld gesteckt. Das wirkt praktisch, bis jemand fragt: «Wie viele Mitnahmen hatten wir letzten Monat?» Oder stellen Sie sich Felder namens Artikel 1, Artikel 2 und Artikel 3 vor. Das funktioniert bis zur Lieferung mit vier Artikeln. Das Problem ist nicht, dass wir die falsche Anzahl von Artikelfeldern gewählt haben. Das Problem ist, dass wir die sich wiederholende Struktur nicht erkannt haben. Eine Lieferung kann mehrere Artikel haben. Das sind Daten, die wir modellieren sollten: die Lieferposition, die wir in Modul 2 gefunden haben.
Die praktische Lehre der 1NF: Verstecken Sie keine sich wiederholende Struktur in Feldern. Wenn Ihnen das Geschäft sagt, dass etwas viele Male vorkommen kann, hören Sie hin. Vielleicht will da eine weitere Entität heraus.
Das sehen Sie in echten Orgs ständig. Jemand braucht eine Beschreibung in mehreren Sprachen und legt ein Feld Description_English an, dann Description_French, dann Description_German. Oder eine Genehmigung braucht ein paar Personen, also bekommen wir Genehmiger 1, Genehmiger 2, Genehmiger 3. Wenn ich das in einem Review finde, gibt es einen Klaps auf die Finger: Bringen Sie Ihr Datenmodell in Ordnung. Eins oder zwei, vielleicht, wenn das Geschäft wirklich immer nur eins oder zwei hat. Alles darüber sollte ein untergeordnetes Objekt sein: eine Übersetzung mit einer Sprache, ein Genehmigungsschritt mit einer genehmigenden Person. Die nächste Sprache oder der vierte Genehmiger wird ein neuer Datensatz, kein neues Feld mit einem Deployment.
Zweite Normalform: Beschreiben Sie das Ganze
Abschnitt betitelt „Zweite Normalform: Beschreiben Sie das Ganze “Die zweite Normalform, kurz 2NF, zählt, wenn ein Datensatz durch eine Kombination von Dingen identifiziert wird. Nehmen Sie die Lieferposition. Sie hat ihre eigene Datensatz-ID, aber jede ist eindeutig durch Lieferung + Produkt. Angenommen, wir speichern die Lieferung, das Produkt, die Menge und die Produktbeschreibung.
Die Menge ergibt hier Sinn: Sie beschreibt dieses Produkt auf dieser Lieferung. Aber die Produktbeschreibung beschreibt nicht die Kombination; sie beschreibt das Produkt. Steht sie auf jeder Lieferposition, wiederholen wir sie jedes Mal, wenn dieses Kühlschrankmodell auf einem weiteren Lastwagen rausgeht. Das ist der Hinweis, dass die Tatsache woanders hingehört.
Die Frage der 2NF lautet also: Beschreibt dieses Attribut das Ganze, das ich identifiziere, oder nur einen Teil davon? Beschreibt es nur das Produkt, gehört es zum Produkt. Beschreibt es den Platz des Produkts auf genau dieser Lieferung (die Menge, ob es installiert wird), gehört es zur Lieferposition. Viele in der Administration werden nie bewusst sagen: «Jetzt wende ich die zweite Normalform an.» Das ist in Ordnung. Mir ist viel wichtiger, dass Sie lernen zu fragen: Was beschreibt diese Tatsache eigentlich?
Dritte Normalform: Speichern Sie keine Tatsachen über andere Tatsachen
Abschnitt betitelt „Dritte Normalform: Speichern Sie keine Tatsachen über andere Tatsachen “Jetzt die, die mir für das alltägliche Modellieren am wichtigsten ist: die dritte Normalform, kurz 3NF.
Jedes Verteilzentrum hat auf der Seite des Handelspartners eine Leitung, jemanden, der das Partnerportal nutzt. Angenommen, wir setzen den Namen der VZ-Leitung direkt auf jede Lieferung. Was passiert, wenn das Verteilzentrum eine neue Leitung bekommt? Wir aktualisieren jede Lieferung aus diesem Verteilzentrum. Das ist wieder der Geruch: Wir wiederholen eine Tatsache, die woanders hingehört. Die Lieferung geht von einem Verteilzentrum ab; das Verteilzentrum hat eine Leitung. Das sind zwei Beziehungen, und der Name der Leitung gehört zum Verteilzentrum.
Die klassische Lehrbuchversion ist die Adresse: Postleitzahl, Stadt und Bundesland zusammen auf jedem Datensatz gespeichert, wenn Stadt und Bundesland meist aus der Postleitzahl folgen. Dieselbe Form, dieselbe Frage.
Die praktische Frage der 3NF lautet: Beschreibt diese Tatsache dieses Ding oder etwas anderes, mit dem dieses Ding zusammenhängt? Ich möchte, dass Sie sie ständig stellen.
Treten Sie jetzt einen Schritt zurück, genauso wie bei den Hunden. Aus der Liefertabelle, mit der wir begonnen haben, sind fünf Dinge geworden, jedes mit seinen eigenen Tatsachen: Die Lieferposition kam bei der ersten Normalform heraus, das Produkt bei der zweiten, und Stadt und Leitung des Verteilzentrums wanderten bei der dritten zum Verteilzentrum.
Dieselben drei Fragen, dasselbe Ergebnis: jede Tatsache an einer Stelle.
Eine einfache Art, über 1NF, 2NF und 3NF nachzudenken
Abschnitt betitelt „Eine einfache Art, über 1NF, 2NF und 3NF nachzudenken “Man kann einen ganzen Datenbankkurs mit Normalisierung füllen. Das tun wir nicht. Für diesen Kurs möchte ich, dass Sie ein praktisches Verständnis aus Sicht der Architektur haben:
- 1NF: Verstecke ich mehrere Werte oder sich wiederholende Strukturen in einem Feld oder einem Datensatz?
- 2NF: Beschreibt diese Tatsache das Ganze, das ich identifiziere?
- 3NF: Beschreibt diese Tatsache wirklich diese Entität oder etwas, das mit ihr zusammenhängt?
Das sind keine Definitionen für ein Datenbanklehrbuch. Es sind Fragen, die ich beim Entwerfen tatsächlich verwenden kann.
Ja, die Normalisierung geht weiter: Die Boyce-Codd-Normalform (BCNF) verschärft die Regeln der 3NF für Modelle mit komplizierteren Schlüsseln, und es gibt eine vierte, fünfte und sogar sechste Normalform. Sie behandeln seltenere Arten von Wiederholung, die eher aus ungewöhnlichen Schlüsselstrukturen entstehen als aus alltäglichen Geschäftsdatensätzen. Viel Theorie, und nach meiner Erfahrung den Aufwand nicht wert für die Art von Systemen, die wir auf Salesforce bauen. In Geschäftssystemen geht der Druck meist in die andere Richtung: Viel wahrscheinlicher rudern wir von der dritten Normalform zurück, für Benutzer, Berichte und Leistung, als dass wir darüber hinausgehen. Das ist das nächste Modul. Wissen Sie, dass es die weiteren Formen gibt, aber für das meiste, was wir tun, geben uns 1NF bis 3NF die Denkwerkzeuge, die wir brauchen.
Auf die dritte Normalform hin entwerfen
Abschnitt betitelt „Auf die dritte Normalform hin entwerfen “Das ist meine Position. Wenn ich versuche, ein Geschäft zu verstehen und sein logisches Modell zu entwerfen, möchte ich sauber beginnen: Tatsachen der Lieferung bei der Lieferung, Tatsachen des Verteilzentrums beim Verteilzentrum, Tatsachen des Lastwagens beim Lastwagen, sich wiederholende Konzepte als Konzepte modelliert. Ich möchte nicht, dass eine Geschäftstatsache durchs ganze Modell kopiert wird, nur weil sie einen Bildschirm oder einen Bericht einfacher machen könnte. Noch nicht.
Aber Normalisierung ist keine Religion. Das Ziel ist nicht das akademisch reinste Modell. Ich habe in der Architektur Leute gesehen, die sich so auf Reinheit konzentrierten, dass das Modell für alle, die damit arbeiten müssen, zur Qual wurde. Wir wollen keinen Normalisierungswettbewerb gewinnen; wir bauen ein System, und dieses System hat Nutzende, Berichte, Integrationen, Leistungsanforderungen, Volumen und zunehmend KI, die die Daten liest. Die wollen die Daten vielleicht in anderen Formen.
Mein Ausgangspunkt ist also: Entwerfen Sie bis zur dritten Normalform, wo es machbar ist, und rudern Sie zurück, wo es nötig ist: Verstehen Sie zuerst, wohin jede Tatsache gehört. Wenn wir dann davon abweichen, möchte ich wissen, warum. Lautet die Antwort «Weil ich nicht wusste, wohin sonst mit dem Feld», reicht das nicht. Lautet sie «Wir haben diesen Wert bewusst kopiert, weil er die Partner-Scorecard einfach macht, und wir haben einen verlässlichen Weg, ihn synchron zu halten», dann führen wir ein Architekturgespräch.
Was Architekt:innen hier entscheiden
Abschnitt betitelt „Was Architekt:innen hier entscheiden “Wenn ich ein logisches Modell normalisiere, suche ich nach:
- Sich wiederholenden Werten oder Strukturen, die separat modelliert werden sollten.
- Attributen, die eine andere Entität beschreiben als die, auf der sie gespeichert sind.
- Tatsachen, die unnötig über viele Datensätze dupliziert sind, und den Abhängigkeiten, durch die sie inkonsistent werden.
- Geschäftskonzepten, die in Feldern versteckt sind.
- Einem sauberen Modell, das die Wahrheit abbildet, bevor irgendwelche Kompromisse bei der Umsetzung gemacht werden.
Nicht, weil jedes physische System perfekt normalisiert bleiben muss. Ganz im Gegenteil. Im nächsten Modul weichen wir bewusst vom sauberen Modell ab, für Benutzer, Berichte, Volumen, Analysen und KI, und wir tun es in dem Wissen, was wir dafür aufgeben.