
Waar staan deze gegevens?
Ook beschikbaar in 28 talen
English · Español · 日本語 · Português (Brasil) · Français · Deutsch · Italiano · 한국어 · 简体中文 · Português (Portugal) · 繁體中文 · Bahasa Indonesia · Türkçe · Polski · Tiếng Việt · ไทย · العربية · עברית · Українська · हिन्दी · Русский · Svenska · Dansk · Norsk bokmål · Suomi · Español (México) · Français (Canada) · Deutsch (Schweiz)
Module 4 van 10 in het hoofdstuk Salesforce-data-architectuur, hoofdstuk 3 van de cursus Data Architect. Elke module staat op zichzelf. Vorige: Bouw je eigen: aangepaste objecten · Volgende: Kies het juiste object
De vraag die deze module beantwoordt: waar horen deze gegevens eigenlijk, voordat je een object aanmaakt: in de core in Salesforce, verwezen waar ze al staan, of gearchiveerd?
Laat me je een vraag stellen. Er komt een nieuwe eis op je bureau. Wat doe je als eerste?
Als je bent zoals de meesten van ons, open je Setup en maak je een aangepast object. Ik snap het. In tien minuten heb je een tabblad, een page layout en een list view. En dit vertel ik elke klas: op het moment dat je dat nieuwe object maakt, denk je al als een architect, of je dat nu bedoelde of niet. Want elk object dat je maakt is een verplichting. Het neemt opslag in. Het krijgt limieten. Het krijgt een sharingmodel, of je er nu een ontwierp of niet. Het heeft een licentie nodig voor iedereen die het aanraakt. En zodra mensen en integraties ervan afhangen: succes met weghalen.
De eerste architectuurbeslissing is dus niet welk object. Het is waar horen deze gegevens? Als je dat goed hebt, kiest het objecttype zichzelf bijna.
In de core en buiten de core
Section titled “In de core en buiten de core ”Eerst een woord dat ik vaak ga gebruiken: core. De core is het Salesforce-platform waarop je org draait: het metadatagestuurde, multitenant platform uit module 1, waar de sales- en serviceobjecten uit module 2 staan, en elk aangepast object dat je in module 3 bouwt. Als ik zeg dat data in de core staat, bedoel ik dat ze in je org is opgeslagen, in de objecten ervan.
Niet alle data staat daar. Data 360 bewaart zijn data in een eigen opslag, buiten de objecten van je org (het is near-core, dicht bij de core: beheerd in de core, met de data gehost buiten de core; meer in hoofdstuk 4). En dan is er alles wat je bedrijf draait dat helemaal geen Salesforce is: het ERP, het magazijn, het ordersysteem, het platform van de partner. Dat staat allemaal buiten de core. Salesforce kan erbij, kan het tonen en gebruiken, maar je org slaat het niet op.
In de core zijn er twee soorten objecten die echt je records bevatten: sObjects, standaard en aangepast (__c), en big objects (__b). Buiten de core bereik je data via externe objecten (__x) en de andere integratietools. Houd die achtervoegsels uit module 3 in gedachten; ze vertellen je alleen al aan de naam waar een stuk data staat.
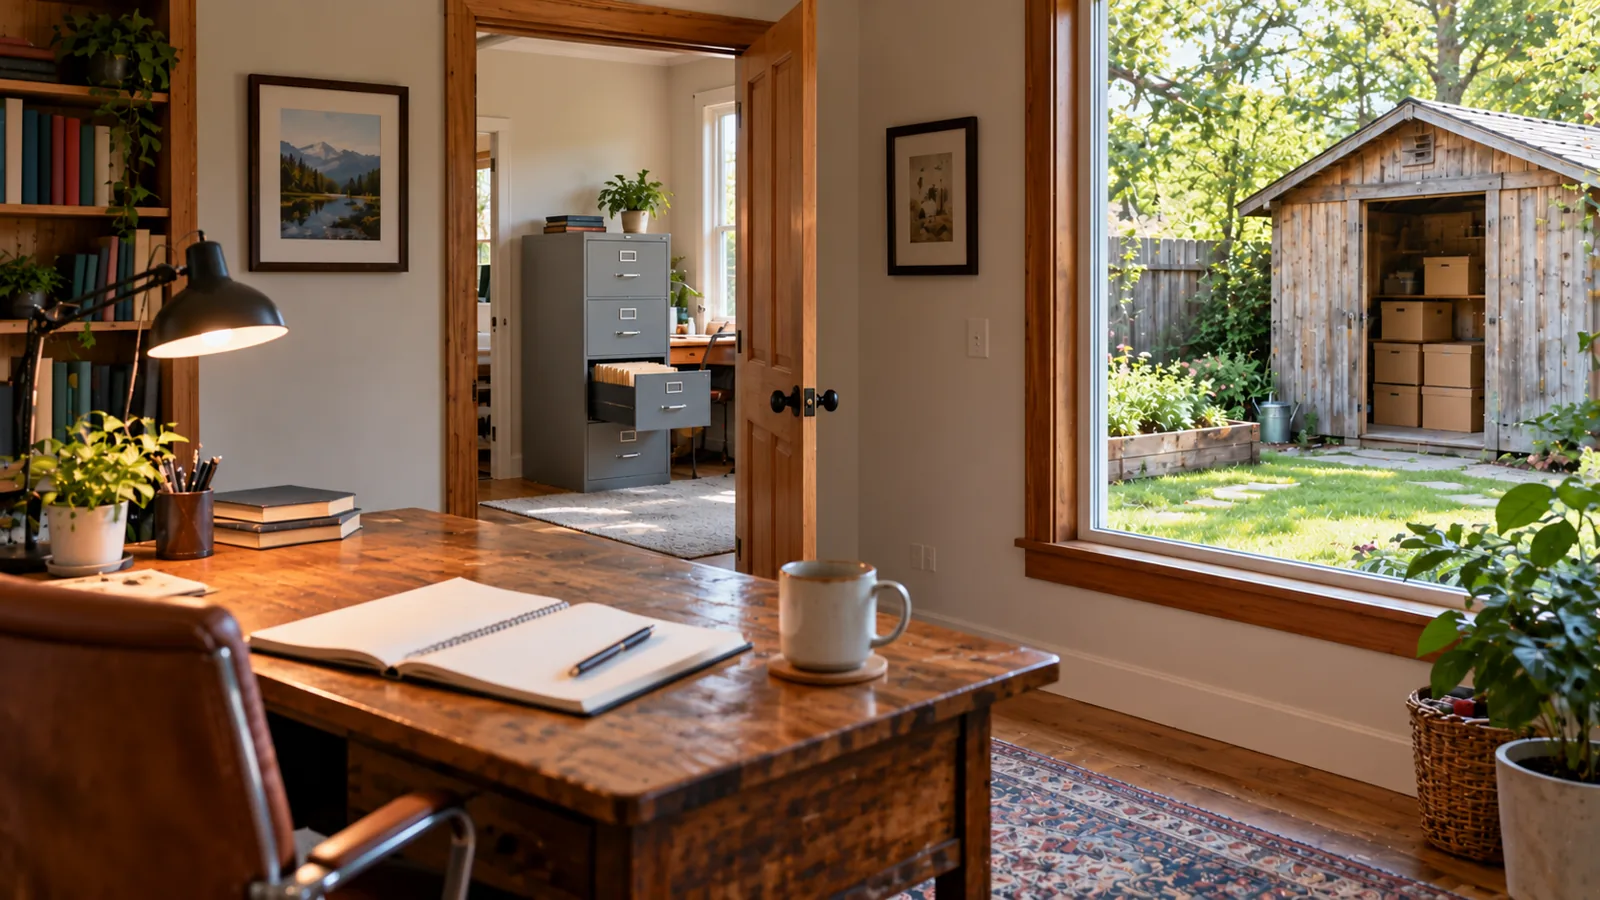
Ik zie het als een kantoor. Sommige dingen horen op je bureau, waar je ze elke dag gebruikt. Sommige dingen hoef je alleen op te zoeken in de archiefkast van iemand anders. En sommige dingen gaan in dozen naar de schuur achter het huis. Dat geeft me drie antwoorden.
1. In de core: het staat op je bureau
Section titled “1. In de core: het staat op je bureau ”De data wordt elke dag in Salesforce aangemaakt, gewijzigd en gebruikt: accounts, cases, verkoopkansen, werkorders. Het in sObjects bewaren is als het voor in je kantoor houden. Daar zijn standaard- en aangepaste objecten voor, en je krijgt alles: pagina-indelingen, delen, automatisering, rapportage, zoeken, en nu ook de AI-functies die op het datamodel gebouwd zijn.
Je bureau is wel niet gratis. Data in de core kost opslag, geteld zoals Salesforce het telt, record voor record, niet kolom voor kolom, en documenten tellen apart mee voor bestandsopslag. Beide behandelden we in module 2. Grote hoeveelheden foto’s en scans horen vaak buiten de core, met alleen een link in Salesforce.
2. Verwezen: het staat in de archiefkast van iemand anders
Section titled “2. Verwezen: het staat in de archiefkast van iemand anders ”De data hoort bij een ander systeem (het ERP, een datawarehouse, een orderplatform), en dat systeem blijft de bron van waarheid. Gebruikers moeten haar in Salesforce zien, misschien aan een record relateren, maar Salesforce heeft geen eigen kopie nodig. Je hoort dit ook virtuele data noemen: ze verschijnt virtueel in Salesforce, zonder er ooit opgeslagen te worden.
Dat zijn externe objecten, via Salesforce Connect. Ik zeg graag: het ziet eruit als een eend en loopt als een eend, maar het is geen eend. Het verschijnt als een sObject: je kunt het op pagina-indelingen en gerelateerde lijsten zetten, en het aan je eigen records relateren met externe en indirecte lookups. Maar de data staat niet in de core. Elke keer dat je het aanraakt, maakt het een callout. Open een record, laad een gerelateerde lijst, draai een rapport, en Salesforce gaat het andere systeem vragen. Dat betekent vertraging, en je pagina is maar zo beschikbaar als het systeem erachter.
Mensen sputteren tegen over de licentiekosten, dus reken het uit zoals ik in de klas doe. Connect wordt gelicentieerd per endpoint, en één endpoint kan veel objecten binnenhalen. Vraag nu wat het kost om het alternatief te bouwen en te onderhouden: een aangepast component, de calloutcode erachter, en een developer van dienst als het stukgaat. Vaak is de licentie goedkoper, en je admins kunnen het configureren zonder een regel code te schrijven. Waar het tekortschiet: data die je gebruikers de hele dag bewerken, of waar ze veel over rapporteren.
Ook naar documenten kun je verwijzen. Als een contract al in SharePoint Online, OneDrive, Google Drive of Box staat, laat Files Connect gebruikers er vanuit Salesforce bij zonder het naar binnen te kopiëren.
Salesforce Connect is niet de enige manier om naar data te verwijzen. Soms is het eigen logica (custom logic): code die het andere systeem in realtime aanroept en de data ervan op de pagina toont, zonder dat er een kopie bewaard wordt. Dat geeft je volledige controle, en volledige verantwoordelijkheid voor de callout, de fouten en het onderhoud. En Data 360 kan ook federeren zonder te kopiëren. Die keuze heeft een eigen hoofdstuk (Virtualisatie, federatie en zero-copy). Hier gaat het om de beslissing zelf: verwijs, kopieer niet.
3. Gearchiveerd: het gaat naar de schuur achter het huis
Section titled “3. Gearchiveerd: het gaat naar de schuur achter het huis ”Historie, audittrails, oude transacties. Je moet het bewaren, soms jarenlang, maar bijna niemand opent het. En dit is degene die teams voor zich uit schuiven. Als een klas me vertelt dat ze een object met 50 miljoen records hebben en vraagt waarom ze zouden archiveren, vraag ik terug: als je vandaag niet archiveert, ga je dan ooit archiveren? Met 50 miljoen vandaag ga je richting 100, 150, 200 miljoen.
Er zijn twee schuren. De ene staat in de core: big objects. Zie ze als data opslaan in de garage. Je kunt een enorm aantal records opslaan, maar je kunt ze niet op een pagina-indeling zetten, er is geen standaard-UI of rapportage, en je bevraagt ze via de index van het big object, op exacte match of bereik (Big Objects Best Practices (opens in a new tab), Engels). Beveiliging is alleen object- en veldrechten, zonder delen op recordniveau, en automatisering draait er niet op. Ik heb Salesforce Connect tientallen keren gebruikt en big objects maar een of twee keer. Ze werken, maar ze zijn onhandig, en ik heb mijn portie omwegen geschreven om bij de data te komen. Mijn advies dus: maak een prototype voordat je het voorstelt, en plan hoe mensen de data gaan vinden voordat je het kiest.
De andere schuur staat buiten de core: een warehouse of een database ergens anders (Ontwerpen voor schaal). Vaak is dat de betere schuur, en die hoeft niet uit het zicht te zijn. Gearchiveerde data buiten de core kan nog steeds in rapporten verschijnen via tools als Tableau, en kan nog steeds bereikbaar zijn vanuit Salesforce, via Salesforce Connect of een andere manier van virtualiseren, als iemand terug moet kijken.
Laat me je vertellen over een project waar we dit vanaf het begin goed deden. Een retailklant had meer dan 1.200 locaties. Ze zeiden tegen me: “We doen maar honderd afspraken per dag per winkel. Niks bijzonders.” Toen rekende ik het uit: honderd per dag, zes dagen per week (ongeveer 305 dagen per jaar), over 1.200 locaties, is meer dan 36 miljoen afspraken per jaar. Toen vertelden ze dat elk bezoek twee afspraken aanmaakte, één aan de balie en één voor de werkplaats achterin: meer dan 73 miljoen records per jaar. Toen wilden ze vijf jaar historie: meer dan 360 miljoen records, nog vóór enige groei. We waren nog niet live, en ik zag de trein al recht op het station van de grote datavolumes afstormen. Dus werd het archief gebouwd voordat we één afspraak hadden verzameld: oudere afspraken gingen naar big objects, en het zoekscherm toonde de huidige afspraken met de gearchiveerde direct eronder. Jaren later draait het nog steeds prima.
In de praktijk: Steve Trucking
Section titled “In de praktijk: Steve Trucking ”Steve Trucking is ons doorlopende scenario: een familiebedrijf voor bezorging op de laatste kilometer dat witgoed en elektronica ophaalt bij de distributiecentra van grote winkelketens en het bij klanten thuis aflevert en installeert. Vier soorten data, drie antwoorden:
| Data | Waar het staat | Waarom |
|---|---|---|
| De leveringen, ploegen en afspraken van vandaag | In de core | Planners en ploegen werken er de hele dag in |
| De orderdetails van de retailer | Verwezen (of een dunne kopie in de core) | Het systeem van de retailer is de bron van waarheid |
| Leveringshistorie van drie jaar geleden | Gearchiveerd | Bewaard voor claims en trends; bijna niemand opent het |
| Leveringsfoto’s | Buiten de core, gelinkt | Duizenden per dag; opgeslagen buiten Salesforce met een link op de levering |
Hier is hetzelfde als datamodel. De levering staat in de core, waar mensen er de hele dag in werken. Na drie jaar verhuist ze naar Delivery History, een big object: nog steeds in de core, maar in de schuur. De order van de partner verschijnt als een extern object, __x: Salesforce relateert de levering eraan, maar de data blijft in het systeem van de retailer. En de foto’s staan helemaal buiten de core, met een link vanaf de levering. Eén model, drie thuishavens.
Elke echte org heeft alle drie. De orgs die in de problemen komen, zetten alles in de core, omdat een object aanmaken de standaardknop was.
Wat een architect hier beslist
Section titled “Wat een architect hier beslist ”- De plek voor elk soort data, voordat er een object ontworpen wordt: in de core, verwezen of gearchiveerd.
- De bron van waarheid. Als een ander systeem eigenaar is van de data, moet Salesforce niet stilletjes een tweede master worden.
- Het toegangspad voor alles buiten de core. Verwezen data heeft een beschikbare bron en acceptabele vertraging nodig; gearchiveerde data heeft een manier nodig waarop mensen haar kunnen vinden.
- De groei van de opslag. Reken het nu uit (records per dag, maal groei, maal bewaartermijn), niet pas als de opslagwaarschuwing komt.
Voorbij het examen: AI verhoogt de inzet bij “in de core”. AI-functies en agents werken het best op data die het platform begrijpt: data in standaard- en aangepaste objecten, goed benoemd en goed beschreven. Dat trekt richting meer in de core zetten. Weersta dat voor de verkeerde data. Een agent die gegrond is op een verouderde kopie van ERP-data geeft stellige, foute antwoorden. Vaak is het betere besluit naar de live bron te verwijzen, of een kleine, goed beschreven uitsnede in de core te houden. Waar AI de data leest, is nu deel van beslissen waar de data staat.
Verder lezen
Section titled “Verder lezen ”- Big Objects Best Practices (opens in a new tab), Salesforce Developers (Engels, gecontroleerd op 2026-09-25)
- Files Connect FAQ (opens in a new tab), Salesforce Help (Engels, gecontroleerd op 2026-09-25)
- In deze cursus: Virtualisatie, federatie en zero-copy en Ontwerpen voor schaal