
Zet data waar die hoort
Ook beschikbaar in 28 talen
English · Español · 日本語 · Português (Brasil) · Français · Deutsch · Italiano · 한국어 · 简体中文 · Português (Portugal) · 繁體中文 · Bahasa Indonesia · Türkçe · Polski · Tiếng Việt · ไทย · العربية · עברית · Українська · हिन्दी · Русский · Svenska · Dansk · Norsk bokmål · Suomi · Español (México) · Français (Canada) · Deutsch (Schweiz)
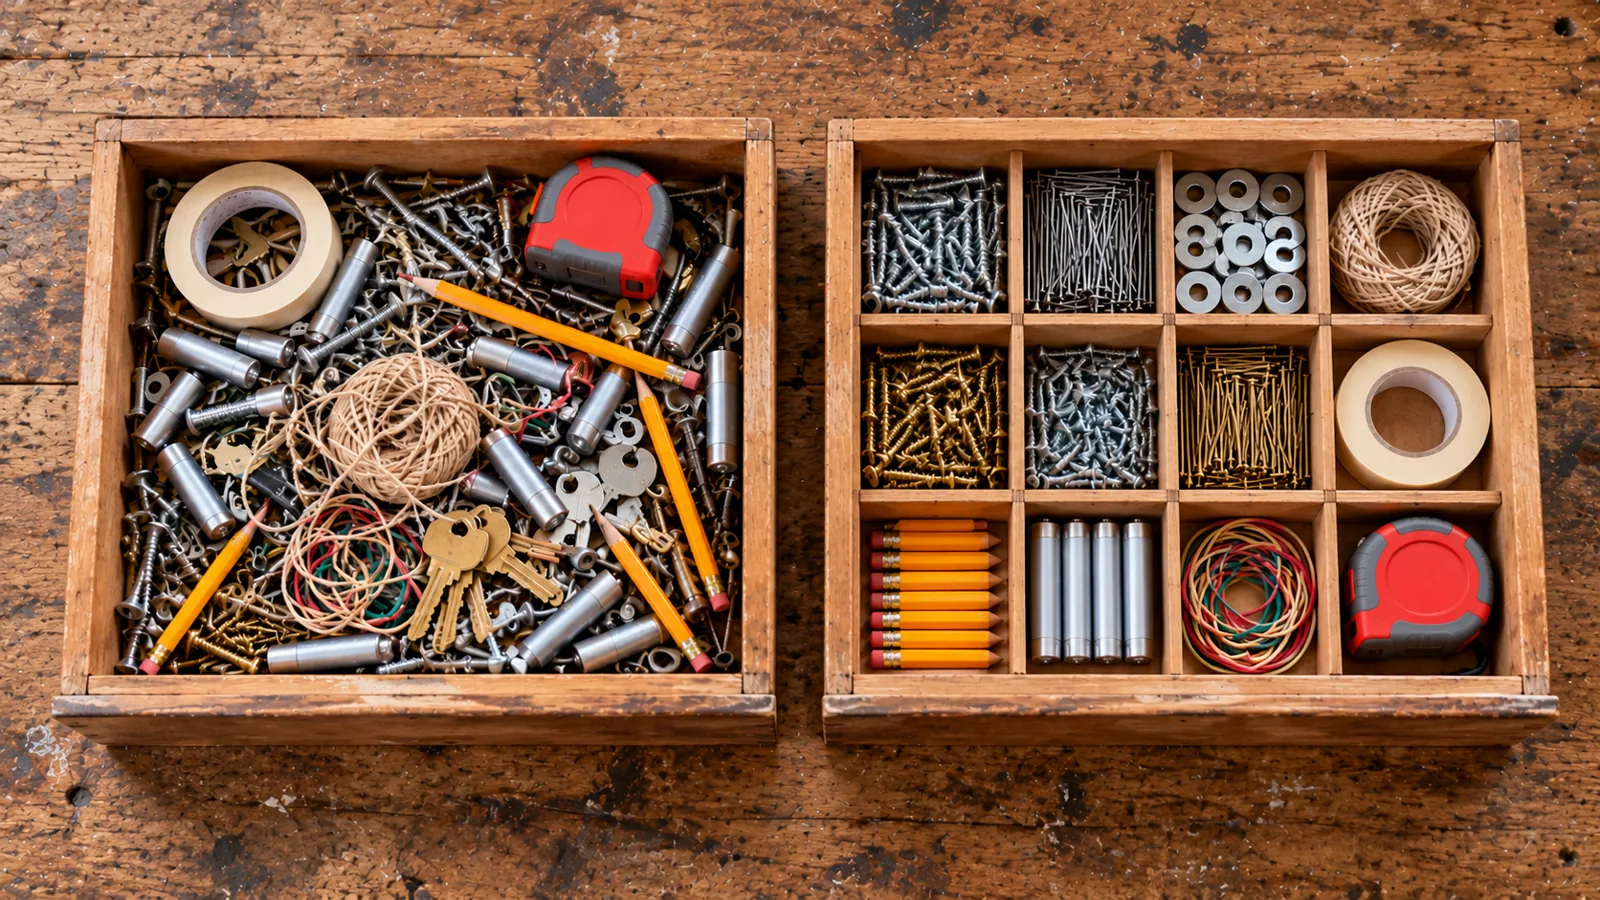
Module 4 van 6 in het hoofdstuk Data modelleren naar betekenis, hoofdstuk 2 van de cursus Data Architect. Elke module staat op zichzelf. Vorige: Bouw het logische model · Volgende: Ontwerp tot de derde normaalvorm en doe dan een stap terug
De vraag die deze module beantwoordt: Hoe helpt normalisatie me uit te zoeken waar data echt thuishoort?
We hebben een logisch model: entiteiten, relaties, attributen en sleutels. Nu wil ik een van de belangrijkste vragen in datamodellering stellen: hoort deze data hier eigenlijk wel?
Dat klinkt simpel. Dat is het niet. Ik heb genoeg systemen gezien waar elk veld logisch was op het moment dat iemand het aanmaakte. Het probleem was niet dat de velden belachelijk waren; het probleem was dat de feiten op de verkeerde plek stonden. Een levering bevat informatie die eigenlijk een distributiecentrum beschrijft. Hetzelfde adres staat op honderden records. Eén veld bevat drie waarden, gescheiden door komma’s. Eén bedrijfsfeit wijzigen betekent 10.000 records bijwerken. Dat is het probleem dat normalisatie ons helpt oplossen, en voordat we bedolven raken onder databaseterminologie, hier is het hele idee: zet een feit waar het hoort. Al het andere in deze module helpt ons dat systematischer te doen.
Wat is normalisatie?
Section titled “Wat is normalisatie? ”Normalisatie is data zo organiseren dat elk feit één keer wordt opgeslagen, op de plek waar het hoort. Als één tabel te veel taken heeft, splitsen we die op in tabellen die elk één ding beschrijven, en verbinden we ze met sleutels.
Waarom zou je de moeite nemen? Omdat een feit dat één keer is opgeslagen een feit is dat we één keer wijzigen. Normalisatie voorkomt redundantie, hetzelfde feit gekopieerd over veel records, en daarmee de inconsistenties die binnensluipen als één kopie wordt bijgewerkt en de andere niet. Daarom past het bij transactionele systemen zoals Salesforce, waar de hele dag records worden aangemaakt en bijgewerkt.
We normaliseren in stappen die normaalvormen heten, en elke stap stelt één vraag:
- Eerste normaalvorm (1NF): één waarde per veld, en iets dat elke rij uniek identificeert.
- Tweede normaalvorm (2NF): elk feit beschrijft het geheel van wat de rij identificeert, niet maar een deel ervan.
- Derde normaalvorm (3NF): elk feit beschrijft dit ding, niet iets anders waar het mee verbonden is.
Er zijn meer vormen na de derde. Daar zeg ik later iets over, en over waarom we meestal bij de derde stoppen. Laten we eerst de drie stappen zien gebeuren.
Waarom normaliseren we?
Section titled “Waarom normaliseren we? ”Als ik dit live geef, begin ik niet met leveringen. Ik begin met honden. Iedereen begrijpt honden, dus niemand wordt afgeleid door de business, en we kunnen zien hoe de data zijn thuis probeert te vinden. Daarna zetten we dezelfde stappen bij Steve Trucking.
Zit, Blijf, Modelleer
Section titled “Zit, Blijf, Modelleer ”Start: de ruwe spreadsheet. Ik zet een paar honden op het scherm, en daarna voegt de zaal die van hen toe. Binnen een paar minuten hebben we één grote lijst: de hond, het geboortejaar, wie de eigenaar is, waar de eigenaar woont, het ras, wie hem gefokt heeft, en de kunstjes die hij kent.
| Hond | Geboren | Eigenaar | Postcode | Plaats | Ras | Fokker | Kunstjes |
|---|---|---|---|---|---|---|---|
| Bella | 2017 | Marcus | 80202 | Denver | Labrador | Maple Ridge | Zit, Blijf, Pootje |
| Milo | 2019 | Marcus | 80202 | Denver | Poedel | Golden Meadow | Zit, Rol |
| Max | 2022 | Ana | 64105 | Kansas City | Kruising | Zit, Dood | |
| Luna | 2020 | Kenji | 98101 | Seattle | Husky | Cascade | Zit, Blijf, Draai |
| Rocky | 2024 | Priya | 30301 | Atlanta | Beagle | Maple Ridge | Zit |
| Coco | 2014 | Ana | 64105 | Kansas City | Chihuahua | Little Paws | Pootje, Draai |
Het werkt. Elke spreadsheet werkt op dag één. Maar kijk wat er nu al mis is. Hoe vind ik elke hond die Pootje kan? Ana’s postcode staat op twee rijen, en die van Marcus ook: wat gebeurt er als iemand de ene bijwerkt en de andere niet? Maple Ridge staat er twee keer in, en Kansas City ook. En Max komt uit het asiel, dus er is helemaal geen fokker.
Stap 1: eerste normaalvorm. Twee regels. Elk veld bevat één waarde, dus de kommalijst met kunstjes moet weg. En elke rij heeft iets nodig dat hem uniek identificeert. Niet de naam van de hond; er zijn heel veel honden die Max heten. Een ID: een automatisch gegenereerde ID of een GUID. De kunstjes gaan naar hun eigen rijen, één rij voor elke hond en elk kunstje. En zodra een kunstje een eigen rij heeft, is er ruimte voor wat we in een kommalijst nooit konden zeggen: hoe moeilijk het kunstje is, hoe goed deze hond het doet, en wanneer hij het geleerd heeft.
Hond (geïdentificeerd door Hond-ID)
| Hond-ID | Naam | Geboren | Eigenaar | Postcode | Plaats | Ras | Fokker |
|---|---|---|---|---|---|---|---|
| D-001 | Bella | 2017 | Marcus | 80202 | Denver | Labrador | Maple Ridge |
| D-002 | Milo | 2019 | Marcus | 80202 | Denver | Poedel | Golden Meadow |
| D-003 | Max | 2022 | Ana | 64105 | Kansas City | Kruising | |
| D-004 | Luna | 2020 | Kenji | 98101 | Seattle | Husky | Cascade |
| D-005 | Rocky | 2024 | Priya | 30301 | Atlanta | Beagle | Maple Ridge |
| D-006 | Coco | 2014 | Ana | 64105 | Kansas City | Chihuahua | Little Paws |
Hondkunstje (geïdentificeerd door Hond-ID + Kunstje)
| Hond-ID | Kunstje | Moeilijkheid | Vaardigheidsniveau | Geleerd |
|---|---|---|---|---|
| D-001 | Zit | Makkelijk | Expert | 2017-11 |
| D-001 | Blijf | Makkelijk | Expert | 2018-01 |
| D-001 | Pootje | Gemiddeld | Goed | 2018-06 |
| D-002 | Zit | Makkelijk | Expert | 2020-02 |
| D-002 | Rol | Moeilijk | Leert nog | 2023-05 |
| D-003 | Zit | Makkelijk | Goed | 2022-06 |
| D-003 | Dood | Moeilijk | Leert nog | 2024-03 |
| D-004 | Zit | Makkelijk | Expert | 2020-11 |
| D-004 | Blijf | Makkelijk | Goed | 2021-01 |
| D-004 | Draai | Gemiddeld | Expert | 2021-06 |
| D-005 | Zit | Makkelijk | Leert nog | 2025-02 |
| D-006 | Pootje | Gemiddeld | Expert | 2015-06 |
| D-006 | Draai | Gemiddeld | Leert nog | 2025-04 |
Nu is “elke hond die Pootje kan” een simpele vraag. Maar kijk waardoor Hondkunstje wordt geïdentificeerd: niet door één ding, maar door twee dingen samen, de hond en het kunstje. Onthoud dat.
Stap 2: tweede normaalvorm. De tweede normaalvorm doet er alleen toe als een rij wordt geïdentificeerd door een combinatie, en dat is bij Hondkunstje zo. Dus vraag ik bij elke kolom: beschrijft hij de hele combinatie, of maar een deel ervan? Vaardigheidsniveau beschrijft deze hond die dit kunstje doet: Bella is expert in Zit, Rocky leert het nog. Geleerd: hetzelfde. Maar Moeilijkheid? Zit is makkelijk, welke hond het ook doet. Het beschrijft het kunstje, maar een deel van de sleutel, en daarom staat “Makkelijk” op elke Zit-rij herhaald. Dus krijgt het kunstje een eigen tabel, en wat overblijft is het paar.
Kunstje
| Kunstje-ID | Kunstje | Moeilijkheid |
|---|---|---|
| T-01 | Zit | Makkelijk |
| T-02 | Blijf | Makkelijk |
| T-03 | Pootje | Gemiddeld |
| T-04 | Rol | Moeilijk |
| T-05 | Dood | Moeilijk |
| T-06 | Draai | Gemiddeld |
Hondkunstje (Hond-ID + Kunstje-ID)
| Hond-ID | Kunstje-ID | Vaardigheidsniveau | Geleerd |
|---|---|---|---|
| D-001 | T-01 | Expert | 2017-11 |
| D-001 | T-02 | Expert | 2018-01 |
| D-001 | T-03 | Goed | 2018-06 |
| D-002 | T-01 | Expert | 2020-02 |
| D-002 | T-04 | Leert nog | 2023-05 |
| D-003 | T-01 | Goed | 2022-06 |
| D-003 | T-05 | Leert nog | 2024-03 |
| D-004 | T-01 | Expert | 2020-11 |
| D-004 | T-02 | Goed | 2021-01 |
| D-004 | T-06 | Expert | 2021-06 |
| D-005 | T-01 | Leert nog | 2025-02 |
| D-006 | T-03 | Expert | 2015-06 |
| D-006 | T-06 | Leert nog | 2025-04 |
Die tabel Hondkunstje is dezelfde die we in module 2 vonden, en hij heeft een naam in datamodellering: een koppeling (junction), of zoals ik het noem, een logisch koppelobject. Een hond kent veel kunstjes; een kunstje wordt door veel honden gekend. Het koppelobject zit ertussen, en het is geen leeg buizenwerk: het bevat de feiten die bij de relatie zelf horen, het vaardigheidsniveau en de datum. We komen het weer tegen in module 6, en in hoofdstuk 3 zien we dat Salesforce “koppelobject” (junction object) nauwer gebruikt: een Salesforce-koppelobject (Salesforce Junction Object) is een aangepast object met twee hoofd-detailrelaties (hoofdstuk 3, module 7).
Stap 3: derde normaalvorm. Nu terug naar de tabel Hond. Alles daarin wordt geïdentificeerd door de Hond-ID, dus de tweede normaalvorm heeft niets te zeggen. De derde normaalvorm stelt een andere vraag: beschrijft dit feit de hond, of iets anders waar de hond mee verbonden is? Het ras is een ding op zich: een labrador is een labrador, welke hond het ook is, en feiten erover, zoals de grootte, horen bij het ras, niet bij Bella. De postcode en de plaats beschrijven de eigenaar, niet de hond: daar woont Ana, naar welke van haar honden we ook kijken. De gegevens van de fokker beschrijven de fokker. Elk daarvan is een feit over een ander feit, dus elk verhuist naar een eigen tabel, en de hond wijst ernaar met een vreemde sleutel (foreign key):
- Hond: Hond-ID, Naam, Geboren, Eigenaar-ID, Ras-ID, Fokker-ID
- Eigenaar: Eigenaar-ID, Naam, Postcode, Plaats
- Ras: Ras-ID, Ras, Grootte
- Fokker: Fokker-ID, Naam, Plaats
- Kunstje en Hondkunstje, uit stap 2
Ana staat nu één keer opgeslagen, en haar beide honden wijzen naar haar. Maple Ridge staat één keer opgeslagen, en de tabel Ras geeft ons een thuis voor feiten over elk ras, zoals de grootte, waar de spreadsheet geen plek voor had. Een vreemde sleutel mag leeg zijn: Max heeft geen Fokker-ID, en dat is een eerlijk antwoord, geen gat. Dan gooi ik een strikvraag naar de zaal: de datum waarop de eigenaar de hond kreeg, waar hoort die? Bij de hond. Een hond heeft in dit model één eigenaar tegelijk, dus die datum beschrijft de relatie van de hond met zijn eigenaar.
Je zou nog een stap verder kunnen gaan en de plaats loskoppelen van de postcode; studieboeken doen dat. In de praktijk blijft een adres bij elkaar, en Kansas City ligt hoe dan ook in twee staten, een mooie herinnering dat de echte wereld onze studieboeken niet leest.
Dat is de opbouw: een spreadsheet, dan drie vragen, en elk feit komt op één plek terecht. Doe een stap terug en kijk wat we gebouwd hebben. Eén rommelige lijst werd zes tabellen, die elk één ding beschrijven, verbonden met sleutels:
Niemand had één Salesforce-woord nodig om dat te volgen. Het zijn gewoon de honden, de mensen om hen heen, en wat ze kunnen.
Laten we het nu toepassen op Steve Trucking
Section titled “Laten we het nu toepassen op Steve Trucking ”De honden maken de stappen makkelijk te zien. Een echt bedrijf maakt ze belangrijk, want dezelfde fouten kosten op schaal echt geld. Dus nemen we dezelfde drie vragen mee naar Steve Trucking. Stel je voor dat het zijn leveringen zo bijhoudt:
| Levering | Retailpartner | Distributiecentrum | Plaats DC | Bezorgploeg | Vrachtwagen |
|---|---|---|---|---|---|
| 1001 | Keystone | Keystone Phoenix DC | Phoenix | Ploeg 12 | 117 |
| 1002 | Keystone | Keystone Phoenix DC | Phoenix | Ploeg 8 | 122 |
| 1003 | Keystone | Keystone Phoenix DC | Phoenix | Ploeg 12 | 117 |
Op het eerste gezicht is hier niets ingewikkeld. Maar kijk naar het distributiecentrum. We herhalen “Keystone Phoenix DC, Phoenix” op elke levering die daar vertrekt: Steve Trucking doet ongeveer 3.300 leveringen per dag vanuit negen DC’s, dus een paar honderd per dag uit elk. Wat gebeurt er als dat DC verhuist? Hoeveel records wijzigen we, en wat gebeurt er als er één gemist wordt? Dan zegt de data dat het DC in twee plaatsen tegelijk staat. Dat is een update-anomalie. En als we een nieuw DC willen inrichten vóór de eerste levering? En als we de laatste levering van een DC verwijderen: hebben we dan net de enige plek verwijderd waar we iets over dat DC bewaarden?
Dit zijn verschillende symptomen van hetzelfde probleem: we hebben feiten over verschillende dingen door elkaar gehaald. Feiten over het distributiecentrum horen bij het distributiecentrum. Feiten over de levering horen bij de levering. Feiten over de ploeg horen bij de ploeg. Dat is normalisatie in de praktijk.
Eerste normaalvorm: verstop geen herhalende structuur
Section titled “Eerste normaalvorm: verstop geen herhalende structuur ”Laten we beginnen met de eerste normaalvorm, of 1NF, waar mensen normalisatie soms moeilijker maken dan nodig is.
Stel dat een levering een veld Artikelen heeft: “Koelkast, ijsmakerset, afvoer oud apparaat.” We hebben drie stukken informatie in één veld gestopt. Dat lijkt handig, tot iemand vraagt: “Hoeveel oude apparaten hebben we vorige maand afgevoerd?” Of stel je velden voor die Artikel 1, Artikel 2 en Artikel 3 heten. Dat werkt, tot de levering met vier artikelen. Het probleem is niet dat we het verkeerde aantal artikelvelden kozen. Het probleem is dat we de herhalende structuur niet herkenden. Een levering kan meerdere artikelen hebben. Dat is data die we moeten modelleren: het leveringsitem dat we in module 2 vonden.
De praktische les van 1NF: verstop geen herhalende structuur in velden. Als de business je vertelt dat iets vaak kan gebeuren, luister dan. Misschien probeert er een andere entiteit naar buiten te komen.
Je ziet dit voortdurend in echte orgs. Iemand heeft een beschrijving in meerdere talen nodig, dus maakt hij een veld Description_English aan, daarna Description_French, daarna Description_German. Of een goedkeuring heeft een paar mensen nodig, dus krijgen we Goedkeurder 1, Goedkeurder 2, Goedkeurder 3. Als ik dat in een review tegenkom, is het: tik op de vingers, repareer je datamodel. Eén of twee, misschien, als de business er echt altijd maar één of twee heeft. Alles daarboven hoort een child-object te zijn: een vertaling met een taal, een goedkeuringsstap met een goedkeurder. De volgende taal, of de vierde goedkeurder, wordt een nieuw record, geen nieuw veld plus een deployment.
Tweede normaalvorm: beschrijf het hele ding
Section titled “Tweede normaalvorm: beschrijf het hele ding ”De tweede normaalvorm, of 2NF, doet ertoe als een record wordt geïdentificeerd door een combinatie van dingen. Neem het leveringsitem. Het heeft een eigen record-ID, maar elk item is uniek door levering + product. Stel dat we de levering, het product, de hoeveelheid en de productbeschrijving opslaan.
Hoeveelheid hoort hier: die beschrijft dit product op deze levering. Maar de productbeschrijving beschrijft de combinatie niet; die beschrijft het product. Zet je hem op elk leveringsitem, dan herhalen we hem elke keer dat dat koelkastmodel op een andere vrachtwagen vertrekt. Dat is de aanwijzing dat het feit ergens anders hoort.
De 2NF-vraag is dus: beschrijft dit attribuut het hele ding dat ik identificeer, of maar een deel ervan? Als het alleen het product beschrijft, gaat het naar Product. Als het de plek van het product op deze specifieke levering beschrijft (de hoeveelheid, of het geïnstalleerd wordt), hoort het bij het leveringsitem. Veel admins zullen nooit bewust zeggen: “Nu pas ik de tweede normaalvorm toe.” Dat is prima. Ik vind het veel belangrijker dat je leert vragen: wat beschrijft dit feit eigenlijk?
Derde normaalvorm: sla geen feiten over andere feiten op
Section titled “Derde normaalvorm: sla geen feiten over andere feiten op ”Nu degene die ik voor dagelijks modelleren het belangrijkst vind: de derde normaalvorm, of 3NF.
Elk distributiecentrum heeft een manager aan de kant van de retailpartner, iemand die het partnerportaal gebruikt. Stel dat we de naam van de DC-manager direct op elke levering zetten. Wat gebeurt er als het DC een nieuwe manager krijgt? Dan werken we elke levering van dat DC bij. Daar is die geur weer: we herhalen een feit dat ergens anders hoort. De levering vertrekt vanuit een DC; het DC heeft een manager. Dat zijn twee relaties, en de naam van de manager hoort bij het DC.
De klassieke studieboekversie is het adres: postcode, plaats en staat samen opgeslagen op elk record, terwijl plaats en staat meestal uit de postcode volgen. Dezelfde vorm, dezelfde vraag.
De praktische 3NF-vraag is: beschrijft dit feit dit ding, of iets anders waar dit ding mee verbonden is? Ik wil dat je die vraag constant stelt.
Doe nu een stap terug, net als bij de honden. De leveringstabel waarmee we begonnen, is vijf dingen geworden, die elk hun eigen feiten bevatten: het leveringsitem kwam eruit bij de eerste normaalvorm, het product bij de tweede, en de plaats en manager van het distributiecentrum verhuisden bij de derde naar het distributiecentrum.
Dezelfde drie vragen, hetzelfde resultaat: elk feit op één plek.
Een simpele manier om naar 1NF, 2NF en 3NF te kijken
Section titled “Een simpele manier om naar 1NF, 2NF en 3NF te kijken ”Je kunt een hele databasecursus aan normalisatie besteden. Dat gaan we niet doen. Voor deze cursus wil ik dat je het begrip hebt van een architect die ermee werkt:
- 1NF: verstop ik meerdere waarden of herhalende structuren in een veld of een record?
- 2NF: beschrijft dit feit het hele ding dat ik identificeer?
- 3NF: beschrijft dit feit echt deze entiteit, of iets dat ermee verbonden is?
Dat zijn geen definities voor een databasestudieboek. Het zijn vragen die ik echt kan gebruiken terwijl ik ontwerp.
Ja, normalisatie gaat verder: de Boyce-Codd-normaalvorm (BCNF) scherpt de regels rond 3NF aan voor modellen met ingewikkeldere sleutels, en er zijn een vierde, vijfde en zelfs zesde normaalvorm. Die gaan over zeldzamere soorten herhaling, het soort dat eerder voortkomt uit ongebruikelijke sleutelstructuren dan uit alledaagse bedrijfsrecords. Veel theorie, en in mijn ervaring de hoofdpijn niet waard voor het soort systemen dat we op Salesforce bouwen. In bedrijfssystemen werkt de druk meestal de andere kant op: veel vaker doen we een stap terug van de derde normaalvorm, voor gebruikers, rapportage en prestaties, dan dat we eroverheen gaan. Dat is de volgende module. Weet dat de verdere vormen bestaan, maar voor het meeste wat we doen geven 1NF tot en met 3NF ons de denkgereedschappen die we nodig hebben.
Ontwerp tot de derde normaalvorm
Section titled “Ontwerp tot de derde normaalvorm ”Dit is mijn standpunt. Als ik een bedrijf probeer te begrijpen en zijn logische model ontwerp, wil ik schoon beginnen: leveringsfeiten bij de levering, feiten over het distributiecentrum bij het DC, vrachtwagenfeiten bij de vrachtwagen, herhalende concepten gemodelleerd als concepten. Ik wil niet dat een bedrijfsfeit overal in het model gekopieerd wordt alleen omdat een scherm of een rapport daar misschien makkelijker van wordt. Nog niet.
Maar normalisatie is geen religie. Het doel is niet het academisch zuiverst mogelijke model. Ik heb architecten zo gefocust zien raken op zuiverheid dat het model pijnlijk werd voor iedereen die ermee moest werken. We proberen geen normalisatiewedstrijd te winnen; we bouwen een systeem, en dat systeem heeft gebruikers, rapporten, integraties, prestatie-eisen, schaal en, steeds vaker, AI die de data leest. Die willen de data misschien in andere vormen.
Mijn startpunt is dus ontwerp tot de derde normaalvorm waar dat kan, en doe een stap terug waar dat nodig is: begrijp eerst waar elk feit hoort. Als we er daarna van afwijken, wil ik weten waarom. Als het antwoord is “omdat ik niet wist waar ik het veld anders moest zetten”, is dat niet goed genoeg. Als het antwoord is “we hebben deze waarde bewust gekopieerd omdat het de partnerscorekaart simpel maakt, en we hebben een betrouwbare manier om hem gesynchroniseerd te houden”, dan voeren we een architectuurgesprek.
Wat een architect hier beslist
Section titled “Wat een architect hier beslist ”Als ik een logisch model normaliseer, zoek ik naar:
- Herhalende waarden of structuren die apart gemodelleerd moeten worden.
- Attributen die een andere entiteit beschrijven dan die waarop ze zijn opgeslagen.
- Feiten die onnodig over veel records gedupliceerd zijn, en de afhankelijkheden waardoor ze inconsistent raken.
- Bedrijfsconcepten die in velden verstopt zitten.
- Een schoon model dat de waarheid weergeeft vóór enig compromis in de implementatie.
Niet omdat elk fysiek systeem perfect genormaliseerd moet blijven. Integendeel. In de volgende module wijken we bewust af van het schone model, voor gebruikers, rapportage, schaal, analyse en AI, en we doen het in de wetenschap van precies wat we inruilen.