
La modélisation des données selon Steve : des listes de sélection vers l'infini et au-delà
Introduction :
Bienvenue dans une nouvelle séance de la série Steve’s Data Modeling ! Dans cet article, nous allons explorer les usages variés des listes de sélection et voir dans quels cas envisager des alternatives pour des besoins de modélisation plus avancés.
Comprendre les listes de sélection
Les listes de sélection sont idéales pour un champ qui demande un ensemble de valeurs fixes. Elles offrent une expérience utilisateur propre, mais ont quelques limites :
- Il faut des droits d’administration élevés pour ajouter des valeurs.
- Les nouvelles valeurs doivent être déployées en passant par les sandboxes.
Des erreurs de validation surviennent si des valeurs venant d’intégrations tierces n’ont pas été ajoutées au préalable dans Salesforce.
Explorer les options de listes de sélection
Voici quelques options à envisager :
Option 1 : ensembles de valeurs globaux
C’est l’option standard de Salesforce, qui permet de réutiliser des listes d’un objet à l’autre.
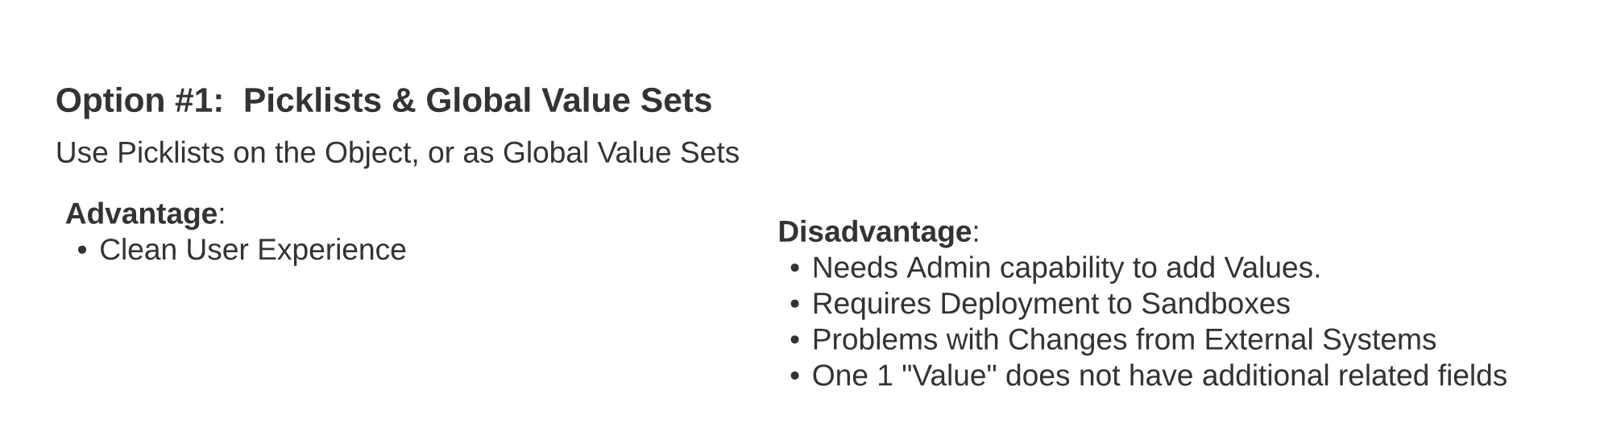
Les ensembles de valeurs globaux conviennent le mieux aux valeurs utilisées à plusieurs endroits. Par exemple, vous pouvez avoir deux ensembles de valeurs globaux, « taille du tuyau » et « épaisseur du tuyau », pour offrir une interface propre où les utilisateurs choisissent les valeurs.
[caption id="" align=“alignnone” width=“1372”]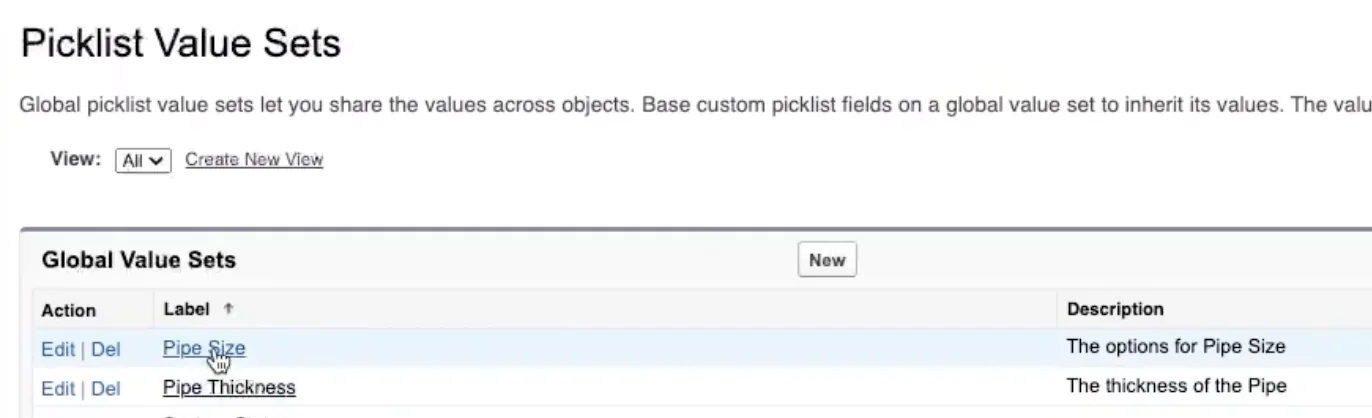 Exemples d’ensembles de valeurs [/caption]
[caption id="" align=“alignnone” width=“1814”]
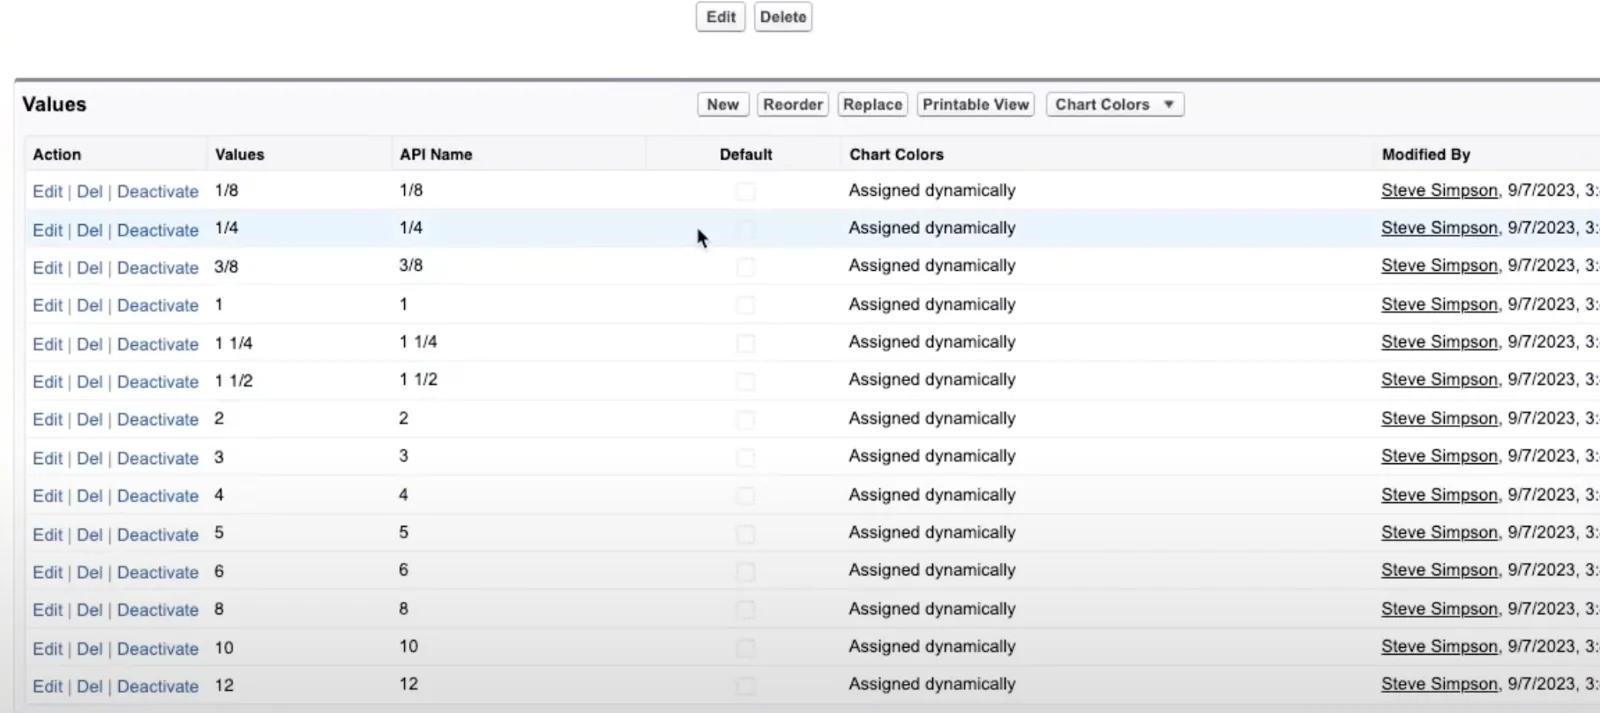 Exemples de valeurs [/caption]
[caption id="" align=“alignnone” width=“676”]
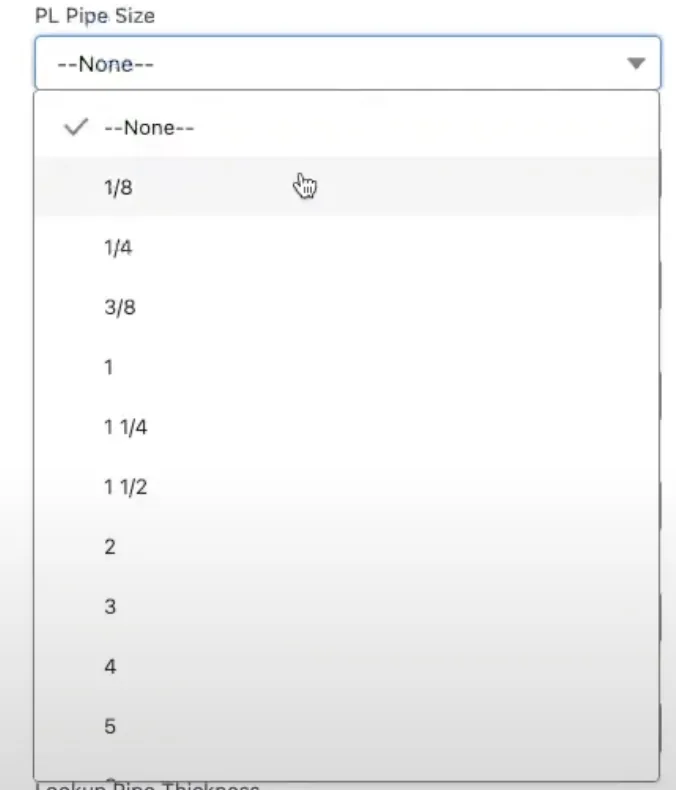 Choisir dans une liste [/caption]
Option 2 : champs texte
Un simple champ texte, sans validation.
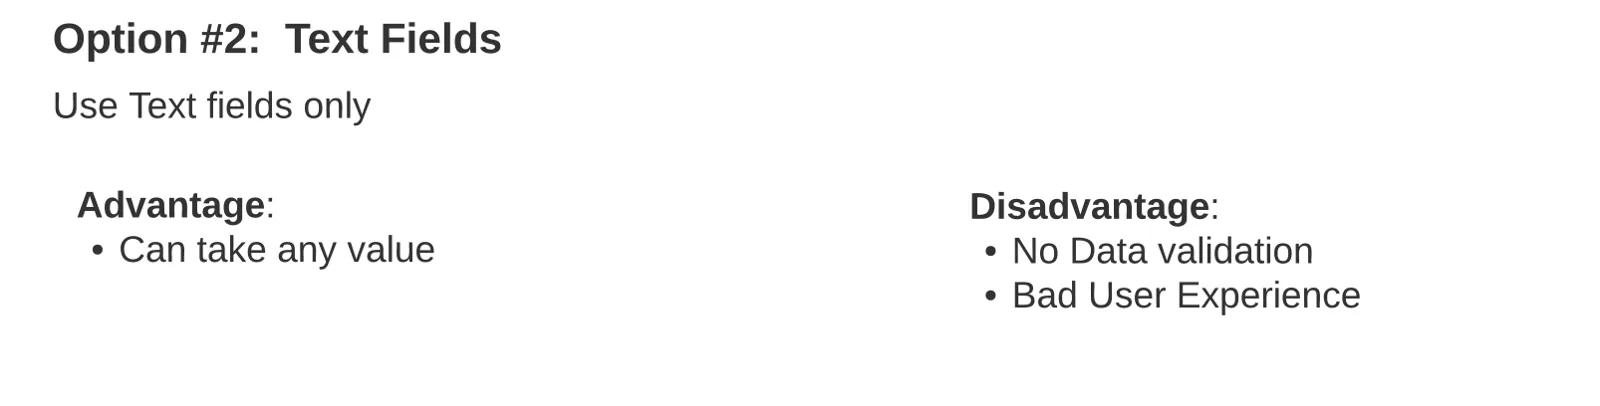
Si les valeurs arrivent par des intégrations, vous pouvez envisager des champs texte. Mais cette approche perd la validation : les utilisateurs peuvent saisir n’importe quoi, ce qui peut créer des incohérences.
Cela peut être une option si les champs sont en lecture seule dans Salesforce et que vous vous contentez d’afficher les valeurs.
[caption id="" align=“alignnone” width=“678”]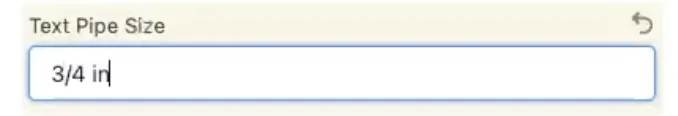 Aucune validation [/caption]
Option 3 : objet de référence partagé
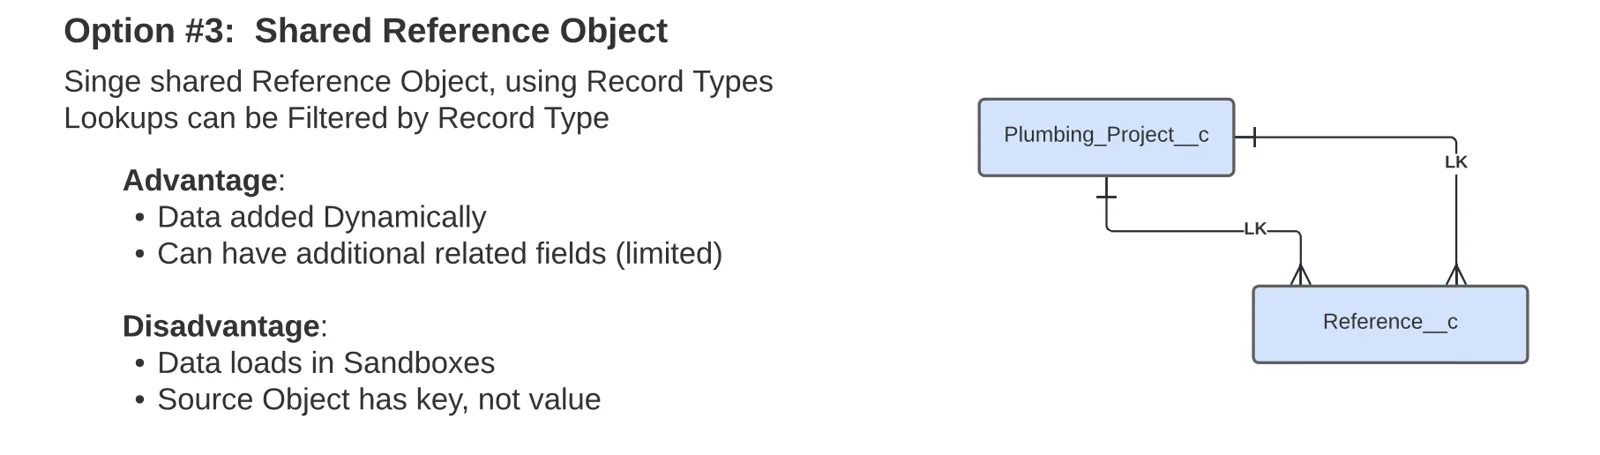
Un objet de référence partagé avec plusieurs types d’enregistrement peut servir aux chargements de données. Cette approche crée deux relations de recherche sur l’objet principal, qui pointent vers l’objet de référence plutôt que vers les valeurs elles-mêmes. Vous pouvez aussi ajouter de nouvelles valeurs dynamiquement sans droits d’administration, ce qui gagne en souplesse.
[caption id="" align=“alignnone” width=“1462”]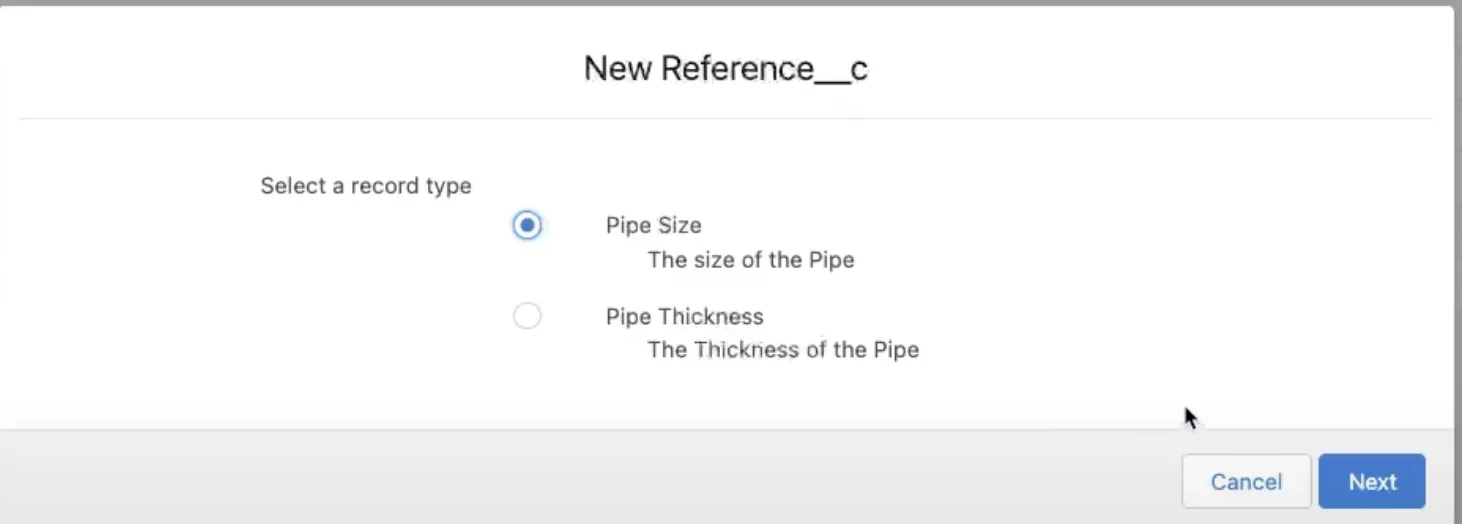 Utiliser des types d’enregistrement [/caption]
[caption id="" align=“alignnone” width=“1700”]
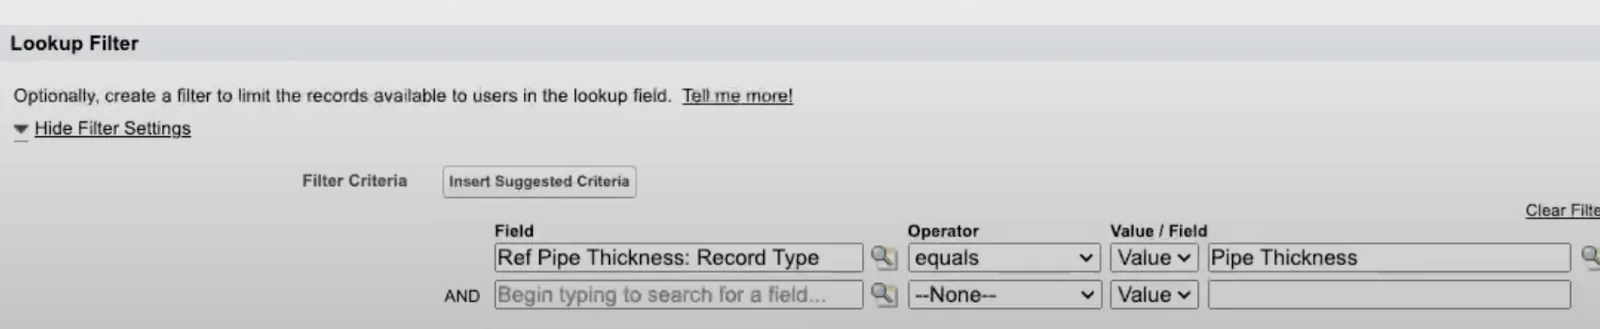 Utiliser une recherche filtrée [/caption]
[caption id="" align=“alignnone” width=“1434”]
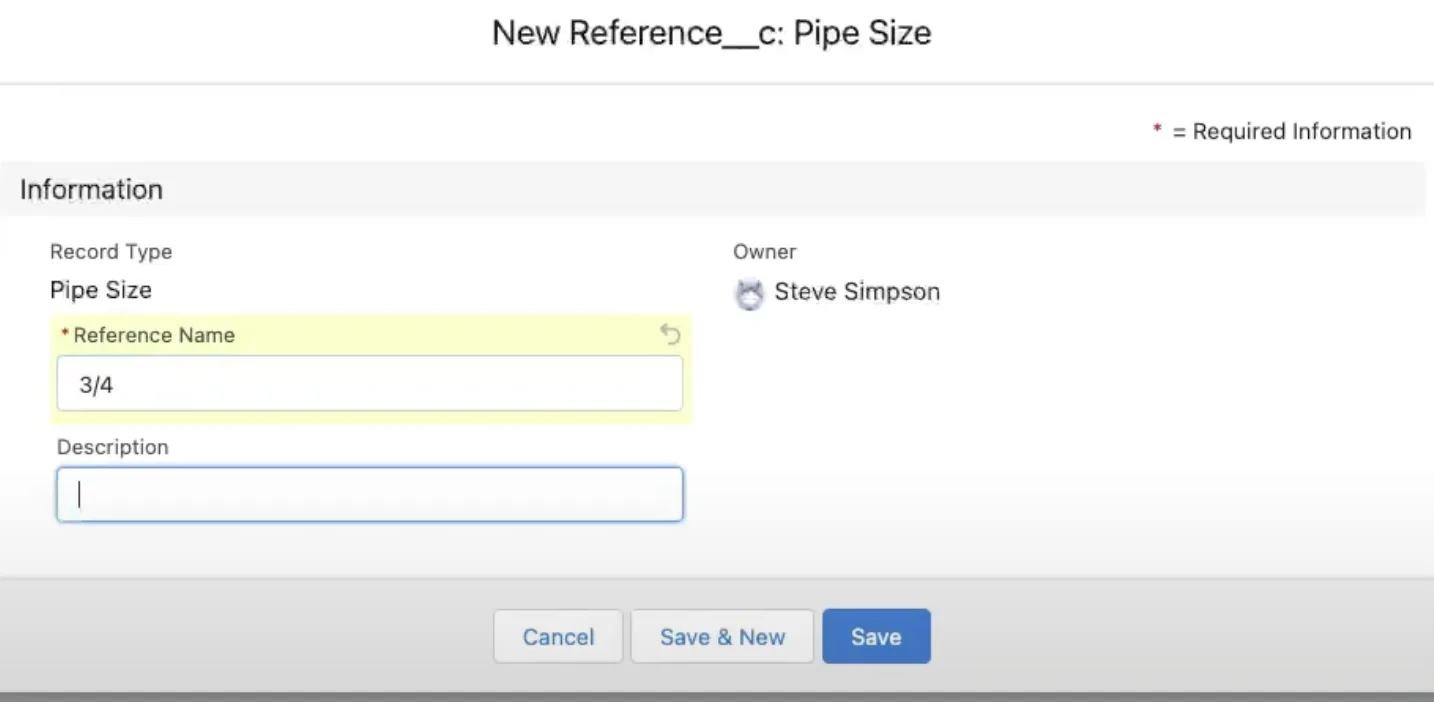 Ajouter des valeurs [/caption]
[caption id="" align=“alignnone” width=“658”]
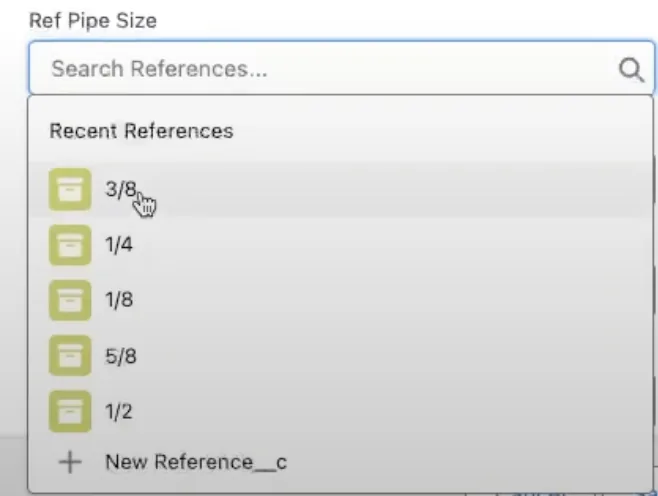 À quoi ressemble la sélection d’une valeur. Le tri n’est pas correct et toutes les valeurs ne s’affichent pas au premier chargement : l’utilisateur doit les rechercher. Pensez aussi à retirer « Créer » des profils et ensembles d’autorisations pour que les utilisateurs ne créent pas d’enregistrements à la volée. [/caption]
Section 3 : options avancées
Pour des scénarios plus avancés, envisagez ces options :
Option 4 : écrans personnalisés avec objet de référence
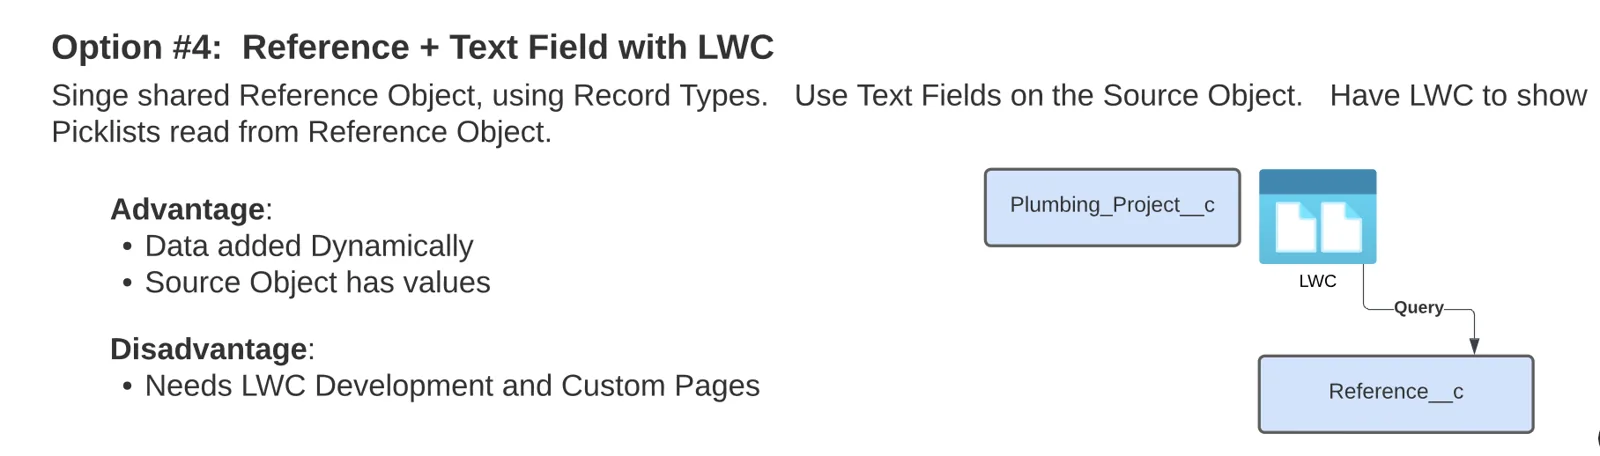
Si vous utilisez des composants web Lightning (LWC) personnalisés pour vos écrans de modification, vous pouvez utiliser un objet de référence pour lire et afficher les valeurs, en stockant les vraies valeurs plutôt que des relations de recherche.
Option 5 : objets autonomes
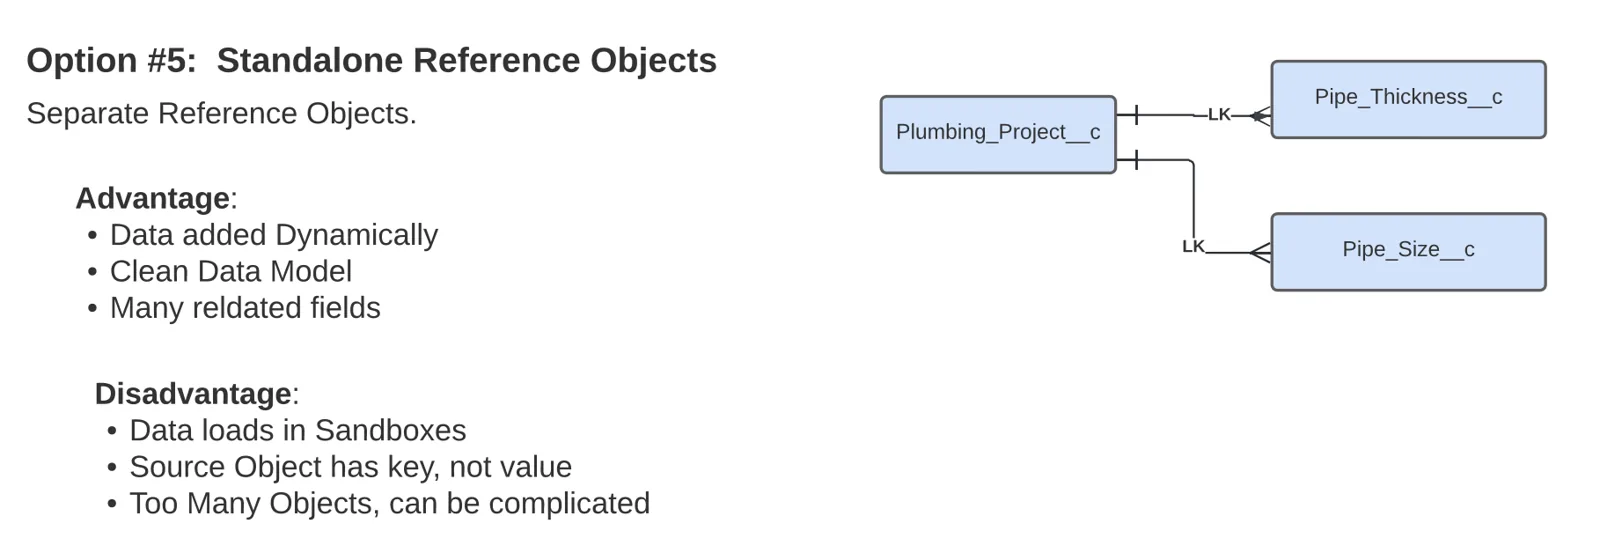
Si les valeurs de recherche prennent de l’importance, envisagez de créer un objet autonome pour chacune, avec des relations de recherche distinctes. Cette approche permet d’ajouter des données dynamiquement, garde un modèle de données propre et accepte d’autres champs associés sur chaque objet.
Exemples concrets
Voici des exemples concrets pour chaque option :
Listes de sélection standard : une interface propre avec des valeurs fixes.
Champs texte sans validation : de la souplesse, mais aucune validation des données.
Recherche vers des objets de référence : le même objet avec des types d’enregistrement filtrés, pour plus de souplesse.
Objets autonomes : un objet distinct par recherche, pour un modèle de données propre et souple.
Conclusion
Comprendre les subtilités des listes de sélection et de leurs alternatives est essentiel pour bien modéliser les données. Des listes de sélection standard aux objets autonomes, chaque option a ses avantages propres selon les besoins de modélisation.
Revenez bientôt !
Pour plus d’idées et de conseils, restez à l’écoute ici sur www.SteveTechArc.com et sur la chaîne YouTube @SteveTechArc (opens in a new tab). Abonnez-vous et faites briller votre modélisation des données avec nous !
Contribuer à changer le monde en partageant de bonnes idées avec d’autres architectes et avec celles et ceux qui sont en chemin pour le devenir !
Transcription réalisée avec l’aide de l’IA
STA 2.2