
Les champs aussi, c'est de l'architecture
Aussi en 28 langues
English · Español · 日本語 · Português (Brasil) · Deutsch · Italiano · 한국어 · 简体中文 · Português (Portugal) · 繁體中文 · Bahasa Indonesia · Türkçe · Polski · Tiếng Việt · ไทย · Nederlands · العربية · עברית · Українська · हिन्दी · Русский · Svenska · Dansk · Norsk bokmål · Suomi · Español (México) · Français (Canada) · Deutsch (Schweiz)
Module 6 sur 10 du chapitre L’architecture de données Salesforce, chapitre 3 du cours Data Architect. Chaque module se suffit à lui-même. Précédent : Choisir le bon objet · Suivant : Les relations ont des conséquences
La question à laquelle répond ce module : comment Salesforce doit-il représenter physiquement chaque donnée ?
Créer un champ prend environ une minute. Nouveau champ, choisir un type, le nommer, Suivant, Suivant, Enregistrer. C’est exactement pourquoi les champs ne sont pas traités comme de l’architecture.
Entrez dans une organisation qui a dix ans et ouvrez le compte. Cinq cents champs. Status2__c, Legacy_Status__c, Old_Status__c, Status_New__c. Trois numéros client différents. Une case à cocher que personne ne supprimera parce que personne ne sait quelle intégration l’utilise encore. Créer le champ a pris une minute. Vivre avec prend des années. L’idée de ce module est donc simple : un champ est une décision d’architecture. Pas toujours une grande, mais chaque champ exprime quelque chose sur le sens, le comportement, l’identité ou la qualité des données, et comme les objets, les champs sont faciles à ajouter et étonnamment difficiles à retirer.
Que signifient réellement ces données ?
Section intitulée « Que signifient réellement ces données ? »Au chapitre 2, nous avons donné des attributs à nos entités : une livraison a un créneau prévu, un camion a un VIN. Maintenant nous les mettons en œuvre, et c’est là que les gens sautent directement sur « champ texte ». Attendez. Avant le type, je veux savoir ce que la donnée signifie. Est-ce un nombre, ou un identifiant qui se trouve contenir des chiffres ? Une date, ou un instant précis ? Du texte libre, ou une valeur parmi un ensemble approuvé ? Saisi par une personne, ou possédé par un autre système ? Peut-il changer ? Doit-il être unique ? Peut-il manquer ? Faut-il le stocker tout court, ou le calculer ? Ce ne sont pas des questions de Configuration. Ce sont des questions d’architecture de données, et le type de champ vient après qu’on y a répondu.
Un nombre n’est pas toujours un nombre
Section intitulée « Un nombre n’est pas toujours un nombre »Steve Trucking donne à chaque camion un numéro de parc, disons 001247. Champ nombre ? Probablement pas. Additionnons-nous des numéros de parc ? Le camion 1247 moins le camion 1246, est-ce un camion ? C’est un identifiant qui se trouve contenir des chiffres, et un champ nombre supprimerait même les zéros initiaux. Il en va de même des codes postaux, des codes produit, des numéros de compte et des numéros de suivi. L’apparence d’une valeur ne vous dit pas ce qu’elle signifie. Choisissez le type pour le comportement dont vous avez besoin, pas pour l’allure des données d’exemple.
Un humain doit-il l’identifier ?
Section intitulée « Un humain doit-il l’identifier ? »Chaque objet personnalisé reçoit un champ Name, et la première décision est texte ou numérotation automatique. Je demande : un humain doit-il identifier cette chose ? Les gens connaissent un partenaire distributeur par son nom et un camion par son numéro de parc. Mais un manifeste que le système génère chaque nuit ? Personne ne devrait taper « Manifeste 02-10 numéro 3 » parce que Salesforce exigeait un nom. Donnez-lui une numérotation automatique. Seulement, ne confondez pas ce nom généré avec l’identité de l’enregistrement : la numérotation automatique aide les utilisateurs, l’ID Salesforce identifie l’enregistrement, et la référence de manifeste propre au partenaire distributeur peut identifier la même chose entre systèmes. Trois métiers différents.
L’écran des détails
Section intitulée « L’écran des détails »Choisissez un type, cliquez sur Suivant, et la Configuration vous demande les détails. C’est sur cet écran que se prennent réellement la plupart des décisions de ce module, généralement dans la précipitation.
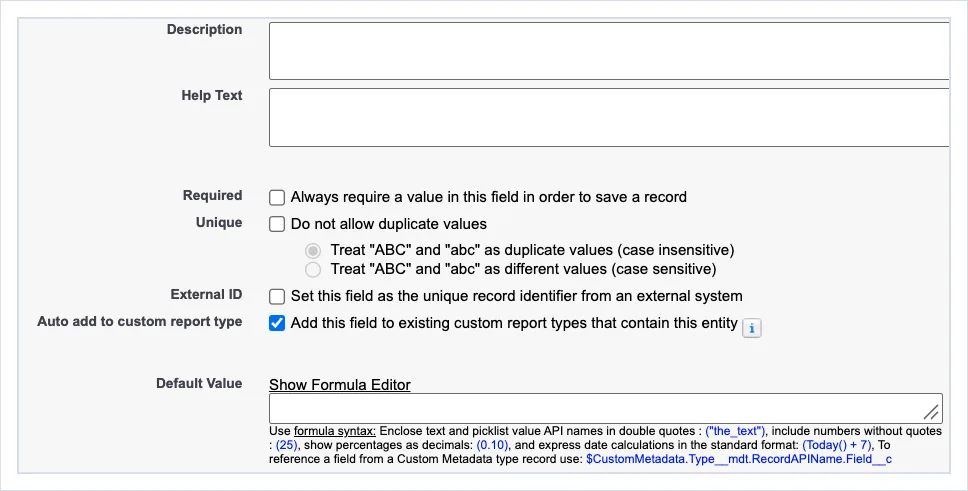
Nouveau champ personnalisé, étape 2 : les détails (capture d’écran, 2026-10-12). Taille réelle
Deux cases se ressemblent et font des travaux différents. La Description est pour les personnes qui maintiennent l’organisation, et maintenant pour les outils d’IA qui la lisent : ce que signifie le champ, à qui il appartient, d’où il vient. Le Texte d’aide est pour l’utilisateur à l’écran : quoi saisir ici. Remplissez les deux. Viennent ensuite Obligatoire, Unique et ID externe, et chacun mérite sa propre section. En dessous, la Valeur par défaut peut être une formule, pour qu’un nouvel enregistrement démarre avec une valeur sensée au lieu d’un blanc.
Obligatoire est une décision plus lourde qu’il n’y paraît
Section intitulée « Obligatoire est une décision plus lourde qu’il n’y paraît »Il y a une petite case dans l’assistant de champ, intitulée Obligatoire, et comme nous l’avons vu au chapitre 1, elle peut être une bombe à retardement. Vous avez un objet depuis cinq ans et deux millions d’enregistrements, et quelqu’un décide maintenant qu’un nouveau champ doit toujours avoir une valeur. Et les deux millions d’enregistrements antérieurs ? Les intégrations qui ne l’envoient pas ? L’automatisation qui crée l’enregistrement avant que la valeur soit connue ? Le processus où la valeur n’apparaît que trois étapes plus tard ?
« Obligatoire » ressemble à une décision de qualité de données, et c’en est parfois une. Mais le moment où une valeur devient connue fait partie du processus métier. Ne cochez donc pas Obligatoire parce que quelqu’un dit « on la veut toujours ». Demandez quand elle est connue, qui la fournit, et ce qui se passe quand elle ne l’est pas. Nous mettrons cela sur toute l’échelle de cohérence au module 7.
Unique veut aussi dire quelque chose
Section intitulée « Unique veut aussi dire quelque chose »Si je marque un champ comme unique, j’affirme quelque chose sur le métier : pas « il ne se répète généralement pas », mais « deux enregistrements ne peuvent jamais avoir cette valeur ». C’est fort. Et l’écran vous fait trancher encore une chose : « ABC » et « abc » sont-ils la même valeur ou deux valeurs différentes ? Insensible à la casse est le choix par défaut le plus sûr pour tout ce qu’une personne saisit. La règle des clés du chapitre 2, unique, immuable, sans signification, jamais une donnée personnelle, s’applique ici. Si quelqu’un me dit que l’e-mail d’un employé est unique, je commence à demander : peut-il changer, quelqu’un peut-il partir et revenir, les adresses peuvent-elles être réutilisées, que se passe-t-il après une acquisition ? L’e-mail peut être utile, et même unique aujourd’hui. Cela n’en fait pas un bon identifiant unique.
Les ID externes : l’identité de part et d’autre de la frontière
Section intitulée « Les ID externes : l’identité de part et d’autre de la frontière »C’est là que les ID externes font leurs preuves. L’écran le décrit bien : le champ devient « l’identifiant unique de l’enregistrement dans un système externe ». L’ERP a le client 873492 ; Salesforce a son propre ID d’enregistrement. Quand l’ERP envoie une mise à jour, comment savons-nous à quel enregistrement elle se rapporte ? Marquez un champ comme ID externe et une intégration peut faire un upsert dessus : créer l’enregistrement s’il n’existe pas, le mettre à jour s’il existe (Upsert a Record Using an External ID (opens in a new tab), en anglais). Et quand vous chargez des enregistrements enfants, vous pouvez désigner le parent par son ID externe au lieu de chercher d’abord l’ID Salesforce. J’aime dire qu’on laisse Salesforce faire la correspondance à notre place. Très puissant.
Remarquez que le numéro de l’ERP ne devient pas l’identité de l’enregistrement Salesforce. C’est un attribut, et un enregistrement peut en porter plusieurs : un ID client ERP, un ancien ID, l’ID d’un partenaire. Ce n’est pas un problème. Une même entité métier peut être connue différemment par plusieurs systèmes. La question d’architecture est quel système possède chaque identifiant, et quelle promesse il fait : ne le marquez comme unique que si le métier le garantit vraiment.
Type de champ par type de champ
Section intitulée « Type de champ par type de champ »Passons aux types eux-mêmes. Ouvrez Nouveau champ sur n’importe quel objet et la Configuration vous montre toute la liste, regroupée comme je vais la parcourir : les champs que Salesforce calcule pour vous, les champs de relation, puis les types de données.
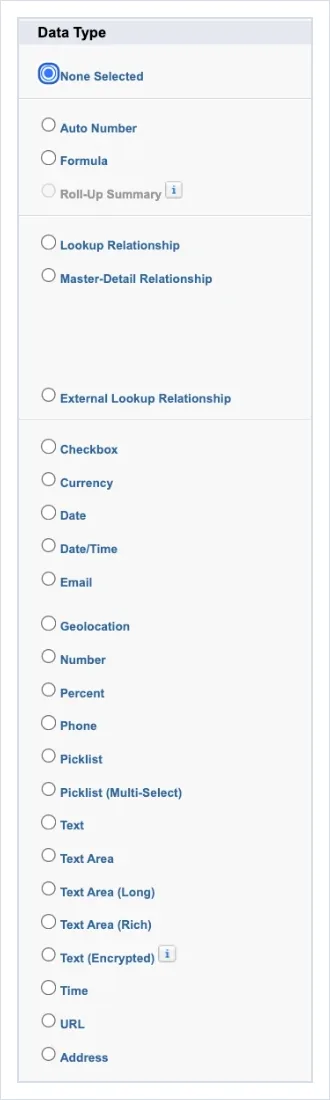
Configuration, Nouveau champ personnalisé, étape 1 : les types de données (capture d’écran, 2026-10-12). Taille réelle
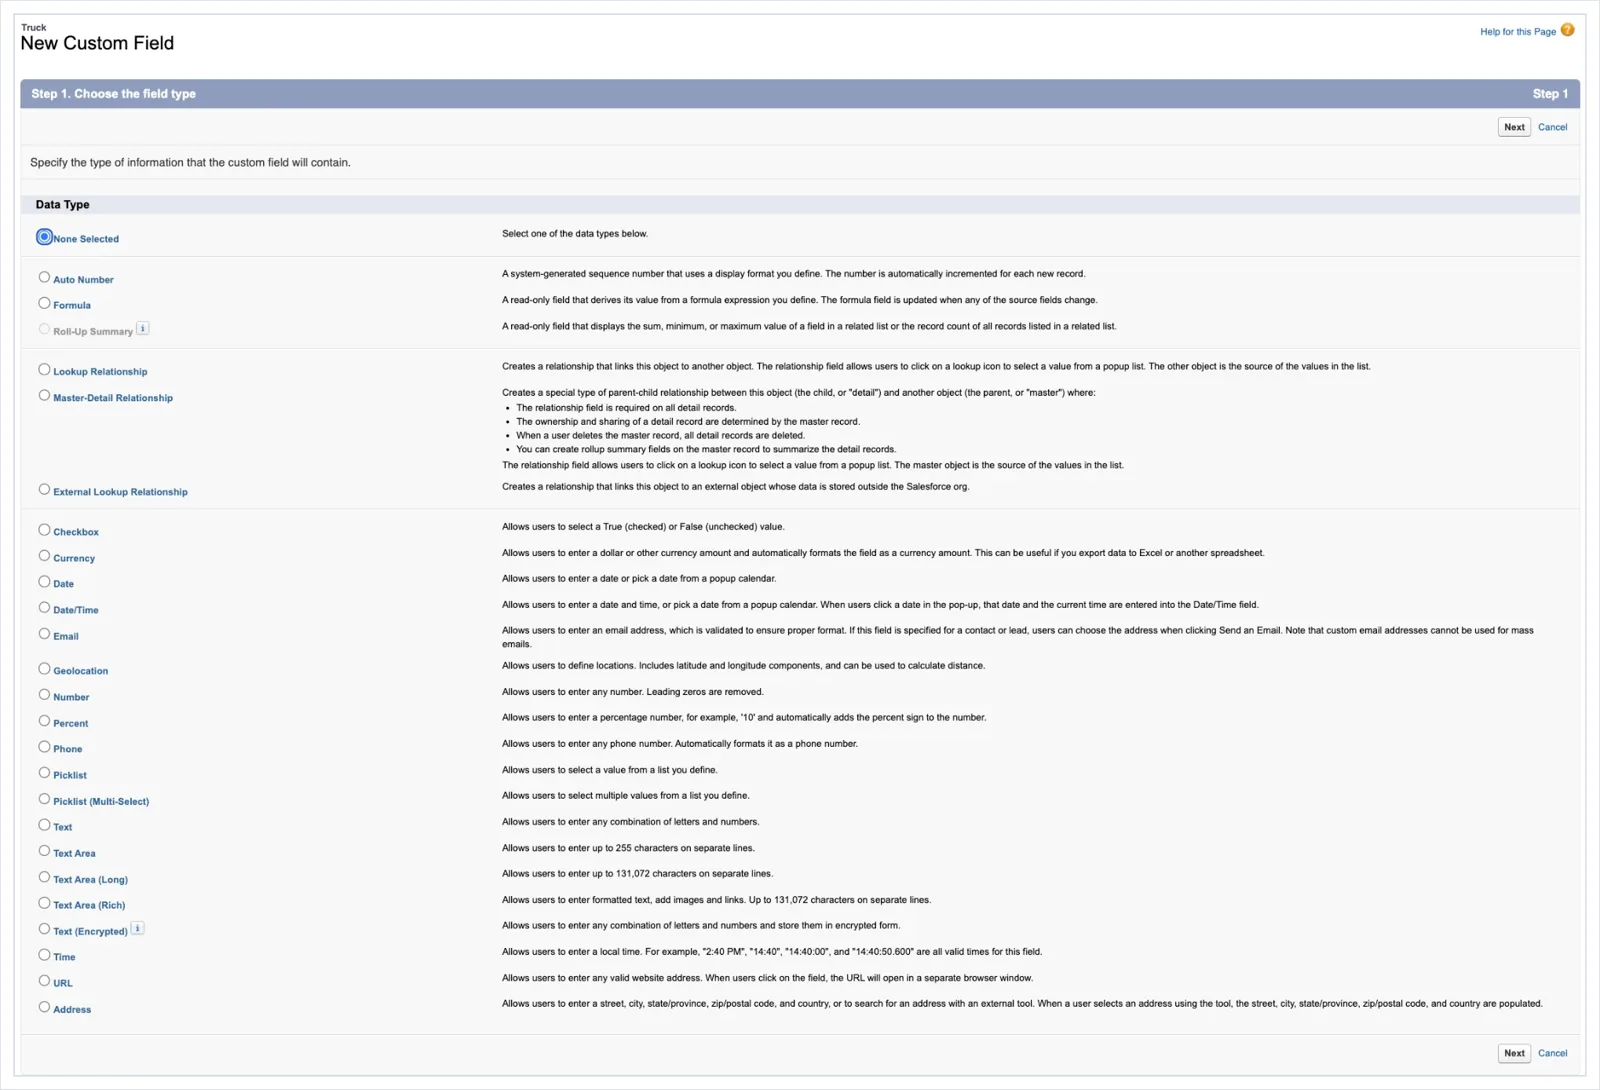
Voici toute la liste d’un coup d’œil, avec la chose que je voudrais que vous reteniez pour chacun.
| Groupe | Type | À retenir |
|---|---|---|
| Calculés | Numérotation automatique | Jusqu’à 30 caractères, dont 20 pour le préfixe ou le suffixe ; une étiquette pour les gens, pas l’identifiant unique de l’enregistrement |
| Formule | Calculée à la lecture, pas stockée ; 3 900 caractères | |
| Récapitulatif de cumul | Nombre, somme, min ou max des détails ; principal-détails uniquement | |
| Relations | Référence, principal-détails, référence externe | Module 7 |
| Données | Case à cocher | Vrai ou faux, avec une valeur par défaut que vous choisissez ; null peut quand même apparaître dans les flows |
| Nombre, Pourcentage, Devise | Règles d’arrondi ; zéros de tête supprimés ; 15 décimales | |
| Date, Date/Heure, Heure | Un jour, un instant, ou une heure de la journée ; les instants sont stockés en UTC | |
| E-mail, Téléphone, URL | Formatés et vérifiés à l’enregistrement : 80, 40 et 255 caractères | |
| Géolocalisation, Adresse | Des champs composés qui coûtent plus d’un champ : 3 et 9 | |
| Liste de sélection, sélection multiple | Un vocabulaire contrôlé, détenu par un administrateur | |
| Texte, Zone de texte, longue, enrichie, chiffré | Jusqu’à 255 sur l’enregistrement et indexable ; au-delà, ni index ni filtrage |
Les champs que Salesforce calcule
Section intitulée « Les champs que Salesforce calcule »La numérotation automatique attribue le numéro suivant d’une séquence à chaque nouvel enregistrement, dans un format que vous définissez, comme T-{000000}. Utilisez-la quand un humain a besoin d’une poignée pratique et que personne ne devrait avoir à en inventer une. La valeur entière fait jusqu’à 30 caractères, dont 20 sont réservés au préfixe ou au suffixe. Rappelez-vous simplement le chapitre 2 : c’est une étiquette pour les gens, pas l’identifiant unique de l’enregistrement, et les numéros ne sont pas toujours strictement séquentiels.
Les champs formule calculent une valeur à partir d’autres champs. Ils sont puissants, et ils sont calculés quand l’enregistrement est lu, pas quand il est enregistré, donc rien n’est stocké qui pourrait se périmer. Vous choisissez ce que renvoie la formule : une case à cocher, une devise, une date, une date/heure, un nombre, un pourcentage, du texte ou une heure.
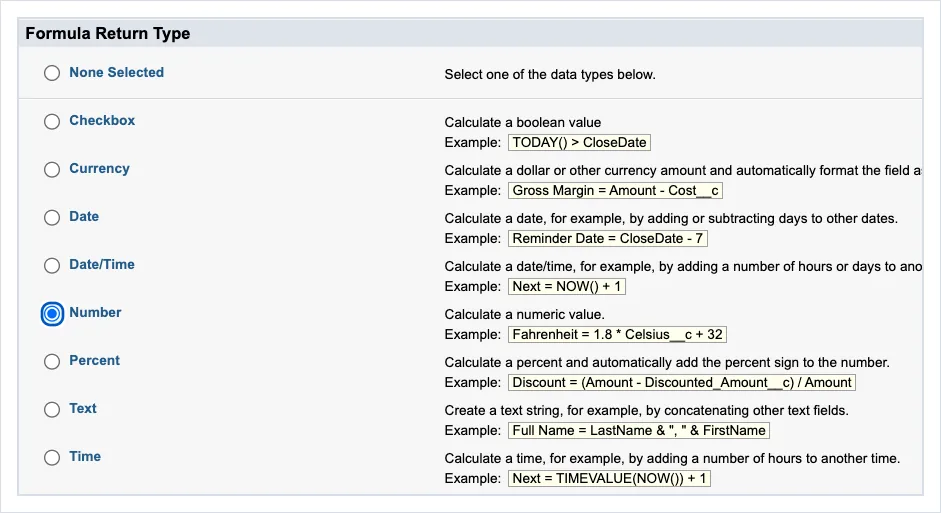
Nouveau champ personnalisé, formule : choisir le type de retour (capture d’écran, 2026-10-12). Taille réelle
Ensuite, vous écrivez la formule elle-même, avec des champs, des opérateurs et des fonctions, et vous vérifiez sa syntaxe. Remarquez le bouton Use Formula Assistant (utiliser l’assistant de formule) : l’IA de Salesforce va maintenant vous aider à écrire la formule. Servez-vous-en, puis lisez ce qu’elle a écrit. C’est vous qui êtes responsable de la formule, pas l’assistant.
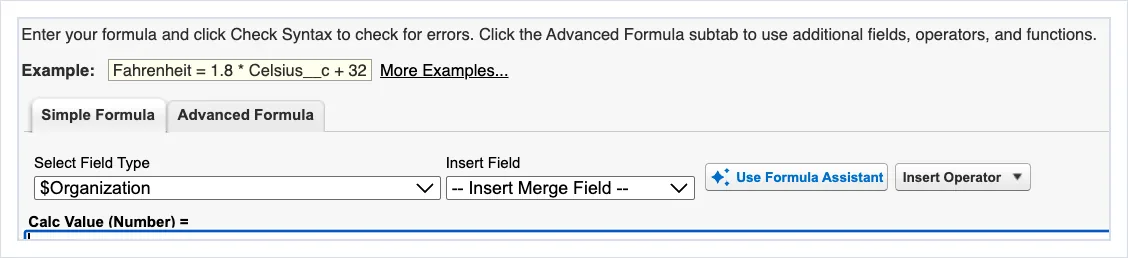
L’éditeur de formules, avec le Formula Assistant (capture d’écran, 2026-10-12). Taille réelle Une formule peut faire jusqu’à 3 900 caractères, et elle ne peut pas dépasser 15 000 octets une fois enregistrée ou compilée ; une longue formule peut être répartie sur plusieurs champs formule qui se référencent les uns les autres. Les zones de texte longues, les champs chiffrés et les champs Description ne peuvent pas y être utilisés.
Les champs de récapitulatif de cumul se trouvent sur le principal et comptent, additionnent, ou prennent le minimum ou le maximum de ses enregistrements de détail. Ils ne fonctionnent qu’à travers une relation principal-détails, ce qui est l’une des plus grandes raisons de choisir principal-détails. Nous y reviendrons, avec leurs limites, au module 7.
Stocké ou dérivé ?
Section intitulée « Stocké ou dérivé ? »Avons-nous seulement besoin de stocker cette valeur ? Si j’ai la quantité et le prix unitaire, quelqu’un, ou une automatisation, doit-il maintenir un total ? Une formule devrait peut-être le dériver : une seule source pour le calcul, recalculé à la lecture, donc changez la quantité et la réponse suit. Les formules ont leurs propres limites (taille enregistrée et longueur affichée ; Formula Field Limits and Restrictions (opens in a new tab), en anglais), et les formules complexes deviennent difficiles à maintenir.
Mais parfois, le métier ne veut pas la réponse d’aujourd’hui. Il veut la réponse telle qu’elle était. Si la règle de remise change l’an prochain, la facture de l’an dernier doit-elle soudain afficher un autre montant ? Bien sûr que non. La question n’est donc pas « Salesforce peut-il calculer ça ? ». C’est « s’agit-il d’un calcul actuel ou d’un fait historique ? ». Les faits historiques se stockent.
Les champs de relation
Section intitulée « Les champs de relation »Les relations de référence, principal-détails et de référence externe sont aussi des champs, et c’est là que les lignes de votre modèle deviennent réelles. La référence est le lien souple ; principal-détails lie la vie, la propriété et la sécurité de l’enfant au parent ; la référence externe atteint un objet externe du module 4, en faisant la correspondance sur son ID externe. Choisir entre elles est une décision assez importante pour avoir son propre module.
Case à cocher
Section intitulée « Case à cocher »Une case à cocher est le champ le plus simple qui soit : vrai ou faux, cochée ou non cochée. Elle est parfaite pour un fait oui/non sur l’enregistrement : Actif, Installation requise, Signé à la réception. Quand vous en créez une, Salesforce vous oblige à choisir sa valeur par défaut, cochée ou non cochée, et c’est une vraie décision : c’est la valeur avec laquelle démarre chaque nouvel enregistrement, y compris ceux qu’une intégration crée sans envoyer le champ. Les rapports et les vues de liste la filtrent en Vrai et Faux ; les outils d’importation et l’exportation hebdomadaire l’affichent en 1 et 0.
Un piège à connaître. Le champ sur l’enregistrement a deux valeurs, mais l’automatisation autour peut en avoir une troisième. Dans un flow, une variable case à cocher qui n’a jamais été définie vaut null, pas false, et l’enregistrer dans un enregistrement échoue (Trailblazer Community (opens in a new tab), en anglais ; voir aussi le problème connu Salesforce W-11208535 (opens in a new tab)). Choisissez une valeur par défaut sensée, et faites en sorte que vos flows et votre code traitent null délibérément.
Nombre, pourcentage et devise
Section intitulée « Nombre, pourcentage et devise »Nombre stocke un nombre réel, et supprime les zéros de tête, ce qui est exactement pourquoi un numéro de parc comme 001247 n’est pas un nombre. Salesforce arrondit les champs nombre au plus loin de zéro pour les demis : 12,345 devient 12,35, et −12,345 devient −12,35. Et dans les champs de fusion, il arrondit selon les paramètres régionaux de l’utilisateur, pas selon les décimales définies sur le champ.
Pourcentage stocke un décimal et affiche un pourcentage : saisissez 0,10 et vous voyez 10 %. Les valeurs perdent en précision au-delà de 15 décimales.
Devise est formaté pour l’argent, et dans une organisation à plusieurs devises, il porte son code de devise et peut utiliser des taux de change ; avec la gestion avancée des devises (opens in a new tab) (en anglais), les opportunités peuvent utiliser des taux de change datés, le taux de la période où l’affaire a été conclue. Seules les opportunités et ce qui les entoure (produits, échéanciers, répartitions et leurs rapports) utilisent les taux datés ; les champs devise des autres objets gardent l’unique taux statique. Attention à l’arrondi : sans décimales, Salesforce tronque simplement (23,5 devient 23) ; avec une ou plusieurs, il arrondit au plus loin de zéro.
Date, Date/Heure et Heure
Section intitulée « Date, Date/Heure et Heure »Trois types, trois sens différents. Une Date est un jour : un contrat expire à une date. Une Date/Heure est un instant : la livraison est arrivée à 9 h 42 ce matin-là. Une Heure est une heure de la journée sans aucune date : le magasin ouvre à 7 h 00, tous les jours.
Le piège, c’est l’instant. Salesforce stocke les valeurs date/heure en GMT (UTC). L’heure qu’un utilisateur saisit est lue dans son fuseau horaire, convertie, puis stockée ; quand quelqu’un la lit, elle est de nouveau convertie dans le fuseau horaire du lecteur. La plupart du temps, c’est exactement ce que vous voulez. Mais voici l’exemple que je donne en cours : une coordinatrice à Los Angeles enregistre une livraison tard le dimanche soir, à 22 h, heure du Pacifique. En dessous, Salesforce a stocké lundi matin, 5 h GMT. Un rapport regroupé par jour dans un autre fuseau horaire, ou une intégration qui lit la valeur brute, peut placer cette livraison du dimanche le lundi. « Le jour où c’est arrivé » dépend de l’horloge à laquelle vous posez la question. Surveillez les fuseaux horaires des utilisateurs, et décidez lequel le métier veut dire.
Et faites attention en les comparant. En dessous, une date/heure est un grand nombre : Apex la lit comme le nombre de millisecondes depuis le 1er janvier 1970, 00:00:00 GMT (Datetime Class (opens in a new tab), en anglais). C’est un instant précis, pas un jour. Donc demander si deux date/heures sont égales (==) ne fait presque jamais ce que vous voulez : 9:42:00 et 9:42:01 ne sont pas égales, pas plus que « lundi » et n’importe quel instant du lundi. Demandez plutôt une plage : à partir du début (>=) et jusqu’à la fin (<=). « Toutes les livraisons du lundi », ce sont toutes les livraisons >= lundi 00:00 et <= lundi 23:59:59, dans le fuseau horaire que vous avez décidé que le métier veut dire.
Et une amusante : Salesforce ne peut pas stocker n’importe quelle date. Les dates valides vont du 1er janvier 1700 au 31 décembre 4000, et Salesforce donne la même plage pour les dates et les date/heures (Data Import Dates (opens in a new tab), en anglais). Même les bornes sont des instants en GMT, donc pour un utilisateur à l’heure du Pacifique, la première valeur valide est 16 h le 31 décembre 1699. La date de fondation de votre société historique pourrait ne pas passer. Et l’astuce classique « pas de date de fin », le 31 décembre 9999, est rejetée ; s’il vous faut une valeur de remplacement dans un futur lointain, elle doit tomber en l’an 4000 ou avant.
E-mail, téléphone et URL
Section intitulée « E-mail, téléphone et URL »Ce sont les champs formatés, et ils font plus que stocker des caractères. E-mail contient jusqu’à 80 caractères et son format est vérifié ; sur les contacts et les pistes, cliquer dessus démarre un e-mail vers cette adresse. Téléphone contient jusqu’à 40 caractères, est formaté comme un numéro de téléphone, et devient cliquable pour appeler quand l’organisation a un système téléphonique connecté. URL contient jusqu’à 255 caractères et s’ouvre comme un lien. C’est la plateforme qui vous donne un comportement gratuitement, et c’est pourquoi je ne stockerais jamais un numéro de téléphone dans un simple champ texte.
Les intégrations sont vérifiées aussi. Une valeur qui ne correspond pas au format du champ, comme une adresse e-mail mal formée, échoue à la validation, et tout l’enregistrement est rejeté, pas seulement ce champ. Alors quand les données du système source sont désordonnées, nettoyez-les avant qu’elles arrivent, ou prévoyez les enregistrements qui ne se chargeront pas.
Géolocalisation et adresse
Section intitulée « Géolocalisation et adresse »Géolocalisation contient une latitude et une longitude. En dessous, un champ nommé Location__c est en réalité deux valeurs que vous pouvez lire et définir séparément, Location__Latitude__s et Location__Longitude__s. Et vous pouvez faire des requêtes dessus : les fonctions SOQL DISTANCE et GEOLOCATION trouvent les enregistrements dans un rayon donné, ou les trient selon leur distance. « Toutes les livraisons ouvertes à moins de 25 miles de ce camion », c’est une seule requête : WHERE DISTANCE(Location__c, GEOLOCATION(33.45, -112.07), 'mi') < 25 (Location-Based SOQL Queries (opens in a new tab), en anglais). Adresse contient une adresse entière, rue, ville, État ou province, code postal et pays, et les utilisateurs peuvent rechercher une adresse et faire remplir les parties automatiquement.
Ce sont tous deux des champs composés : un seul champ à l’écran, plusieurs en dessous. Et ils coûtent plus d’un champ dans la limite de votre objet : une géolocalisation compte pour trois champs personnalisés, et une adresse pour neuf. Sur un objet déjà chargé, ça compte.
Liste de sélection et sélection multiple
Section intitulée « Liste de sélection et sélection multiple »Une liste de sélection contrôle ce que les utilisateurs peuvent saisir : une valeur parmi une liste que vous définissez. Un statut ? Liste de sélection, probablement. Mais les valeurs sont des métadonnées, et un administrateur doit les ajouter ou les modifier. Alors je demande quand même à qui appartiennent les valeurs, à quelle fréquence elles changent, si plusieurs objets ont besoin de la même liste, si les valeurs portent une information propre, et si un autre système détient le vocabulaire.
L’endroit où vivent les valeurs est aussi une décision. Quand une liste sert une seule fois, sur un seul champ, gardez les valeurs sur le champ lui-même, sur l’objet ; c’est ce que Salesforce fait par défaut. Mais quand le même ensemble de valeurs commence à apparaître à plusieurs endroits, une région sur le compte, sur la livraison et sur l’entrepôt, promouvez-le en ensemble de valeurs global avant que les copies divergent. Un ensemble de valeurs global garde une seule liste pour tous, jusqu’à 1 000 valeurs, actives et inactives confondues (Picklist Limitations (opens in a new tab), en anglais). La propre description de la Configuration dit pourquoi c’est important : l’ensemble de valeurs « est restreint pour que les utilisateurs ne puissent pas ajouter de valeurs non approuvées via l’API ». Une liste, un propriétaire, et aucune intégration qui glisse une nouvelle orthographe.
Ce dernier point, c’est la différence entre restreinte et non restreinte. Sur une liste de sélection restreinte, seules les valeurs définies par un administrateur sont autorisées, d’où qu’elles viennent : un utilisateur, une importation ou une intégration qui envoie autre chose reçoit une erreur, « bad value for restricted picklist field », et l’enregistrement n’est pas sauvegardé. Sur une liste de sélection non restreinte, les utilisateurs choisissent toujours dans la liste à l’écran, mais l’API, les importations et l’automatisation peuvent envoyer n’importe quelle valeur, et Salesforce l’enregistre et l’ajoute comme valeur inactive (Picklist Limitations (opens in a new tab) ; Create a Custom Picklist Field (opens in a new tab), en anglais). C’est comme ça qu’une organisation se retrouve avec « Delivered », « delivered » et « Dlvrd ». Les ensembles de valeurs globaux sont toujours restreints. Mon choix par défaut, c’est restreinte ; non restreinte est un choix délibéré pour quand un autre système détient réellement les valeurs, et alors quelqu’un est responsable du nettoyage des valeurs inactives.
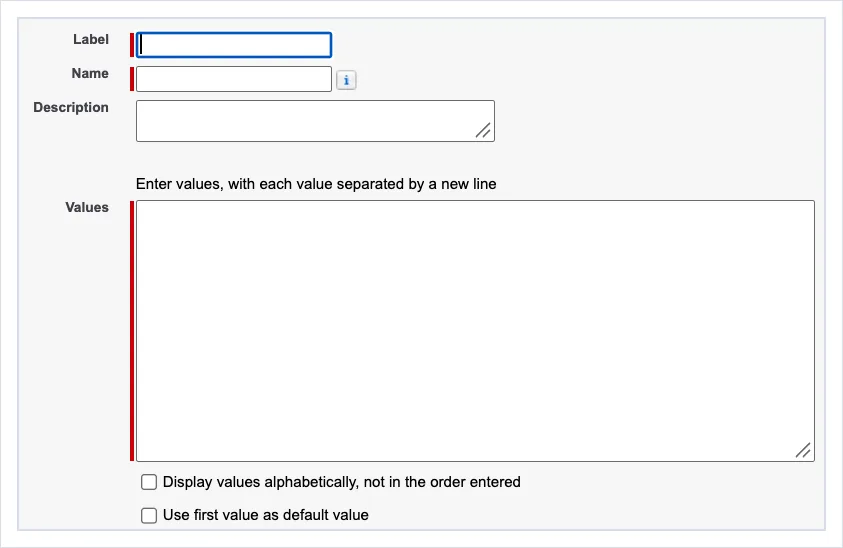
Configuration, Ensembles de valeurs de liste de sélection : un nouvel ensemble de valeurs global (capture d’écran, 2026-10-12). Taille réelle
Une liste de sélection multiple permet à un utilisateur de choisir plusieurs valeurs, stockées ensemble, séparées par des points-virgules. Pratique à l’écran, malcommode partout ailleurs : plus difficile à filtrer, à mettre en rapport et à intégrer, et elle ne peut pas servir dans le filtre d’un récapitulatif de cumul. Plusieurs valeurs pour un enregistrement, c’est généralement la leçon du chapitre 2 : il y a un objet enfant qui essaie de sortir.
Une liste de sélection a aussi une valeur de plus que celles que vous avez définies : le blanc. Un enregistrement peut rester sans rien de sélectionné, et ça surprend les gens. Dans une formule ou une règle de validation, vous ne pouvez pas tester une liste de sélection avec ISBLANK seul ; vous écrivez ISBLANK(TEXT(Field__c)), ou ISPICKVAL(Field__c, "") (Trailblazer Community (opens in a new tab), en anglais). Alors décidez ce que « pas de valeur » veut dire pour chaque liste de sélection : est-ce autorisé, et qu’est-ce que ça signifie quand ça arrive ? Puis faites en sorte que vos formules, règles de validation et filtres le gèrent.
Et parfois, un attribut est en réalité une entité. Quelqu’un demande une liste de sélection des centres de distribution. Il y en a neuf. Facile. Puis nous apprenons que chacun a une adresse, un responsable, des horaires, une capacité, une région et des camions. Ce n’est pas une liste de sélection ; c’est une chose. Ne transformez pas une entité en liste de sélection simplement parce qu’il n’y en a pas encore beaucoup. C’est très agréable la première année et terrible la cinquième. (Le module 5 du chapitre 2 donne mes règles empiriques pour savoir quand une liste mérite son propre objet.)
La famille texte
Section intitulée « La famille texte »J’enseigne le texte comme deux sortes, et la frontière entre les deux, c’est 255 caractères.
Jusqu’à 255 : stocké avec l’enregistrement. Texte contient jusqu’à 255 caractères, et vous pouvez l’utiliser presque partout : dans les formules, les filtres, les rapports, les vues de liste, comme champ unique ou comme ID externe, et il peut être indexé. Zone de texte contient aussi 255 caractères, sur plusieurs lignes, comme une courte note.
Au-delà de 255 : stocké par référence. Zone de texte (longue) contient jusqu’à 131 072 caractères, et Zone de texte (enrichie) contient la même chose avec mise en forme, liens et images. Je les vois comme stockées à côté, l’enregistrement ne gardant qu’un pointeur, et elles se comportent ainsi : pas d’index, donc vous ne pouvez pas les rendre uniques ni en faire un ID externe ; vous ne pouvez pas filtrer dessus dans une clause SOQL WHERE (SOQL WHERE (opens in a new tab), en anglais) ; les formules ne peuvent pas les utiliser (Formula Field Limits and Restrictions (opens in a new tab)) ; et les rapports n’affichent que les 254 premiers caractères d’un champ personnalisé, les filtres de rapport ne cherchant que dans les 255 premiers environ (Filter Restrictions for Text Area (Long) Fields (opens in a new tab)). Les images téléchargées dans un champ texte enrichi peuvent faire jusqu’à 1 Mo chacune, et elles comptent dans le stockage de fichiers, tandis que le texte compte dans le stockage de données (Rich Text Area Field Considerations (opens in a new tab), en anglais). Alors si quelqu’un a besoin de rechercher, trier, rapprocher ou mettre en rapport la valeur, restez sous 255 et gardez un champ Texte.
Texte (chiffré) stocke jusqu’à 175 caractères sous forme chiffrée, avec le chiffrement classique (Classic Encryption). Si votre organisation utilise Shield Platform Encryption, vous chiffrez plutôt un champ Texte ordinaire, et beaucoup d’autres types peuvent être chiffrés de cette façon.
Donnez une description à chaque champ
Section intitulée « Donnez une description à chaque champ »Ma norme : chaque champ a une description. J’y crois depuis longtemps, et à l’ère de l’IA, c’est plus important que jamais : chaque outil d’IA et chaque agent qui lit votre organisation lit les descriptions pour comprendre ce que signifie un champ. Une description vide, c’est une supposition qui ne demande qu’à arriver. Que signifie Customer_Status__c ? À qui appartient-il ? D’où vient-il ? Les utilisateurs peuvent-ils le modifier, ou l’ERP l’écrase-t-il ce soir ? Dans six mois, je ne m’en souviendrai pas, et dans trois ans, l’administrateur qui maintiendra l’organisation ne le saura pas si nous ne l’avons pas dit. L’étiquette n’est pas de la documentation, et le nom d’API non plus.
Sur les objets très partagés (compte, contact, opportunité), j’utilise aussi des préfixes de nommage pour les champs spécialisés, afin que leur origine et leur finalité se voient dans le nom lui-même : tout ce que possède l’ERP commence par le même préfixe, par exemple. Je ne cherche pas des noms d’API de douze mots. Je veux que le modèle s’explique lui-même.
Classifiez ce qui compte : les champs de taxonomie
Section intitulée « Classifiez ce qui compte : les champs de taxonomie »Salesforce donne à chaque champ un ensemble de métadonnées de classification. Je les appelle les champs de taxonomie. Vous pouvez enregistrer le propriétaire des données (Data Owner) ; l’utilisation du champ (Active, DeprecateCandidate, Hidden) ; le niveau de sensibilité des données (Public, Internal, Confidential, Restricted, MissionCritical) ; et la catégorisation de conformité : PII, HIPAA, GDPR, PCI, CCPA et d’autres. Ils fonctionnent sur les champs standard comme sur les champs personnalisés (Data Classification Metadata Fields (opens in a new tab), en anglais).
Pourquoi s’en soucier ? Parce que des processus peuvent les lire. Marquez un champ GDPR et un processus peut trouver tous les champs GDPR d’un enregistrement et les masquer ou les supprimer. Et quand la couche de confiance de Salesforce envoie une invite à un grand modèle de langage, elle peut utiliser exactement cette classification pour masquer les champs sensibles : elle remplace le nom d’un client, disons « Maria Lopez », par un espace réservé à l’aller, le modèle ne voit jamais le nom, et le nom est remis dans la réponse au retour (Einstein Trust Layer (opens in a new tab), en anglais).
Une mise à jour. Salesforce documente désormais que le masquage par motif et par champ pour les LLM est désactivé pour les agents : le masquage peut retirer le contexte dont un agent a besoin pour répondre (Data Masking Limitations in Agentforce (opens in a new tab), en anglais). La classification pilote toujours le masquage pour les autres fonctionnalités d’IA générative, mais ne comptez pas sur elle pour tenir les données personnelles à l’écart d’un agent ; c’est une décision d’accès et de conception (chapitre 12).
Ma position : la classification compte aux moments clés. N’en faites pas trois semaines à remplir chaque case parce que la gouvernance l’a dit. Utilisez-la là où elle compte : données personnelles, données financières, données réglementées, et champs pour lesquels le métier a besoin d’un propriétaire nommé. L’idée est que la sensibilité cesse d’être un savoir dans la tête de quelqu’un et devienne une partie du champ.
Au-delà de l’examen : ce que l’IA change. Une mauvaise documentation des champs pénalisait autrefois l’administrateur suivant. Maintenant, elle induit en erreur chaque outil d’IA et chaque agent qui lit le schéma :
Flag2__cest-il sensible, fait-il foi, est-il encore utilisé ? L’IA crée aussi des champs plus vite que n’importe quelle équipe, donc noms, descriptions et classification font partie de l’architecture, pas du ménage.
Chaque champ est un engagement
Section intitulée « Chaque champ est un engagement »Une fois qu’un champ est en service et collecte des données, tout commence à s’appuyer dessus. Les écrans l’affichent, les flows bifurquent selon sa valeur, les règles de validation le vérifient, les rapports regroupent par lui, les intégrations l’envoient et le lisent, et maintenant les outils d’IA raisonnent dessus. Chacun d’eux fait des hypothèses sur le champ : son type, sa longueur, s’il est parfois vide, et ce que signifient ses valeurs. Modifiez le champ plus tard et vous devez d’abord retrouver chacune de ces hypothèses. Renommer une valeur de liste de sélection, raccourcir un champ texte ou transformer un champ Texte en liste de sélection ressemble à un petit changement, et cela peut casser une intégration dans le système d’une autre entreprise. C’est pourquoi un champ est un engagement.
Je ne veux pas que vous sortiez de ce module en ayant peur de créer des champs. Salesforce est conçu pour être étendu ; servez-vous-en. Je veux que la question passe de « quel type de champ choisir ? » à « que signifient ces données, et à quel comportement nous engageons-nous ? ». Type, obligatoire, unique, ID externe, liste de sélection, formule, description, classification : ensemble, ils sont l’expression physique du modèle logique du chapitre 2.
Ce que l’architecte décide ici
Section intitulée « Ce que l’architecte décide ici »- Ce que signifie la valeur avant de choisir le type de champ, et s’il s’agit d’un attribut, d’un identifiant, d’un vocabulaire contrôlé ou en réalité d’une autre entité.
- Si une valeur est un calcul actuel qui peut être dérivé ou un fait historique qui doit être stocké.
- Quel système possède chaque identifiant, et si son unicité est une vraie promesse métier.
- Quand une valeur obligatoire est réellement connue, et ce qui arrive aux enregistrements et aux intégrations qui ne l’ont pas.
- Quelle description, quel nommage et quelle classification le champ demande pour que les personnes, les processus et l’IA puissent l’utiliser en toute sécurité.
Pour aller plus loin
Section intitulée « Pour aller plus loin »- Aide Salesforce, Data Classification Metadata Fields (opens in a new tab) (en anglais), consulté le 2026-10-02.
- Aide Salesforce, Einstein Trust Layer: Designed for Trust (opens in a new tab) et Data Masking Limitations in Agentforce (opens in a new tab) (en anglais), consulté le 2026-10-02.
- Salesforce Developers, Insert or Update (Upsert) a Record Using an External ID (opens in a new tab) (en anglais), consulté le 2026-10-02.
- Aide Salesforce, Picklist Limitations (opens in a new tab) (en anglais), consulté le 2026-10-02.
- Aide Salesforce, Formula Field Limits and Restrictions (opens in a new tab) (en anglais), consulté le 2026-10-02.
- Salesforce Developers, Date Formats and Date Literals (opens in a new tab) (en anglais), consulté le 2026-10-02.