
字段也是架构
另有 28 种语言版本
English · Español · 日本語 · Português (Brasil) · Français · Deutsch · Italiano · 한국어 · Português (Portugal) · 繁體中文 · Bahasa Indonesia · Türkçe · Polski · Tiếng Việt · ไทย · Nederlands · العربية · עברית · Українська · हिन्दी · Русский · Svenska · Dansk · Norsk bokmål · Suomi · Español (México) · Français (Canada) · Deutsch (Schweiz)
第 6 个模块,共 10 个,属于 Data Architect 课程第 3 章Salesforce 数据架构。每个模块都可以单独阅读。 上一篇:选择合适的对象 · 下一篇:关系会带来后果
**本模块回答的问题:**Salesforce 应该如何在物理上表示每一份数据?
创建一个字段大约只要一分钟。新建字段,选个类型,起个名字,下一步,下一步,保存。正因如此,字段才没有被当作架构来对待。
走进一个已经运行了十年的 org,打开客户对象。五百个字段。Status2__c、Legacy_Status__c、Old_Status__c、Status_New__c。三个不同的客户编号。一个没人敢删的复选框,因为没人知道还有哪个集成在用它。创建字段只花了一分钟,和它共处却要好几年。所以本模块的思想很简单:**一个字段就是一个架构决定。**不一定是大决定,但每个字段都编码了关于数据的含义、行为、身份或质量的某些东西,而且和对象一样,字段容易添加,拿掉却出人意料地难。
这份数据实际上意味着什么?
Section titled “这份数据实际上意味着什么? ”在第 2 章里,我们给实体加上了属性:一次配送有一个排定的时间窗口,一辆卡车有一个 VIN。现在我们要实现它们,而人们往往会在这里直接跳到“文本字段”。等一下。在选类型之前,我想知道数据意味着什么。它是一个数字,还是一个恰好由数字组成的标识符?是一个日期,还是一个时刻?是自由文本,还是一组认可值中的一个?由人输入,还是由另一个系统拥有?它会变吗?必须唯一吗?可以缺失吗?它应该被存储,还是计算出来?这些不是设置界面上的问题,而是数据架构问题,字段类型要在我们回答它们之后才定。
数字不一定是数字
Section titled “数字不一定是数字 ”Steve Trucking 给每辆卡车一个车队编号,比如 001247。用数字字段?多半不是。我们会把车队编号相加吗?1247 号卡车减去 1246 号卡车等于一辆卡车吗?它是一个恰好包含数字的标识符,而数字字段甚至会把前导零去掉。邮政编码、产品代码、账号和运单号也都一样。一个值看起来是什么样,并不能告诉你它意味着什么。按你需要的行为来选类型,而不是按样本数据看起来的样子。
需要人来识别它吗?
Section titled “需要人来识别它吗? ”每个自定义对象都有一个 Name 字段,第一个决定就是用文本还是自动编号。我会问:**需要人来识别这样东西吗?**人们通过名字认识零售合作伙伴,通过车队编号认识卡车。但系统每晚生成的装货清单呢?没有人应该因为 Salesforce 要求填 Name,就去敲“10-02 第 3 号装货清单”。给它一个自动编号。只是不要把这个生成的 Name 和记录的身份混为一谈:自动编号是帮助用户的,Salesforce ID 识别记录,而零售合作伙伴自己的装货清单编号可能在各个系统间识别同一样东西。三份不同的工作。
详细信息界面
Section titled “详细信息界面 ”选一个类型,点击“下一步”,设置就会要求你填写详细信息。本模块里的大多数决定,实际上都是在这个界面上做出的,而且通常是匆匆做出的。
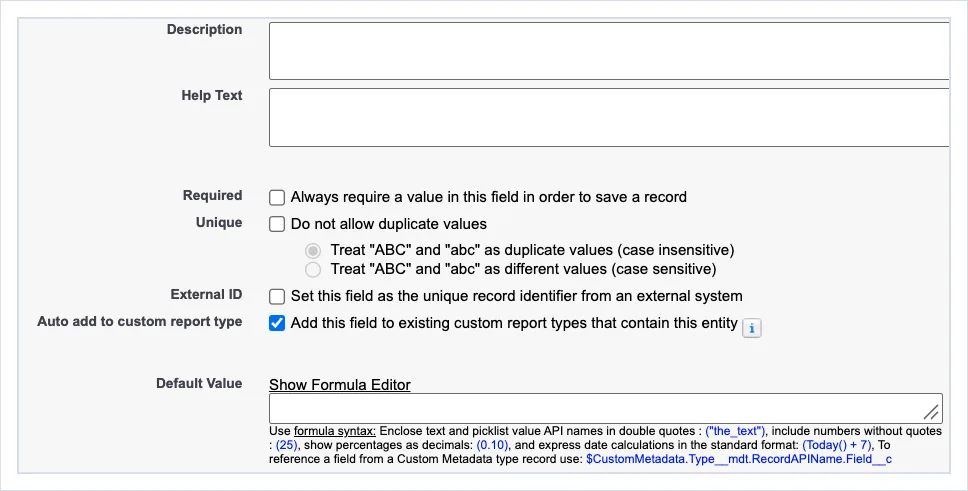
新建自定义字段,第 2 步:详细信息(截图,2026-10-12)。 查看大图
有两个框看起来很像,干的却是不同的活。Description(描述)是给维护这个 org 的人看的,现在也是给读取它的 AI 工具看的:这个字段是什么意思,谁拥有它,它从哪里来。Help Text(帮助文本)是给界面前的用户看的:这里该填什么。两个都要填。接下来是 Required(必填)、Unique(唯一)和 External ID(外部 ID),它们每一个都值得单独用一节来讲。在它们下面,Default Value(默认值)可以是一个公式,这样新记录一开始就能有一个合理的值,而不是空白。
必填是一个比看上去更大的决定
Section titled “必填是一个比看上去更大的决定 ”字段向导里有一个小小的复选框,标签是必填,而正如我们在第 1 章看到的,它可能是一颗定时炸弹。你有一个用了五年、有两百万条记录的对象,现在有人决定一个新字段必须始终有值。那两百万条在它之前就存在的记录怎么办?不发送这个值的集成怎么办?在值还不知道时就创建记录的自动化怎么办?值要到三步之后才出现的流程怎么办?
“必填”听起来像一个数据质量的决定,有时它确实是。但值什么时候为人所知,是业务流程的一部分。所以不要因为有人说“我们总是想要那个值”就勾选必填。要问它什么时候能知道,由谁提供,以及不知道时会怎样。我们会在模块 7 中把这一点放到完整的一致性阶梯上。
唯一也是有含义的
Section titled “唯一也是有含义的 ”如果我把一个字段标记为唯一,我就是在对业务做出一个声明:不是“它通常不会重复”,而是**“两条记录永远不能有这个值”。**这是很强的声明。而且这个界面还要你再决定一件事:“ABC”和“abc”是同一个值,还是不同的值?对于任何由人输入的内容,不区分大小写是更安全的默认选择。第 2 章关于键的规则,唯一、不变、无含义、绝不是 PII,在这里同样适用。如果有人告诉我员工邮箱是唯一的,我就会开始问:它会变吗?有人离职后会回来吗?地址会被重复使用吗?收购之后会怎样?邮箱也许有用,甚至今天是唯一的,但这不会让它成为一个好的标识符。
外部 ID:跨越边界的身份
Section titled “外部 ID:跨越边界的身份 ”这正是外部 ID 大显身手的地方。界面上的说明讲得很好:这个字段会成为“来自外部系统的唯一记录标识符”。ERP 里有客户 873492;Salesforce 有自己的记录 ID。当 ERP 发来一次更新时,我们怎么知道它属于哪条记录?把一个字段标记为外部 ID,集成就可以基于它做 upsert(更新插入):记录不存在就创建,存在就更新(Upsert a Record Using an External ID (opens in a new tab),英文)。而且当你加载子记录时,可以通过外部 ID 来指向父记录,而不必先去查询 Salesforce ID。我常说,你让 Salesforce 替你做了查找。非常强大。
注意,ERP 的编号并没有成为 Salesforce 记录的身份。它是一个属性,而一条记录可以带有好几个:一个 ERP 客户 ID、一个遗留 ID、一个合作伙伴的 ID。这没问题。一个业务实体可以被好几个系统以不同的方式认识。架构问题是哪个系统拥有每个标识符,以及它做出了什么承诺:只有当业务真的保证唯一时,才把它标记为唯一。
逐个字段类型来看
Section titled “逐个字段类型来看 ”现在来看类型本身。在任何对象上打开 New Field(新建字段),设置就会把整个列表展示给你,分组方式和我接下来要讲的顺序一样:Salesforce 替你计算的字段、关系字段,然后是各种数据类型。
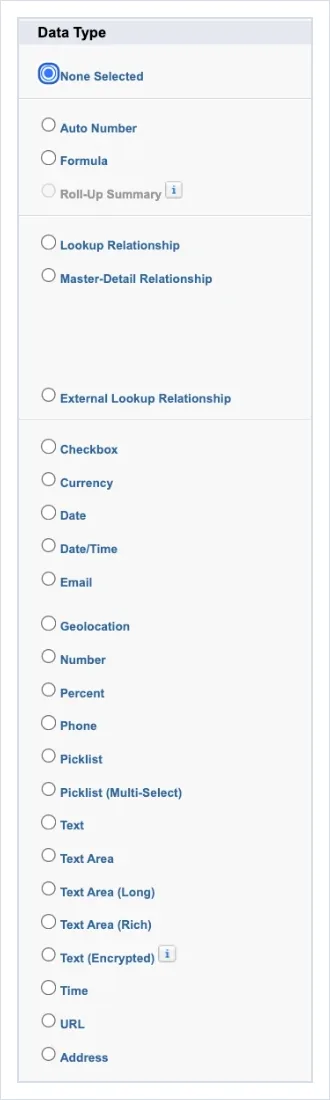
设置,新建自定义字段,第 1 步:数据类型(截图,2026-10-12)。 查看大图
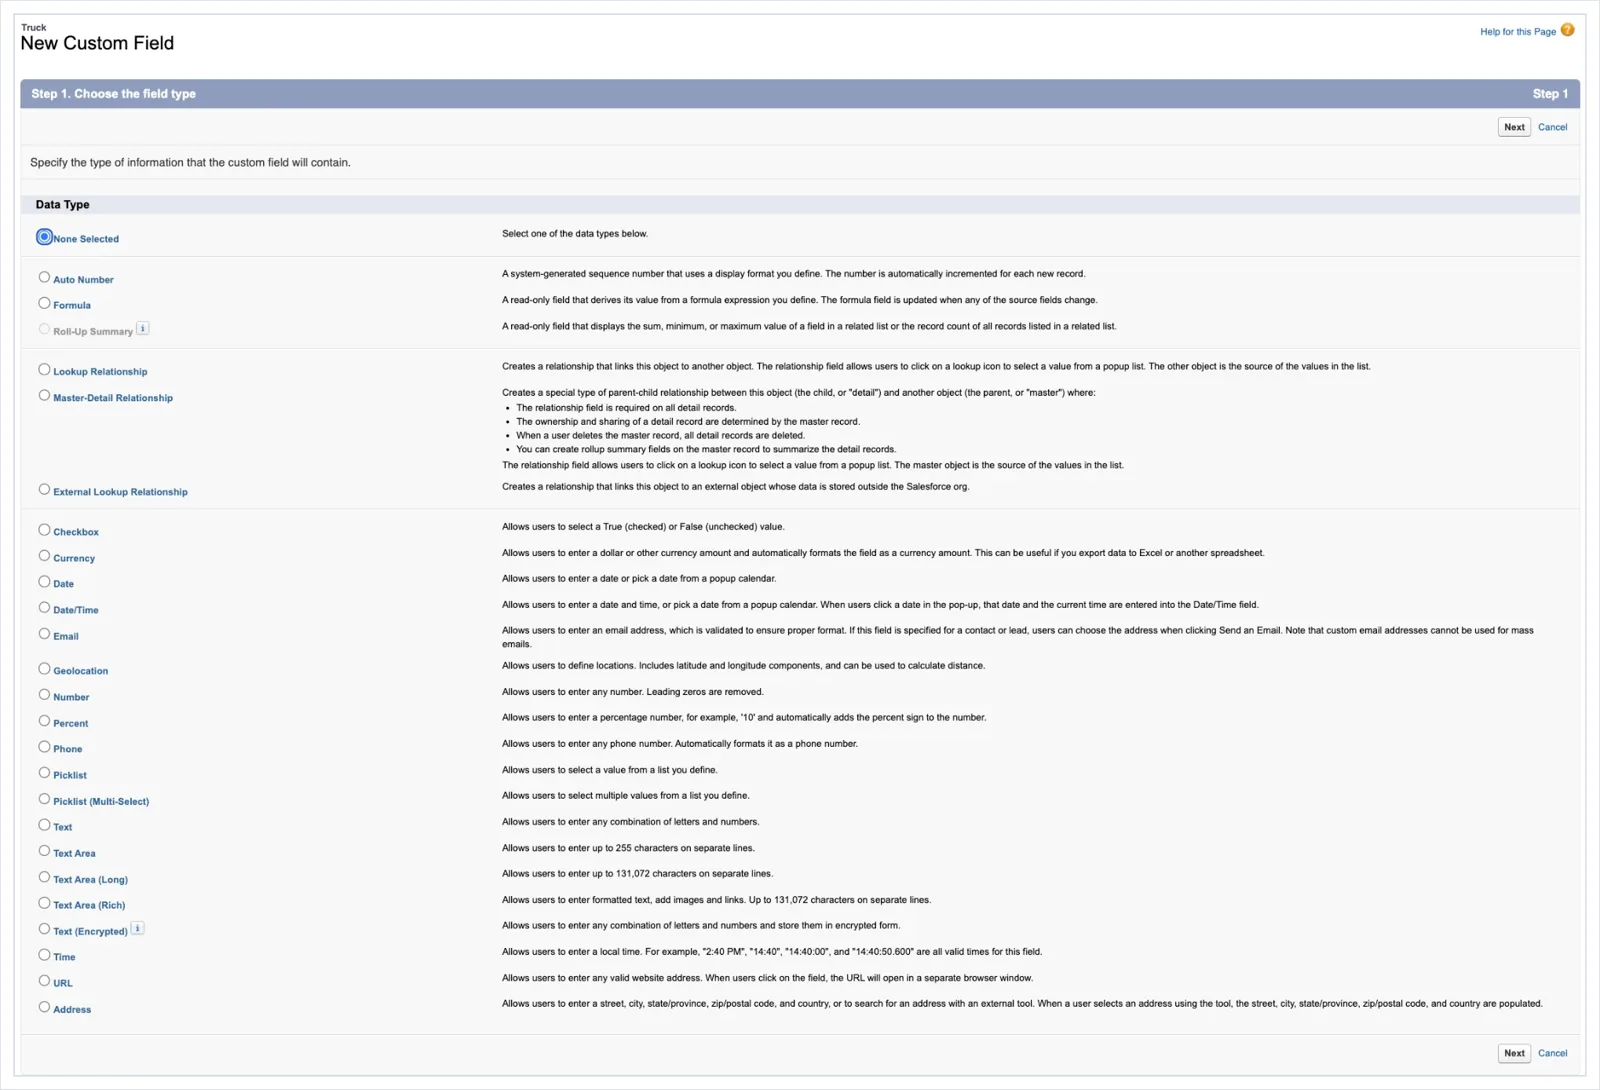
下面是整个列表的一览,每一种都附上我希望你记住的那一点。
| 分组 | 类型 | 要记住的 |
|---|---|---|
| 计算型 | 自动编号(Auto Number) | 最多 30 个字符,其中 20 个用于前缀或后缀;是给人看的标签,而不是记录的标识 |
| 公式(Formula) | 读取时计算,不存储;3,900 个字符 | |
| 汇总(Roll-Up Summary) | 对明细记录计数、求和、取最小值或最大值;仅限主从关系 | |
| 关系 | 查找、主从、外部查找(Lookup、Master-Detail、External Lookup) | 模块 7 |
| 数据 | 复选框(Checkbox) | 真或假,默认值由你选择;在流程中仍可能出现 null |
| 数字、百分比、货币(Number、Percent、Currency) | 舍入规则;前导零会被去掉;15 位小数 | |
| 日期、日期/时间、时间(Date、Date/Time、Time) | 一天、一个时刻,或一天中的某个时间;时刻以 UTC 存储 | |
| 电子邮件、电话、URL(Email、Phone、URL) | 保存时会格式化并检查:80、40 和 255 个字符 | |
| Geolocation、地址(Address) | 复合字段,占用不止一个字段:3 个和 9 个 | |
| 选项列表、多选选项列表(Picklist、Multi-Select) | 一套受控词汇,由管理员拥有 | |
| 文本、文本区域、长文本区域、富文本区域、加密文本(Text、Text Area、Long、Rich、Encrypted) | 最多 255 个字符时存储在记录上,可以建索引;超过之后,就不能建索引,也不能筛选 |
Salesforce 替你计算的字段
Section titled “Salesforce 替你计算的字段 ”自动编号会按你定义的格式(比如 T-{000000}),给每条新记录分配序列中的下一个编号。当人需要一个好用的称呼、又不该让任何人去编一个的时候,就用它。整个值最多 30 个字符,其中 20 个留给前缀或后缀。只是要记住第 2 章讲的:它是给人看的标签,而不是记录的标识,而且编号并不总是严格连续的。
公式字段根据其他字段计算出一个值。它们很强大,而且是在记录被读取时计算,而不是在保存时计算,所以没有存下来的东西会过时。公式返回什么由你选择:复选框、货币、日期、日期/时间、数字、百分比、文本或时间。
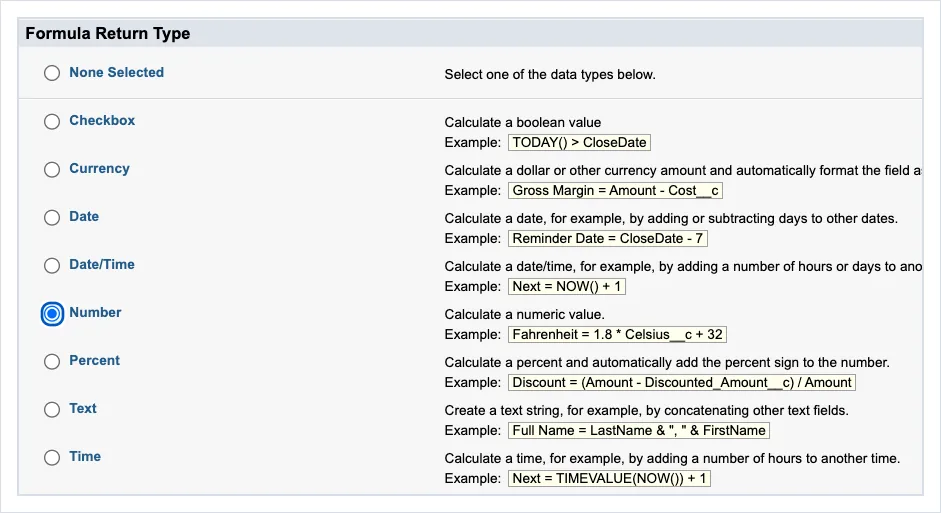
新建自定义字段,公式:选择返回类型(截图,2026-10-12)。 查看大图
然后你用字段、运算符和函数写出公式本身,并检查它的语法。注意那个 Use Formula Assistant(使用公式助手)按钮:Salesforce 的 AI 现在会帮你写公式。用它,然后读一读它写了什么。公式归你负责,而不是归助手负责。
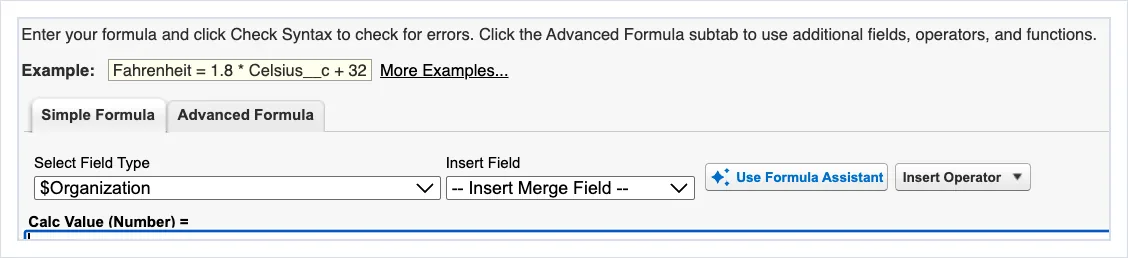
公式编辑器,带有公式助手(截图,2026-10-12)。 查看大图 一个公式最多可以有 3,900 个字符,保存或编译后不能超过 15,000 字节;一个很长的公式可以拆分到几个相互引用的公式字段中。长文本区域、加密字段和 Description 字段都不能在公式中使用。
汇总字段放在主记录上,对它的明细记录计数、求和,或者取最小值、最大值。它们只能跨主从关系使用,这是选择主从关系的最大理由之一。我们会在模块 7 中再回到它们以及它们的限制。
存储还是推导?
Section titled “存储还是推导? ”**我们到底需不需要存储这个值?**如果我有数量和单价,是否需要有人或某个自动化去维护一个总额?也许应该用一个公式来推导它:计算只有一个来源,读取时重新计算,所以改了数量,答案就跟着变。公式有它自己的限制(保存大小和显示长度;Formula Field Limits and Restrictions (opens in a new tab),英文),而复杂的公式会很难维护。
但有时业务要的不是今天的答案,而是当时的答案。如果折扣规则明年变了,去年的发票应该突然显示一个不同的金额吗?当然不应该。所以问题不是“Salesforce 能不能算出这个?”,而是**“这是一个当前的计算,还是一个历史事实?”**历史事实要存储下来。
查找(Lookup)、主从(Master-Detail)和外部查找(External Lookup)关系也都是字段,你的模型里的那些连线正是在这里变成现实的。查找是松散的连接;主从把子记录的生命周期、所有权和安全都绑在父记录上;外部查找则通过外部 ID 进行匹配,连接到模块 4 里讲的外部对象。在它们之间做选择,是一个大到值得单独一个模块的决定。
复选框是最简单的字段:真或假,勾选或不勾选。它非常适合表示关于记录的一个是/否事实:是否有效(Is Active)、是否需要安装(Install Required)、是否已签收(Signed For)。创建复选框时,Salesforce 会要求你选择它的默认值,勾选还是不勾选,而这是一个真正的决定:每条新记录都从这个值开始,包括集成在没有发送这个字段的情况下创建的记录。报表和列表视图按 True 和 False 来筛选它;导入工具和每周导出则把它显示为 1 和 0。
有一个陷阱要知道。记录上的字段只有两个值,但它周围的自动化可能有第三个值。在流程(Flow)中,一个从未被赋值的复选框变量是 null,而不是 false,把它保存到记录上会失败(Trailblazer Community (opens in a new tab),英文;另见 Salesforce 已知问题 W-11208535 (opens in a new tab),英文)。选一个合理的默认值,并让你的流程和代码有意识地处理 null。
数字、百分比和货币
Section titled “数字、百分比和货币 ”数字存储一个实数,并且会去掉所有前导零,这正是像 001247 这样的车队编号不能用数字字段的原因。Salesforce 对数字字段采用四舍五入(远离零方向):12.345 变成 12.35,−12.345 变成 −12.35。而在合并字段中,它会按用户的区域设置来舍入,而不是按你在字段上设置的小数位数。
百分比存储一个小数,并以百分比显示:输入 0.10,你看到的是 10%。超过 15 位小数后,值会失去精度。
货币按金额格式显示,在使用多种货币的 org 中,它带有货币代码,并且可以使用汇率;启用高级货币管理 (opens in a new tab)(英文)后,业务机会可以使用带日期的汇率,也就是交易成交那个期间的汇率。只有业务机会及其周边的东西(产品、计划、拆分以及它们的报表)使用带日期的汇率;其他对象上的货币字段仍使用单一的静态汇率。注意舍入:没有小数位时,Salesforce 会直接截断(23.5 变成 23);有一位或更多小数位时,则四舍五入(远离零方向)。
日期、日期/时间和时间
Section titled “日期、日期/时间和时间 ”三种类型,三种不同的含义。日期是一天:合同在某个日期到期。日期/时间是一个时刻:配送在那天上午 9:42 到达。时间是一天中的某个时间,完全不带日期:门店每天 7:00 开门。
陷阱在于时刻。Salesforce 以 GMT(UTC)存储日期/时间值。用户输入的时间按他们自己的时区来解读、转换,然后存储;当有人读取它时,又会再转换成读取者的时区。大多数时候,这正是你想要的。但这是我在课上举的例子:洛杉矶(Los Angeles)的一位协调员在周日深夜,太平洋时间晚上 10 点,记录了一次配送。在底层,Salesforce 存储的是周一早上,GMT 早上 5 点。一份在另一个时区按天分组的报表,或者一个读取原始值的集成,都可能把这次周日的配送算到周一。“发生的那一天”取决于你问的是谁的时钟。留意用户的时区,并决定业务指的是哪一个。
比较它们时也要小心。在底层,日期/时间就是一个很大的数字:Apex 把它读作自 1970 年 1 月 1 日 00:00:00 GMT 起的毫秒数(Datetime Class (opens in a new tab),英文)。它是一个精确的时刻,而不是一天。所以问两个日期/时间是否相等(==),几乎从来都达不到你想要的效果:9:42:00 和 9:42:01 不相等,“周一”和周一的任何一个时刻也不相等。应该改为问一个范围:大于等于开始时间(>=),并且小于等于结束时间(<=)。“周一的每一次配送”就是每一次 >= 周一 00:00 并且 <= 周一 23:59:59 的配送,用的是你认定业务所指的那个时区。
还有一个有趣的:Salesforce 不能存储任意日期。有效日期的范围是从 1700 年 1 月 1 日到 4000 年 12 月 31 日,Salesforce 对日期和日期/时间给出的是同一个范围(Data Import Dates (opens in a new tab),英文)。连这两端也是 GMT 的时刻,所以对于太平洋时区的用户,最早的有效值是 1699 年 12 月 31 日下午 4 点。你所在的历史学会的成立日期可能就存不进去。而经典的“没有结束日期”的招数,9999 年 12 月 31 日,会被拒绝;如果你需要一个遥远未来的占位值,它必须在 4000 年或之前。
电子邮件、电话和 URL
Section titled “电子邮件、电话和 URL ”这些是有格式的字段,它们做的不只是存储字符。电子邮件最多 80 个字符,会检查格式是否正确;在联系人和潜在客户上,点击它就会开始给这个地址写邮件。电话最多 40 个字符,按电话号码格式显示,当 org 接入了电话系统时,就可以点击拨号。URL 最多 255 个字符,会作为链接打开。这是平台免费送给你的行为,所以我绝不会把电话号码存在一个普通的文本字段里。
集成也会被检查。一个不符合字段格式的值,比如一个格式错误的电子邮件地址,会验证失败,而整条记录都会被拒绝,不只是那个字段。所以当源系统的数据很乱时,要在它到达之前清理干净,或者为那些加载不进来的记录做好计划。
Geolocation 和地址
Section titled “Geolocation 和地址 ”Geolocation 存储一个纬度和一个经度。在底层,一个叫 Location__c 的字段其实是两个可以单独读取和设置的值:Location__Latitude__s 和 Location__Longitude__s。而且你可以基于它查询:SOQL 的 DISTANCE 和 GEOLOCATION 函数可以找出某个半径内的记录,或者按距离远近排序。“这辆卡车 25 英里范围内的每一次未完成配送”只需要一条查询:WHERE DISTANCE(Location__c, GEOLOCATION(33.45, -112.07), 'mi') < 25(Location-Based SOQL Queries (opens in a new tab),英文)。地址(Address)存储一个完整的地址:街道、城市、州或省、邮政编码和国家,用户可以搜索一个地址,然后自动填好各个部分。
两者都是复合字段:界面上是一个字段,底层是好几个。而且在对象的字段数量限制中,它们占用的不止一个字段:一个 Geolocation 算作三个自定义字段,一个地址算作九个。在一个已经很拥挤的对象上,这一点很重要。
选项列表和多选选项列表
Section titled “选项列表和多选选项列表 ”选项列表控制用户可以输入什么:从你定义的列表中选一个值。状态?多半是选项列表。但这些值是元数据,必须由管理员来添加或修改。所以我仍然会问:谁拥有这些值,它们多久变一次,是否有多个对象需要同一份列表,这些值是否带有自己的信息,是否有另一个系统拥有这套词汇。
值放在哪里也是一个决定。当一份列表只用一次、只用在一个字段上时,就把值放在字段本身、放在对象上;这也是 Salesforce 的默认做法。但当同一组值开始出现在好几个地方,比如客户上、配送上和仓库上都有一个区域(Region),就要把它提升为全局值集,以免各个副本渐渐走样。全局值集为它们共同维护一份列表,最多 1,000 个值,有效和无效的加在一起计算(Picklist Limitations (opens in a new tab),英文)。设置界面自己的说明道出了它为什么重要:这个值集“is restricted so users can’t add unapproved values through the API”(受到限制,用户无法通过 API 添加未经批准的值)。一份列表,一个所有者,没有哪个集成能偷偷塞进一个新的拼写。
最后这一点,就是受限和不受限的区别。在受限选项列表上,只允许管理员定义的值,无论来自哪里:用户、导入或集成只要发送了别的值,就会收到一个错误,“bad value for restricted picklist field”,记录也不会被保存。在不受限选项列表上,用户在界面上仍然从列表中选择,但 API、导入和自动化可以发送任何值,Salesforce 会保存它,并把它添加为一个无效值(Picklist Limitations (opens in a new tab),英文;Create a Custom Picklist Field (opens in a new tab),英文)。一个 org 就是这样最后同时有了“Delivered”、“delivered”和“Dlvrd”。全局值集总是受限的。我的默认选择是受限;不受限是一个有意的选择,只用于确实由另一个系统拥有这些值的情况,而且那时要有人负责清理那些无效值。
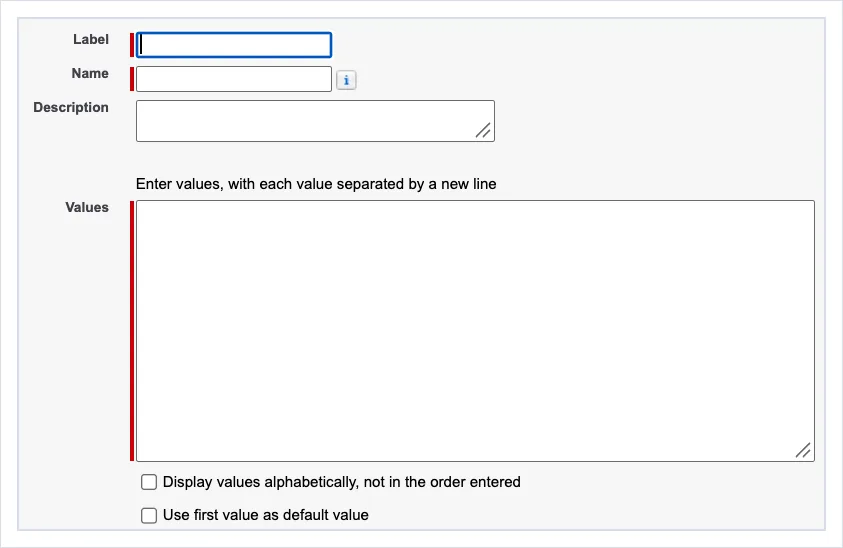
设置,选项列表值集:一个新的全局值集(截图,2026-10-12)。 查看大图
多选选项列表允许用户选择多个值,这些值以分号分隔,存储在一起。在界面上很方便,在其他所有地方都很别扭:更难筛选、做报表和集成,而且不能用在汇总字段的筛选条件里。一条记录有好几个值,通常意味着第 2 章的那一课:有一个子对象正想要冒出来。
选项列表还比你定义的那些值多一个值:空白。一条记录可以什么都没选,这一点会让人掉坑。在公式或验证规则中,你不能单独用 ISBLANK 来测试选项列表;你要写 ISBLANK(TEXT(Field__c)),或者 ISPICKVAL(Field__c, "")(Trailblazer Community (opens in a new tab),英文)。所以要为每个选项列表决定“没有值”意味着什么:允许吗?出现时又意味着什么?然后让你的公式、验证规则和筛选条件处理好它。
有时一个属性其实是一个实体。有人要一个配送中心的选项列表。一共九个。很简单。然后我们了解到,每个配送中心都有地址、经理、营业时间、容量、区域和卡车。那不是选项列表,那是一样东西。**不要只因为它们现在数量还不多,就把一个实体变成选项列表。**第一年感觉很好,第五年就很糟。(第 2 章的模块 5 里有我关于一份列表何时挣得自己的对象的经验法则。)
我把文本分成两类来讲,两者的分界线是 255 个字符。
最多 255 个字符:和记录存储在一起。 文本最多 255 个字符,几乎在任何地方都能用:公式、筛选条件、报表、列表视图,可以作为唯一字段或外部 ID,还可以建索引。文本区域同样最多 255 个字符,可以分行,就像一条简短的备注。
超过 255 个字符:通过引用存储。 长文本区域最多 131,072 个字符,富文本区域容量相同,还能带格式、链接和图片。我把它们想象成存放在旁边,记录上只保留一个指针,而它们的表现也确实如此:没有索引,所以不能把它们设为唯一或外部 ID;不能在 SOQL 的 WHERE 子句中筛选它们(SOQL WHERE (opens in a new tab),英文);公式不能使用它们(Formula Field Limits and Restrictions (opens in a new tab),英文);报表对自定义的这类字段只显示前 254 个字符,报表筛选条件也只搜索前 255 个字符左右(Filter Restrictions for Text Area (Long) Fields (opens in a new tab),英文)。上传到富文本字段里的图片每张最大 1 MB,计入文件存储,而文本计入数据存储(Rich Text Area Field Considerations (opens in a new tab),英文)。所以,如果有人需要对这个值做搜索、排序、匹配或报表,就把它控制在 255 个字符以内,并保持为文本字段。
加密文本(Text (Encrypted))使用经典加密(Classic Encryption),以加密形式存储最多 175 个字符。如果你的 org 使用 Shield Platform Encryption,你就改为加密一个普通的文本字段,而且很多其他类型也可以用这种方式加密。
给每个字段写描述
Section titled “给每个字段写描述 ”我的标准是:**每个字段都要有描述。**我坚持这一点很久了,而在 AI 时代,它比以往任何时候都更重要:每一个读取你的 org 的 AI 工具和智能体,都要靠读描述来理解一个字段的含义。空着的描述,就是一个随时会发生的猜测。Customer_Status__c 是什么意思?谁拥有它?它从哪里来?用户能编辑它吗,还是今晚 ERP 会把它覆盖掉?六个月后我就不记得了,三年后维护这个 org 的管理员也不会知道,除非我们告诉过他们。标签不是文档,API 名称也不是。
在共享程度很高的对象上(客户、联系人、业务机会),我还会给专用字段使用命名前缀,让它们的来源和用途直接体现在名字里:比如 ERP 拥有的所有字段都以同一个前缀开头。我不是追求十二个单词长的 API 名称。我要的是模型能自己解释自己。
给重要的东西分类:分类字段
Section titled “给重要的东西分类:分类字段 ”Salesforce 为每个字段提供了一组分类元数据。我把它们叫作分类字段。你可以记录 data owner(数据所有者);field usage(字段用途:Active、DeprecateCandidate、Hidden);data sensitivity level(数据敏感级别:Public、Internal、Confidential、Restricted、MissionCritical);以及 compliance categorization(合规分类):PII、HIPAA、GDPR、PCI、CCPA 等。它们既适用于自定义字段,也适用于标准字段(Data Classification Metadata Fields (opens in a new tab),英文)。
为什么要费这个事?因为流程可以读取它们。把一个字段标记为 GDPR,一个流程就能找出一条记录上所有的 GDPR 字段,并把它们掩码或删除。而当 Salesforce 的信任层把一个提示发送给大语言模型时,它可以正是用这种分类来掩码敏感字段:在发出去时把客户的名字,比如“Maria Lopez”,换成一个占位符,模型永远看不到这个名字,在回来时再把名字换回响应里(Einstein Trust Layer (opens in a new tab),英文)。
一则更新。Salesforce 现在的文档说明,针对大语言模型的基于模式和基于字段的掩码对智能体是禁用的:掩码可能会剥离智能体回答所需的上下文(Data Masking Limitations in Agentforce (opens in a new tab),英文)。分类仍然会为其他生成式 AI 功能驱动掩码,但不要指望它让个人数据远离智能体;那是一个访问和设计层面的决定(第 12 章)。
我的立场是:**分类在关键时刻很重要。**不要因为治理部门说了,就把它变成三周时间去填满每一个框。在重要的地方使用它:个人数据、财务数据、受监管的数据,以及业务需要一位指定所有者的字段。重点是,敏感性不再是某个人脑子里的知识,而是成为字段的一部分。
**考试之外:AI 改变了什么。**糟糕的字段文档过去惩罚的是下一位管理员。现在它会误导每一个读取结构的 AI 工具和智能体:
Flag2__c是敏感的吗?是权威的吗?还在用吗?AI 创建字段的速度也比任何团队都快,所以名称、描述和分类是架构的一部分,而不是打扫卫生。
每个字段都是一份承诺
Section titled “每个字段都是一份承诺 ”一个字段一旦投入使用、开始收集数据,所有东西就都开始依赖它。界面显示它,流程根据它分支,验证规则检查它,报表按它分组,集成发送它、读取它,而现在 AI 工具还会基于它进行推理。它们每一个都对这个字段做了假设:它的类型、它的长度、它是否会为空,以及它的值意味着什么。以后要修改这个字段,你得先把这些假设一个个找出来。重命名一个选项列表值、缩短一个文本字段,或者把一个文本字段改成选项列表,听起来都是小改动,却可能让另一家公司系统里的一个集成崩掉。这就是为什么一个字段是一份承诺。
我不希望你学完这个模块后就不敢创建字段了。Salesforce 生来就是要被扩展的;用它。我希望问题从“我该选哪种字段类型?”变成**“这份数据意味着什么,我们在承诺什么样的行为?”**类型、必填、唯一、外部 ID、选项列表、公式、描述、分类:它们合在一起,就是第 2 章逻辑模型的物理表达。
架构师在这里决定什么
Section titled “架构师在这里决定什么 ”- 在选择字段类型之前,这个值意味着什么,以及它是一个属性、一个标识符、一套受控词汇,还是其实是另一个实体。
- 一个值是可以推导出来的当前计算,还是必须存储的历史事实。
- 哪个系统拥有每个标识符,以及它的唯一性是否是一项真正的业务承诺。
- 一个必填的值实际上什么时候能知道,以及没有这个值的记录和集成会怎样。
- 字段需要什么样的描述、命名和分类,才能让人、流程和 AI 安全地使用它。
- Salesforce Help,Data Classification Metadata Fields (opens in a new tab)(英文),查阅日期 2026-10-02。
- Salesforce Help,Einstein Trust Layer: Designed for Trust (opens in a new tab) 和 Data Masking Limitations in Agentforce (opens in a new tab)(英文),查阅日期 2026-10-02。
- Salesforce Developers,Insert or Update (Upsert) a Record Using an External ID (opens in a new tab)(英文),查阅日期 2026-10-02。
- Salesforce Help,Picklist Limitations (opens in a new tab)(英文),查阅日期 2026-10-02。
- Salesforce Help,Formula Field Limits and Restrictions (opens in a new tab)(英文),查阅日期 2026-10-02。
- Salesforce Developers,Date Formats and Date Literals (opens in a new tab)(英文),查阅日期 2026-10-02。