
Gdzie mieszkają te dane?
Dostępne także w 28 językach
English · Español · 日本語 · Português (Brasil) · Français · Deutsch · Italiano · 한국어 · 简体中文 · Português (Portugal) · 繁體中文 · Bahasa Indonesia · Türkçe · Tiếng Việt · ไทย · Nederlands · العربية · עברית · Українська · हिन्दी · Русский · Svenska · Dansk · Norsk bokmål · Suomi · Español (México) · Français (Canada) · Deutsch (Schweiz)
Moduł 4 z 10 w rozdziale Architektura danych Salesforce, rozdziale 3 kursu Data Architect. Każdy moduł jest samodzielny. Wstecz: Zbuduj własny: obiekty niestandardowe · Dalej: Wybierz właściwy obiekt
Pytanie, na które odpowiada ten moduł: zanim utworzysz obiekt, gdzie te dane naprawdę powinny mieszkać: w core, w Salesforce, wskazywane tam, gdzie już są, czy zarchiwizowane?
Zadam ci pytanie. Na biurko trafia nowe wymaganie. Co robisz najpierw?
Jeśli jesteś jak większość z nas, otwierasz Konfigurację i tworzysz obiekt niestandardowy. Rozumiem. W dziesięć minut masz kartę, układ strony i widok listy. A oto co mówię na każdych zajęciach: w chwili, gdy tworzysz ten nowy obiekt, już myślisz jak architekt, czy tego chcesz, czy nie. Bo każdy utworzony obiekt to zobowiązanie. Zajmuje przestrzeń. Podlega limitom. Dostaje model udostępniania, czy go zaprojektowano, czy nie. Wymaga licencji dla każdego, kto go dotyka. A gdy ludzie i integracje zaczną od niego zależeć, powodzenia z jego usuwaniem.
Pierwsza decyzja architektoniczna nie dotyczy więc tego, który obiekt. Dotyczy tego, gdzie te dane powinny mieszkać? Odpowiedz na to dobrze, a typ obiektu niemal wybierze się sam.
W core i poza core
Dział zatytułowany „W core i poza core ”Najpierw słowo, którego będę często używać: core. Core to platforma Salesforce, na której działa twój org: sterowana metadanymi, wielodostępna (multitenant) platforma z modułu 1, na której mieszkają obiekty sprzedaży i obsługi z modułu 2 i każdy obiekt niestandardowy, który zbudujesz w module 3. Kiedy mówię, że dane są w core, mam na myśli, że są przechowywane w twoim orgu, w jego obiektach.
Nie wszystkie dane tam mieszkają. Data 360 trzyma swoje dane we własnym magazynie, poza obiektami twojego orgu (to near-core, czyli blisko core: zarządzane w core, a jego dane hostowane poza core; więcej w rozdziale 4). A do tego wszystko, co twoja firma uruchamia, a co w ogóle nie jest Salesforce: ERP, magazyn, system zamówień, platforma partnera. Wszystko to jest poza core. Salesforce może do tego sięgnąć, pokazać to i tego używać, ale twój org tego nie przechowuje.
W core są dwa rodzaje obiektów, które naprawdę trzymają twoje rekordy: sObjects, standardowe i niestandardowe (__c), oraz big objects (__b). Poza core do danych docierasz przez obiekty zewnętrzne (__x) i inne narzędzia integracyjne. Pamiętaj o tych sufiksach z modułu 3; mówią ci, gdzie mieszka dany fragment danych, już po samej nazwie.
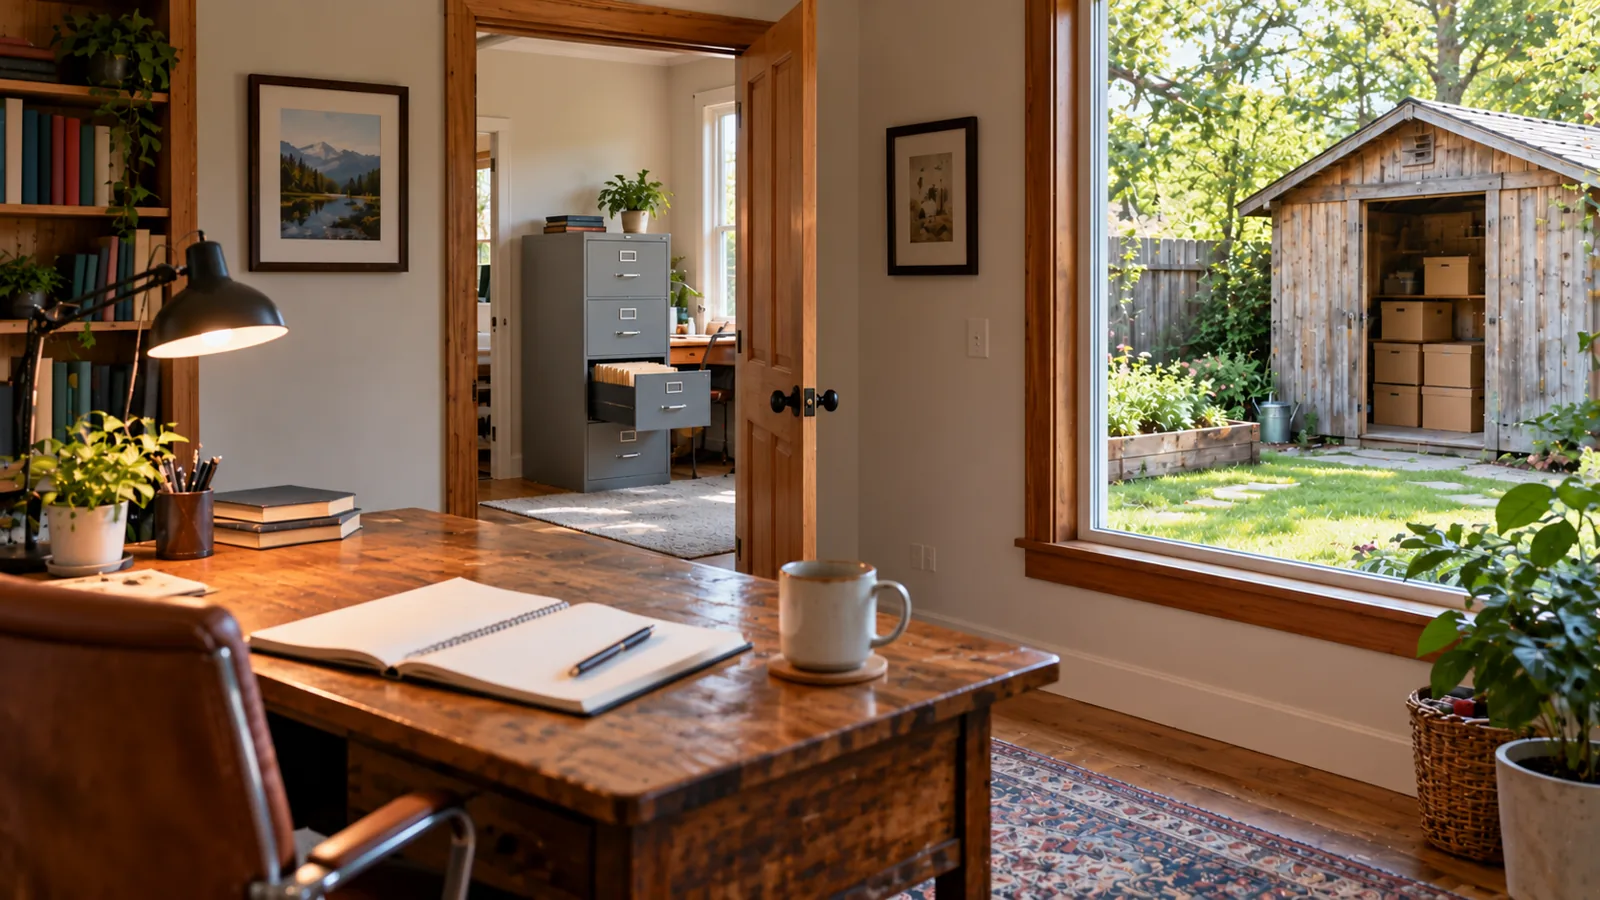
Myślę o tym jak o biurze. Niektóre rzeczy należą na twoje biurko, gdzie używasz ich codziennie. Niektóre trzeba tylko sprawdzić w cudzej szafie z dokumentami. A niektóre trafiają do pudeł w szopie za domem. To daje mi trzy odpowiedzi.
1. W core: mieszkają na twoim biurku
Dział zatytułowany „1. W core: mieszkają na twoim biurku ”Dane są tworzone, zmieniane i używane w Salesforce każdego dnia: konta, zgłoszenia, szanse sprzedaży, zlecenia pracy. Trzymanie ich w sObjects to jak trzymanie ich z przodu biura. Do tego służą obiekty standardowe i niestandardowe, i dostajesz wszystko: układy stron, udostępnianie, automatyzację, raportowanie, wyszukiwanie, a teraz także funkcje AI zbudowane na modelu danych.
Twoje biurko nie jest jednak darmowe. Dane w core kosztują przestrzeń dyskową, liczoną tak, jak liczy ją Salesforce, rekord po rekordzie, a nie kolumna po kolumnie, a dokumenty liczą się osobno do przestrzeni na pliki. Omówiliśmy jedno i drugie w module 2. Duże ilości zdjęć i skanów często należą poza core, a Salesforce trzyma tylko link.
2. Wskazywane: mieszkają w cudzej szafie z dokumentami
Dział zatytułowany „2. Wskazywane: mieszkają w cudzej szafie z dokumentami ”Dane należą do innego systemu (ERP, hurtowni danych, platformy zamówień), a ten system pozostaje źródłem prawdy. Użytkownicy muszą je widzieć w Salesforce, może powiązać je z rekordem, ale Salesforce nie potrzebuje własnej kopii. Usłyszysz też, że to dane wirtualne: pojawiają się w Salesforce wirtualnie, nigdy nie będąc tam przechowywane.
To są obiekty zewnętrzne, przez Salesforce Connect. Lubię mówić, że wygląda jak kaczka i chodzi jak kaczka, ale to nie jest kaczka. Pojawia się jak sObject: możesz umieścić go w układach stron i listach powiązanych rekordów i wiązać z własnymi rekordami przez relacje external lookup i indirect lookup. Ale dane nie są przechowywane w core. Za każdym razem, gdy ich dotykasz, następuje wywołanie zewnętrzne (callout). Otwórz rekord, załaduj listę powiązanych rekordów, uruchom raport, a Salesforce idzie zapytać inny system. To oznacza opóźnienie, a twoja strona jest dostępna tylko w takim stopniu jak system za nią.
Ludzie protestują przeciw kosztowi licencji, więc policz to tak, jak ja na zajęciach. Connect jest licencjonowany na punkt końcowy, a jeden punkt końcowy może wnieść wiele obiektów. Teraz zapytaj, ile kosztuje zbudowanie i utrzymanie alternatywy: niestandardowego komponentu, kodu wywołań za nim i programisty pod telefonem, gdy coś się zepsuje. Często licencja jest tańsza, a administratorzy mogą ją skonfigurować bez pisania linijki kodu. Gdzie się nie sprawdza: przy danych, które użytkownicy edytują cały dzień albo intensywnie na nich raportują.
Dokumenty też można wskazywać. Jeśli umowa mieszka już w SharePoint Online, OneDrive, Google Drive albo Box, Files Connect pozwala użytkownikom dotrzeć do niej z Salesforce bez kopiowania jej.
Salesforce Connect to nie jedyny sposób wskazywania danych. Czasem to własna logika: kod, który w czasie rzeczywistym wywołuje inny system i wyświetla jego dane na stronie, bez zachowywania kopii. To daje ci pełną kontrolę i pełną odpowiedzialność za wywołanie, błędy i utrzymanie. A Data 360 też potrafi federować bez kopiowania. Ten wybór ma własny rozdział (Wirtualizacja, federacja i zero copy). Tu chodzi o samą decyzję: wskazuj, nie kopiuj.
3. Zarchiwizowane: trafiają do szopy za domem
Dział zatytułowany „3. Zarchiwizowane: trafiają do szopy za domem ”Historia, ścieżki audytu, stare transakcje. Musisz je trzymać, czasem latami, ale prawie nikt ich nie otwiera. I to właśnie zespoły odkładają na później. Kiedy grupa na zajęciach mówi mi, że ma obiekt z 50 milionami rekordów, i pyta, po co miałaby archiwizować, odpowiadam pytaniem: jeśli nie archiwizujesz dziś, czy kiedykolwiek będziesz archiwizować? Przy 50 milionach dziś zmierzasz do 100, 150, 200 milionów.
Są dwie szopy. Jedna jest w core: big objects. Myśl o nich jak o przechowywaniu danych w garażu. Można w nich trzymać ogromną liczbę rekordów, ale nie da się ich umieścić w układzie strony, nie ma standardowego interfejsu ani raportowania, a zapytania idą przez indeks big objectu, z dokładnym dopasowaniem albo zakresem (Big Objects Best Practices (opens in a new tab)). Bezpieczeństwo to tylko uprawnienia do obiektu i pól, bez udostępniania rekordów, a automatyzacja na nich nie działa. Salesforce Connect użyłem dziesiątki razy, a big objects tylko raz czy dwa. Działają, ale są niewygodne i napisałem swoją porcję obejść, żeby dostać się do danych. Moja rada: zrób prototyp, zanim je zaproponujesz, i zaplanuj, jak ludzie będą znajdować dane, zanim je wybierzesz.
Druga szopa jest poza core: hurtownia albo baza danych gdzieś indziej (Projektowanie pod skalę). Często to lepsza szopa i wcale nie musi być poza zasięgiem wzroku. Zarchiwizowane dane poza core nadal mogą pojawiać się w raportach dzięki narzędziom takim jak Tableau i nadal mogą być dostępne z Salesforce, przez Salesforce Connect albo inny sposób wirtualizacji, kiedy ktoś musi zajrzeć wstecz.
Opowiem o projekcie, w którym od początku zrobiliśmy to dobrze. Klient z branży handlowej miał ponad 1200 lokalizacji. Powiedzieli mi: „W sklepie robimy tylko sto wizyt dziennie. Nic wielkiego”. Potem policzyłem: sto dziennie, sześć dni w tygodniu (około 305 dni w roku), w 1200 lokalizacjach, to ponad 36 milionów wizyt rocznie. Potem wspomnieli, że każda wizyta tworzyła dwa umówione spotkania, jedno przy ladzie, drugie na zapleczu: ponad 73 miliony rekordów rocznie. Potem chcieli pięciu lat historii: ponad 360 milionów rekordów, jeszcze przed jakimkolwiek wzrostem. Jeszcze nie wystartowaliśmy, a ja już widziałem pociąg jadący prosto na stację dużych wolumenów danych. Archiwum zbudowano więc, zanim zebraliśmy pierwszą wizytę: starsze wizyty przechodziły do big objects, a ekran wyszukiwania pokazywał bieżące wizyty, a tuż pod nimi zarchiwizowane. Po latach wciąż działa bez problemu.
W praktyce: Steve Trucking
Dział zatytułowany „W praktyce: Steve Trucking ”Steve Trucking to nasz stały scenariusz: rodzinna firma dostaw ostatniej mili, która odbiera AGD i elektronikę w centrach dystrybucyjnych wielkich sieci handlowych, a potem dostarcza i instaluje je w domach klientów. Cztery rodzaje jej danych, trzy odpowiedzi:
| Dane | Gdzie mieszkają | Dlaczego |
|---|---|---|
| Dzisiejsze dostawy, ekipy i wizyty | W core | Dyspozytorzy i ekipy pracują w nich cały dzień |
| Szczegóły zamówienia sprzedawcy | Wskazywane (albo cienka kopia w core) | System sprzedawcy jest źródłem prawdy |
| Historia dostaw sprzed trzech lat | Zarchiwizowane | Trzymane na potrzeby reklamacji i trendów; prawie nikt ich nie otwiera |
| Zdjęcia z dostaw | Poza core, z linkiem | Tysiące dziennie; przechowywane poza Salesforce z linkiem na dostawie |
Oto to samo jako model danych. Dostawa jest w core, gdzie ludzie pracują w niej cały dzień. Po trzech latach przechodzi do Delivery History (historii dostaw), big objectu: nadal w core, ale już w szopie. Zamówienie partnera pojawia się jako obiekt zewnętrzny, __x: Salesforce wiąże z nim dostawę, ale dane zostają w systemie sprzedawcy. A zdjęcia mieszkają całkowicie poza core, z linkiem z dostawy. Jeden model, trzy domy.
Każdy prawdziwy org ma wszystkie trzy. W kłopoty wpadają te, które wszystko umieściły w core, bo utworzenie obiektu było domyślnym przyciskiem.
Co tu decyduje architekt
Dział zatytułowany „Co tu decyduje architekt ”- Dom dla każdego rodzaju danych, zanim zaprojektuje się jakikolwiek obiekt: w core, wskazywane czy zarchiwizowane.
- Źródło prawdy. Jeśli właścicielem danych jest inny system, Salesforce nie powinien po cichu stawać się drugim źródłem nadrzędnym.
- Ścieżka dostępu do wszystkiego, co jest poza core. Dane wskazywane potrzebują dostępnego źródła i akceptowalnego opóźnienia; dane zarchiwizowane potrzebują sposobu, w jaki ludzie mogą je znaleźć.
- Wzrost przestrzeni. Policz to teraz (rekordy dziennie razy wzrost razy retencja), a nie wtedy, gdy przyjdzie ostrzeżenie o przestrzeni.
Poza egzaminem: AI podnosi stawkę „w core”. Funkcje AI i agenci najlepiej działają na danych, które platforma rozumie: danych w obiektach standardowych i niestandardowych, dobrze nazwanych i dobrze opisanych. To ciągnie w stronę umieszczania w core większej ilości danych. Opieraj się temu przy niewłaściwych danych. Agent ugruntowany na nieaktualnej kopii danych z ERP daje pewne siebie, błędne odpowiedzi. Często lepszym ruchem jest wskazywanie żywego źródła albo trzymanie w core małego, dobrze opisanego wycinka. To, gdzie AI czyta dane, jest teraz częścią decyzji o tym, gdzie dane mieszkają.
Do zgłębienia
Dział zatytułowany „Do zgłębienia ”- Big Objects Best Practices (opens in a new tab), Salesforce Developers (po angielsku, sprawdzono 2026-09-25)
- Files Connect FAQ (opens in a new tab), Pomoc Salesforce (po angielsku, sprawdzono 2026-09-25)
- W tym kursie: Wirtualizacja, federacja i zero copy i Projektowanie pod skalę