
Umieść dane tam, gdzie ich miejsce
Dostępne także w 28 językach
English · Español · 日本語 · Português (Brasil) · Français · Deutsch · Italiano · 한국어 · 简体中文 · Português (Portugal) · 繁體中文 · Bahasa Indonesia · Türkçe · Tiếng Việt · ไทย · Nederlands · العربية · עברית · Українська · हिन्दी · Русский · Svenska · Dansk · Norsk bokmål · Suomi · Español (México) · Français (Canada) · Deutsch (Schweiz)
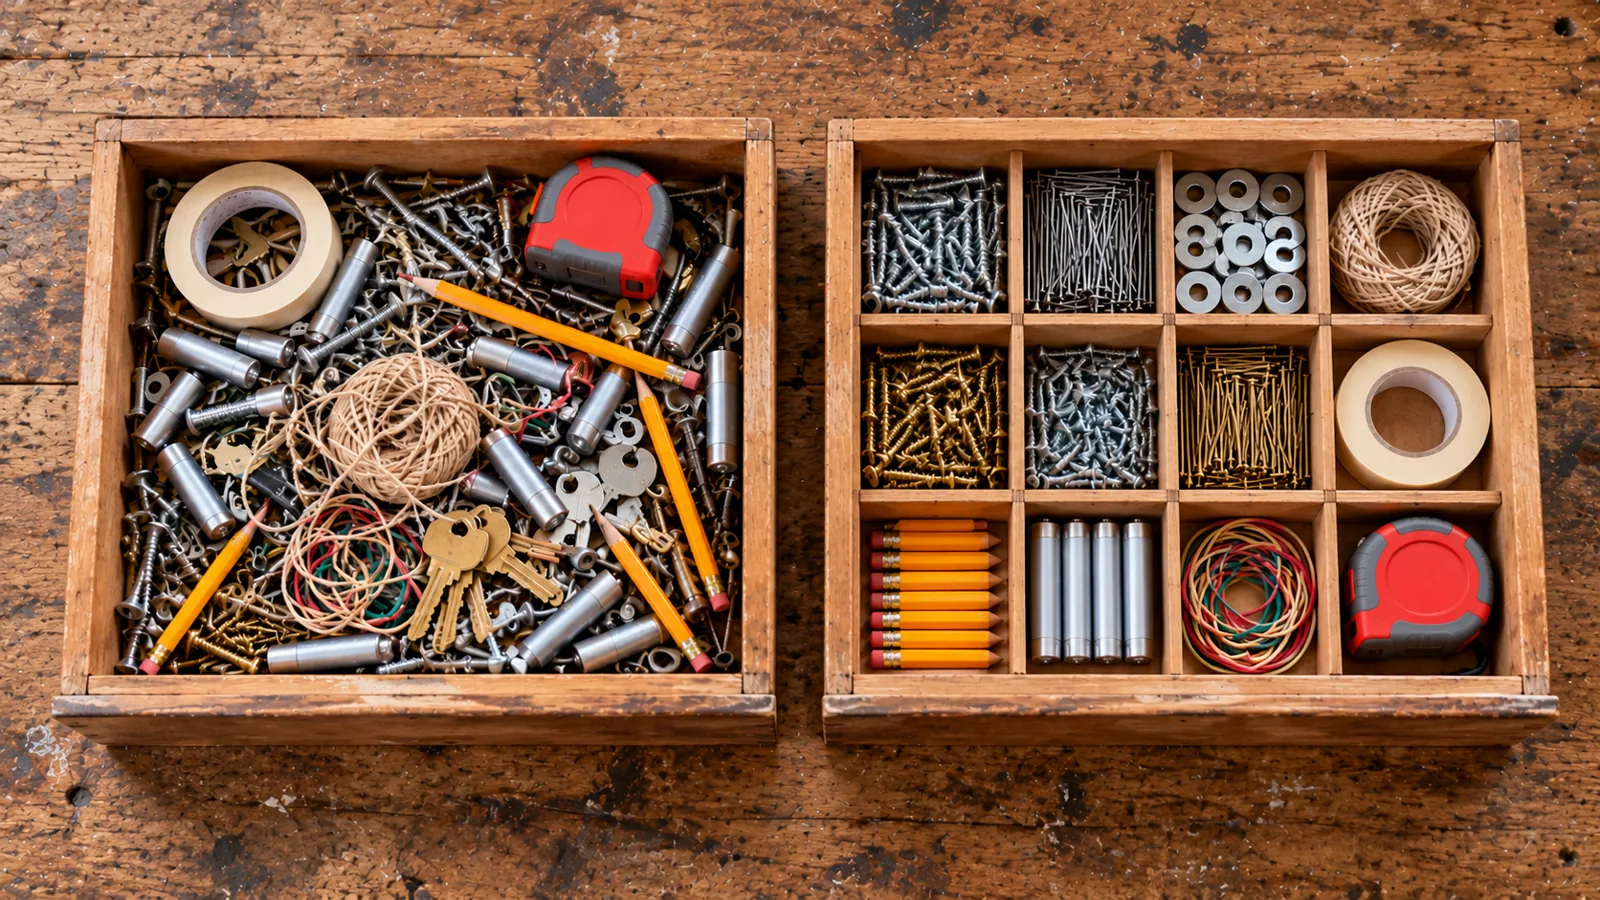
Moduł 4 z 6 w rozdziale Modelowanie danych, które coś znaczą, rozdziale 2 kursu Data Architect. Każdy moduł jest samodzielny. Wstecz: Zbuduj model logiczny · Dalej: Projektuj do trzeciej postaci normalnej, potem odpuść
Pytanie, na które odpowiada ten moduł: jak normalizacja pomaga mi ustalić, gdzie naprawdę należą dane?
Mamy model logiczny: encje, relacje, atrybuty i klucze. Teraz chcę zadać jedno z najważniejszych pytań w modelowaniu danych: czy te dane naprawdę tu należą?
Brzmi prosto. Nie jest. Widziałem mnóstwo systemów, w których każde pole miało sens, kiedy ktoś je tworzył. Problemem nie było to, że pola były absurdalne; problemem było to, że fakty przechowywano w złym miejscu. Dostawa trzyma informacje, które tak naprawdę opisują centrum dystrybucyjne. Ten sam adres pojawia się na setkach rekordów. Jedno pole trzyma trzy wartości rozdzielone przecinkami. Zmiana jednego faktu biznesowego oznacza aktualizację 10 000 rekordów. To jest problem, który pomaga rozwiązać normalizacja, a zanim utoniemy w terminologii baz danych, oto cała idea: umieść fakt tam, gdzie jego miejsce. Wszystko inne w tym module pomaga nam robić to bardziej systematycznie.
Czym jest normalizacja?
Dział zatytułowany „Czym jest normalizacja? ”Normalizacja to takie uporządkowanie danych, żeby każdy fakt był przechowywany raz, w miejscu, do którego należy. Kiedy jedna tabela wykonuje zbyt wiele zadań, dzielimy ją na tabele, z których każda opisuje jedną rzecz, i łączymy je kluczami.
Po co się trudzić? Bo fakt zapisany raz to fakt zmieniany raz. Normalizacja zapobiega redundancji, czyli temu samemu faktowi skopiowanemu w wielu rekordach, a razem z nią niespójnościom, które wkradają się, gdy jedna kopia zostanie zaktualizowana, a pozostałe nie. Dlatego pasuje do systemów transakcyjnych takich jak Salesforce, gdzie rekordy są tworzone i aktualizowane przez cały dzień.
Normalizujemy krokami nazywanymi postaciami normalnymi, a każda z nich zadaje jedno pytanie:
- Pierwsza postać normalna (1NF): jedna wartość w polu i coś, co jednoznacznie identyfikuje każdy wiersz.
- Druga postać normalna (2NF): każdy fakt opisuje całość tego, co identyfikuje wiersz, a nie tylko jej część.
- Trzecia postać normalna (3NF): każdy fakt opisuje tę rzecz, a nie coś innego, z czym jest powiązana.
Są też postacie wyższe niż trzecia. Powiem o nich słowo później, i o tym, dlaczego zwykle zatrzymujemy się na trzeciej. Najpierw zobaczmy te trzy kroki w działaniu.
Dlaczego normalizujemy?
Dział zatytułowany „Dlaczego normalizujemy? ”Kiedy uczę tego na żywo, nie zaczynam od dostaw. Zaczynam od psów. Wszyscy rozumieją psy, więc nikogo nie rozprasza biznes i możemy patrzeć, jak dane próbują znaleźć swój dom. Potem przenosimy te same ruchy do Steve Trucking.
Siad, zostań, modeluj
Dział zatytułowany „Siad, zostań, modeluj ”Start: surowy arkusz. Wrzucam na ekran kilka psów, a potem sala dodaje swoje. Po kilku minutach mamy jedną dużą listę: pies, rok urodzenia, kto jest właścicielem, gdzie mieszka właściciel, rasa, kto go wyhodował i jakie zna sztuczki.
| Pies | Rok ur. | Właściciel | Kod pocztowy | Miasto | Rasa | Hodowca | Sztuczki |
|---|---|---|---|---|---|---|---|
| Bella | 2017 | Marcus | 80202 | Denver | Labrador | Maple Ridge | Siad, Zostań, Daj łapę |
| Milo | 2019 | Marcus | 80202 | Denver | Pudel | Golden Meadow | Siad, Turlaj się |
| Max | 2022 | Ana | 64105 | Kansas City | Mieszaniec | Siad, Udawaj martwego | |
| Luna | 2020 | Kenji | 98101 | Seattle | Husky | Cascade | Siad, Zostań, Kółko |
| Rocky | 2024 | Priya | 30301 | Atlanta | Beagle | Maple Ridge | Siad |
| Coco | 2014 | Ana | 64105 | Kansas City | Chihuahua | Little Paws | Daj łapę, Kółko |
Działa. Każdy arkusz działa pierwszego dnia. Ale spójrz, co już jest nie tak. Jak znaleźć każdego psa, który zna Daj łapę? Kod pocztowy Any jest w dwóch wierszach, tak samo jak Marcusa: co się stanie, jeśli ktoś zaktualizuje jeden, a drugiego nie? Maple Ridge pojawia się dwa razy, tak samo Kansas City. A Max pochodzi ze schroniska, więc nie ma żadnego hodowcy.
Krok 1: pierwsza postać normalna. Dwie zasady. Każde pole trzyma jedną wartość, więc lista sztuczek po przecinku musi zniknąć. I każdy wiersz potrzebuje czegoś, co go jednoznacznie identyfikuje. Nie imienia psa; psów o imieniu Max jest mnóstwo. Identyfikator: automatycznie generowany identyfikator (ID) albo GUID. Sztuczki przechodzą do własnych wierszy, jeden wiersz na każdego psa i każdą sztuczkę. A skoro sztuczka ma własny wiersz, jest miejsce na to, czego nigdy nie dało się powiedzieć na liście po przecinku: jak trudna jest sztuczka, jak dobrze ten pies ją wykonuje i kiedy się jej nauczył.
Pies (identyfikowany przez ID psa)
| ID psa | Imię | Rok ur. | Właściciel | Kod pocztowy | Miasto | Rasa | Hodowca |
|---|---|---|---|---|---|---|---|
| D-001 | Bella | 2017 | Marcus | 80202 | Denver | Labrador | Maple Ridge |
| D-002 | Milo | 2019 | Marcus | 80202 | Denver | Pudel | Golden Meadow |
| D-003 | Max | 2022 | Ana | 64105 | Kansas City | Mieszaniec | |
| D-004 | Luna | 2020 | Kenji | 98101 | Seattle | Husky | Cascade |
| D-005 | Rocky | 2024 | Priya | 30301 | Atlanta | Beagle | Maple Ridge |
| D-006 | Coco | 2014 | Ana | 64105 | Kansas City | Chihuahua | Little Paws |
Sztuczka psa (identyfikowana przez ID psa + Sztuczkę)
| ID psa | Sztuczka | Trudność | Poziom umiejętności | Data nauki |
|---|---|---|---|---|
| D-001 | Siad | Łatwa | Ekspert | 2017-11 |
| D-001 | Zostań | Łatwa | Ekspert | 2018-01 |
| D-001 | Daj łapę | Średnia | Dobry | 2018-06 |
| D-002 | Siad | Łatwa | Ekspert | 2020-02 |
| D-002 | Turlaj się | Trudna | Uczy się | 2023-05 |
| D-003 | Siad | Łatwa | Dobry | 2022-06 |
| D-003 | Udawaj martwego | Trudna | Uczy się | 2024-03 |
| D-004 | Siad | Łatwa | Ekspert | 2020-11 |
| D-004 | Zostań | Łatwa | Dobry | 2021-01 |
| D-004 | Kółko | Średnia | Ekspert | 2021-06 |
| D-005 | Siad | Łatwa | Uczy się | 2025-02 |
| D-006 | Daj łapę | Średnia | Ekspert | 2015-06 |
| D-006 | Kółko | Średnia | Uczy się | 2025-04 |
Teraz „każdy pies, który zna Daj łapę” to proste pytanie. Ale zwróć uwagę, przez co identyfikowana jest Sztuczka psa: nie przez jedną rzecz, tylko przez dwie rzeczy razem, psa i sztuczkę. Zapamiętaj to.
Krok 2: druga postać normalna. Druga postać normalna ma znaczenie tylko wtedy, gdy wiersz jest identyfikowany przez kombinację, a Sztuczka psa jest. Pytam więc o każdą kolumnę: czy opisuje całą kombinację, czy tylko jej część? Poziom umiejętności opisuje tego psa wykonującego tę sztuczkę: Bella jest ekspertem w Siad, Rocky dopiero się go uczy. Data nauki tak samo. Ale Trudność? Siad jest łatwy bez względu na to, który pies go wykonuje. Opisuje sztuczkę, czyli tylko część klucza, i dlatego „Łatwa” powtarza się w każdym wierszu z Siad. Sztuczka dostaje więc własną tabelę, a to, co zostaje, to para.
Sztuczka
| ID sztuczki | Sztuczka | Trudność |
|---|---|---|
| T-01 | Siad | Łatwa |
| T-02 | Zostań | Łatwa |
| T-03 | Daj łapę | Średnia |
| T-04 | Turlaj się | Trudna |
| T-05 | Udawaj martwego | Trudna |
| T-06 | Kółko | Średnia |
Sztuczka psa (ID psa + ID sztuczki)
| ID psa | ID sztuczki | Poziom umiejętności | Data nauki |
|---|---|---|---|
| D-001 | T-01 | Ekspert | 2017-11 |
| D-001 | T-02 | Ekspert | 2018-01 |
| D-001 | T-03 | Dobry | 2018-06 |
| D-002 | T-01 | Ekspert | 2020-02 |
| D-002 | T-04 | Uczy się | 2023-05 |
| D-003 | T-01 | Dobry | 2022-06 |
| D-003 | T-05 | Uczy się | 2024-03 |
| D-004 | T-01 | Ekspert | 2020-11 |
| D-004 | T-02 | Dobry | 2021-01 |
| D-004 | T-06 | Ekspert | 2021-06 |
| D-005 | T-01 | Uczy się | 2025-02 |
| D-006 | T-03 | Ekspert | 2015-06 |
| D-006 | T-06 | Uczy się | 2025-04 |
Ta tabela Sztuczka psa to ta sama, którą znaleźliśmy w module 2, i ma w modelowaniu danych swoją nazwę: tabela łącząca (junction), albo, jak ja to nazywam, logiczny obiekt łączący. Pies zna wiele sztuczek; sztuczkę zna wiele psów. Obiekt łączący siedzi między nimi i nie jest pustą hydrauliką: trzyma fakty, które należą do samej relacji, czyli poziom umiejętności i datę. Spotkamy go znowu w module 6, a w rozdziale 3 zobaczymy, że Salesforce używa określenia „junction object” węziej: obiekt łączący Salesforce (Salesforce Junction Object) to obiekt niestandardowy z dwiema relacjami master-detail (rozdział 3, moduł 7).
Krok 3: trzecia postać normalna. Wróćmy teraz do tabeli Pies. Wszystko w niej jest identyfikowane przez ID psa, więc druga postać normalna nie ma tu nic do powiedzenia. Trzecia postać normalna zadaje inne pytanie: czy ten fakt opisuje psa, czy coś innego, z czym pies jest powiązany? Rasa to osobna rzecz: labrador to labrador, bez względu na to, o którego psa chodzi, a fakty o nim, takie jak wielkość, należą do rasy, nie do Belli. Kod pocztowy i miasto opisują właściciela, nie psa: tam mieszka Ana, niezależnie od tego, na którego z jej psów patrzymy. Dane hodowcy opisują hodowcę. Każdy z tych faktów to fakt o innym fakcie, więc każdy przechodzi do własnej tabeli, a pies wskazuje na nią kluczem obcym:
- Pies: ID psa, Imię, Rok urodzenia, ID właściciela, ID rasy, ID hodowcy
- Właściciel: ID właściciela, Imię, Kod pocztowy, Miasto
- Rasa: ID rasy, Rasa, Wielkość
- Hodowca: ID hodowcy, Nazwa, Miasto
- Sztuczka i Sztuczka psa, z kroku 2
Ana jest teraz zapisana raz, a oba jej psy na nią wskazują. Maple Ridge jest zapisane raz, a tabela Rasa daje dom faktom o każdej rasie, takim jak wielkość, dla których arkusz nie miał miejsca. Klucz obcy może być pusty: Max nie ma ID hodowcy i to uczciwa odpowiedź, a nie luka. Potem rzucam sali podchwytliwe pytanie: kiedy właściciel dostał psa, gdzie trafia ta data? Do psa. W tym modelu pies ma w danym momencie jednego właściciela, więc ta data opisuje relację psa z jego właścicielem.
Można pójść o krok dalej i oddzielić miasto od kodu pocztowego; podręczniki tak robią. W praktyce adres zostaje w całości, a Kansas City i tak leży w dwóch stanach, co ładnie przypomina, że prawdziwy świat nie czyta naszych podręczników.
Tak wygląda cała droga: arkusz, potem trzy pytania, a każdy fakt ląduje w jednym miejscu. Zrób krok w tył i spójrz, co zbudowaliśmy. Jedna nieuporządkowana lista stała się sześcioma tabelami, z których każda opisuje jedną rzecz, połączonymi kluczami:
Nikt nie potrzebował ani jednego słowa z Salesforce, żeby to zrozumieć. To po prostu psy, ludzie wokół nich i to, co psy umieją.
Zastosujmy to w Steve Trucking
Dział zatytułowany „Zastosujmy to w Steve Trucking ”Psy sprawiają, że ruchy łatwo zobaczyć. Prawdziwy biznes sprawia, że mają znaczenie, bo te same błędy w skali kosztują prawdziwe pieniądze. Zanieśmy więc te same trzy pytania do Steve Trucking. Wyobraź sobie, że firma trzyma swoje dostawy tak:
| Dostawa | Partner detaliczny | Centrum dystrybucyjne | Miasto CD | Ekipa | Ciężarówka |
|---|---|---|---|---|---|
| 1001 | Keystone | CD Keystone Phoenix | Phoenix | Ekipa 12 | 117 |
| 1002 | Keystone | CD Keystone Phoenix | Phoenix | Ekipa 8 | 122 |
| 1003 | Keystone | CD Keystone Phoenix | Phoenix | Ekipa 12 | 117 |
Na pierwszy rzut oka nic tu nie jest skomplikowane. Ale spójrz na centrum dystrybucyjne. Powtarzamy „CD Keystone Phoenix, Phoenix” przy każdej dostawie, która z niego wyjeżdża: Steve Trucking realizuje około 3300 dostaw dziennie z dziewięciu CD, więc kilkaset dziennie z każdego. Co się stanie, jeśli to CD się przeniesie? Ile rekordów zmieniamy i co się stanie, jeśli jeden pominiemy? Teraz dane mówią, że CD jest jednocześnie w dwóch miastach. To anomalia aktualizacji. A jeśli chcemy założyć nowe CD przed jego pierwszą dostawą? A jeśli usuniemy ostatnią dostawę z CD: czy właśnie usunęliśmy jedyne miejsce, w którym cokolwiek o nim zapisaliśmy?
To różne objawy tego samego problemu: pomieszaliśmy fakty o różnych rzeczach. Fakty o centrum dystrybucyjnym należą do centrum dystrybucyjnego. Fakty o dostawie należą do dostawy. Fakty o ekipie należą do ekipy. To normalizacja w praktyce.
Pierwsza postać normalna: nie ukrywaj powtarzającej się struktury
Dział zatytułowany „Pierwsza postać normalna: nie ukrywaj powtarzającej się struktury ”Zacznijmy od pierwszej postaci normalnej, czyli 1NF, przy której ludzie czasem utrudniają normalizację bardziej, niż trzeba.
Załóżmy, że dostawa ma pole o nazwie Pozycje: „Lodówka, zestaw do kostkarki, wywóz starego sprzętu”. Wcisnęliśmy trzy informacje do jednego pola. Wydaje się to wygodne, dopóki ktoś nie zapyta: „Ile wywozów zrobiliśmy w zeszłym miesiącu?”. Albo wyobraź sobie pola Pozycja 1, Pozycja 2 i Pozycja 3. To działa aż do dostawy z czterema pozycjami. Problem nie polega na tym, że wybraliśmy złą liczbę pól Pozycja. Problem polega na tym, że nie rozpoznaliśmy powtarzającej się struktury. Dostawa może mieć kilka pozycji. To dane, które powinniśmy zamodelować: pozycja dostawy, którą znaleźliśmy w module 2.
Praktyczna lekcja 1NF: nie ukrywaj powtarzającej się struktury w polach. Jeśli biznes mówi ci, że coś może wydarzyć się wiele razy, słuchaj. Może tam być inna encja, która próbuje się wydostać.
W prawdziwych orgach zobaczysz to bez przerwy. Ktoś potrzebuje opisu w kilku językach, więc tworzy pole Description_English, potem Description_French, potem Description_German. Albo zatwierdzenie wymaga kilku osób, więc dostajemy Approver 1, Approver 2, Approver 3. Kiedy znajduję to w przeglądzie, jest po łapach i poprawiamy model danych. Jedno czy dwa pola, może, jeśli biznes naprawdę zawsze ma tylko jedno czy dwa. Wszystko powyżej powinno być obiektem podrzędnym: Tłumaczenie z językiem, Krok zatwierdzenia z zatwierdzającym. Kolejny język albo czwarty zatwierdzający staje się nowym rekordem, a nie nowym polem i wdrożeniem.
Druga postać normalna: opisuj całość
Dział zatytułowany „Druga postać normalna: opisuj całość ”Druga postać normalna, czyli 2NF, ma znaczenie, gdy rekord jest identyfikowany przez kombinację rzeczy. Weźmy pozycję dostawy. Ma własny identyfikator rekordu, ale każda jest unikalna przez dostawę + produkt. Załóżmy, że przechowujemy dostawę, produkt, ilość i opis produktu.
Ilość ma tu sens: opisuje ten produkt w tej dostawie. Ale opis produktu nie opisuje kombinacji; opisuje produkt. Umieść go w każdej pozycji dostawy, a będziemy go powtarzać za każdym razem, gdy ten model lodówki wyjedzie kolejną ciężarówką. To wskazówka, że ten fakt należy gdzie indziej.
Pytanie 2NF brzmi więc: czy ten atrybut opisuje całą rzecz, którą identyfikuję, czy tylko jej część? Jeśli opisuje tylko produkt, idzie do produktu. Jeśli opisuje miejsce produktu w tej konkretnej dostawie (ilość, czy jest instalowany), należy do pozycji dostawy. Wielu administratorów nigdy świadomie nie powie: „Teraz stosuję drugą postać normalną”. I dobrze. Dużo bardziej zależy mi na tym, żeby weszło ci w nawyk pytanie: co ten fakt naprawdę opisuje?
Trzecia postać normalna: nie przechowuj faktów o innych faktach
Dział zatytułowany „Trzecia postać normalna: nie przechowuj faktów o innych faktach ”Teraz ta, na której najbardziej mi zależy w codziennym modelowaniu: trzecia postać normalna, czyli 3NF.
Każde centrum dystrybucyjne ma kierownika po stronie partnera detalicznego, kogoś, kto korzysta z portalu partnera. Załóżmy, że wpisujemy nazwisko kierownika CD bezpośrednio do każdej dostawy. Co się stanie, gdy CD dostanie nowego kierownika? Aktualizujemy każdą dostawę z tego CD. To znowu ten zapach: powtarzamy fakt, który należy gdzie indziej. Dostawa wyjeżdża z CD; CD ma kierownika. To dwie relacje, a nazwisko kierownika należy do CD.
Klasyczna podręcznikowa wersja to adres: kod pocztowy, miasto i stan zapisane razem w każdym rekordzie, choć miasto i stan zwykle wynikają z kodu pocztowego. Ten sam kształt, to samo pytanie.
Praktyczne pytanie 3NF brzmi: czy ten fakt opisuje tę rzecz, czy coś innego, z czym ta rzecz jest powiązana? Zadawaj je bez przerwy.
Teraz zrób krok w tył, tak jak przy psach. Tabela dostaw, od której zaczęliśmy, stała się pięcioma rzeczami, z których każda trzyma własne fakty: pozycja dostawy wyszła przy pierwszej postaci normalnej, produkt przy drugiej, a miasto i kierownik centrum dystrybucyjnego przeszły do centrum dystrybucyjnego przy trzeciej.
Te same trzy pytania, ten sam wynik: każdy fakt w jednym miejscu.
Prosty sposób myślenia o 1NF, 2NF i 3NF
Dział zatytułowany „Prosty sposób myślenia o 1NF, 2NF i 3NF ”Normalizacji można poświęcić cały kurs baz danych. My tego nie zrobimy. Na potrzeby tego kursu wystarczy robocze rozumienie, jakiego potrzebuje architekt:
- 1NF: czy ukrywam wiele wartości albo powtarzające się struktury w polu lub rekordzie?
- 2NF: czy ten fakt opisuje całą rzecz, którą identyfikuję?
- 3NF: czy ten fakt naprawdę opisuje tę encję, czy coś z nią powiązanego?
To nie są definicje do podręcznika baz danych. To pytania, których naprawdę mogę używać podczas projektowania.
Tak, normalizacja idzie dalej: postać normalna Boyce’a-Codda (BCNF) zaostrza zasady 3NF dla modeli z bardziej skomplikowanymi kluczami, są też czwarta, piąta, a nawet szósta postać normalna. Dotyczą rzadszych rodzajów powtórzeń, takich, które biorą się raczej z nietypowych struktur kluczy niż z codziennych rekordów biznesowych. Mnóstwo teorii, a z mojego doświadczenia niewartej bólu głowy przy systemach, jakie budujemy na Salesforce. W systemach biznesowych presja zwykle działa w drugą stronę: dużo częściej odchodzimy od trzeciej postaci normalnej, dla użytkowników, raportowania i wydajności, niż idziemy dalej. To temat następnego modułu. Wiedz, że dalsze postacie istnieją, ale do większości tego, co robimy, 1NF do 3NF daje nam narzędzia myślenia, których potrzebujemy.
Projektuj pod trzecią postać normalną
Dział zatytułowany „Projektuj pod trzecią postać normalną ”Oto moje stanowisko. Kiedy próbuję zrozumieć biznes i zaprojektować jego model logiczny, chcę zacząć czysto: fakty o dostawie przy dostawie, fakty o centrum dystrybucyjnym przy CD, fakty o ciężarówce przy ciężarówce, powtarzające się pojęcia zamodelowane jako pojęcia. Nie chcę faktu biznesowego skopiowanego po całym modelu tylko dlatego, że może ułatwić jakiś ekran albo raport. Jeszcze nie.
Ale normalizacja to nie religia. Celem nie jest najbardziej akademicko czysty model. Widziałem architektów tak skupionych na czystości, że model stawał się udręką dla każdego, kto musiał go używać. Nie próbujemy wygrać konkursu normalizacji; budujemy system, a ten system ma użytkowników, raporty, integracje, wymagania wydajnościowe, skalę i coraz częściej AI, które czyta dane. One mogą chcieć danych w innych kształtach.
Mój punkt wyjścia to więc projektuj do trzeciej postaci normalnej, gdzie to wykonalne, potem odpuszczaj, gdy to konieczne: najpierw zrozum, gdzie należy każdy fakt. Potem, jeśli mamy od tego odejść, chcę wiedzieć dlaczego. Jeśli odpowiedź brzmi „bo nie wiedziałem, gdzie indziej dać to pole”, to za mało. Jeśli odpowiedź brzmi „celowo skopiowaliśmy tę wartość, bo dzięki temu karta wyników partnera jest prosta, i mamy niezawodny sposób utrzymania jej w synchronizacji”, to wtedy prowadzimy rozmowę o architekturze.
Co tu decyduje architekt
Dział zatytułowany „Co tu decyduje architekt ”Normalizując model logiczny, szukam:
- Powtarzających się wartości albo struktur, które powinny być zamodelowane osobno.
- Atrybutów, które opisują inną encję niż ta, w której są przechowywane.
- Faktów niepotrzebnie zduplikowanych w wielu rekordach i zależności, przez które stają się niespójne.
- Pojęć biznesowych ukrytych w polach.
- Czystego modelu, który przedstawia prawdę, zanim pojawią się jakiekolwiek kompromisy implementacyjne.
Nie dlatego, że każdy system fizyczny musi pozostać idealnie znormalizowany. Wręcz przeciwnie. W następnym module celowo odejdziemy od czystego modelu, dla użytkowników, raportowania, skali, analityki i AI, i zrobimy to, wiedząc dokładnie, co za co wymieniamy.