
데이터베이스 그 이상
28개 언어로도 제공
English · Español · 日本語 · Português (Brasil) · Français · Deutsch · Italiano · 简体中文 · Português (Portugal) · 繁體中文 · Bahasa Indonesia · Türkçe · Polski · Tiếng Việt · ไทย · Nederlands · العربية · עברית · Українська · हिन्दी · Русский · Svenska · Dansk · Norsk bokmål · Suomi · Español (México) · Français (Canada) · Deutsch (Schweiz)
Data Architect 과정 3장인 Salesforce 데이터 아키텍처의 모듈 1/10. 각 모듈은 독립적으로 읽을 수 있습니다. 다음: 모선을 보라: 표준 데이터 모델
이 모듈이 답하는 질문: Salesforce는 전통적인 데이터베이스와 무엇이 다를까요?
Salesforce 관리자로 한동안 일했다면 개체를 만드는 법은 이미 압니다. 설정, 개체 관리자, 새 사용자 정의 개체. 이름을 붙이고, 필드 몇 개를 추가하고, 페이지 레이아웃을 만들면, 10분 뒤 사용자들이 그것으로 일할 수 있습니다.
그런데 저장을 클릭했을 때 실제로 무슨 일이 일어났을까요?
데이터베이스 배경이 있다면 아마 Salesforce가 새 테이블을 만들었다고 상상할 겁니다. 그렇지 않습니다. 그리고 왜 그런지 이해하는 것이, 관리자나 개발자처럼 생각하던 데서 아키텍트처럼 생각하는 쪽으로 옮겨 가기 시작하는 지점 중 하나입니다.
물론 Salesforce는 데이터를 저장하고, 그 아래에는 데이터베이스가 있습니다. 하지만 Salesforce는 위에 멋진 화면을 얹은 데이터베이스가 아닙니다. 메타데이터 기반 애플리케이션 플랫폼이고, 그 차이가 이 과정의 거의 모든 결정을 형성합니다.
플랫폼에는 형태가 있다
섹션 제목: “플랫폼에는 형태가 있다 ”2장에서는 Salesforce를 전혀 신경 쓰지 않고 모델을 만들었습니다. 의도된 것이었습니다. 명사를 듣고, 개념 모델을 만들고, 속성과 키와 관계를 더하고, 그다음에야 Salesforce가 그것을 어떻게 구현해야 하는지 물었습니다. 이제는 그것을 구현할 대상을 이해해야 합니다.
저는 이를 위해 단순한 문장을 씁니다. 플랫폼에는 형태가 있다. Salesforce는 개체, 필드, 관계, 보안, 자동화, API, 트랜잭션, 보고, 검색을 주고, 이것들은 모두 연결되어 있습니다. 개체를 만들 때 저는 단지 행을 담을 곳을 만드는 게 아닙니다. 보안 모델에 참여하고, 자동화가 다룰 수 있고, API가 노출하고, 보고서가 쓸 수 있고, 다른 개체가 연결할 수 있고, 사용자와 연동과 점점 더 에이전트가 의존하게 될 무언가를 만드는 것입니다. 테이블보다 훨씬 많은 것입니다.
메타데이터는 설계도다
섹션 제목: “메타데이터는 설계도다 ”건물을 생각해 보십시오. 건물 자체가 있고, 그것을 기술하는 설계도가 있습니다. 벽이 어디에 있고, 문이 어디에 나고, 방들이 어떻게 이어지는지. Salesforce도 같은 방식으로 작동합니다. 개체 정의는 메타데이터입니다. 필드 정의도 메타데이터입니다. 관계도 메타데이터입니다. 설정에서 구성하는 것 대부분이 메타데이터이고, 플랫폼은 런타임에 그것을 읽어 우리 org에 구조와 동작을 부여합니다.
Salesforce는 플랫폼의 핵심을 멀티테넌트이면서 메타데이터 기반이라고 설명합니다. 우리가 개체나 필드를 정의하면 그 정의는 우리 org를 위한 새 물리 테이블이나 열이 아니라 메타데이터로 저장됩니다(Platform Multitenant Architecture (opens in a new tab)).
이걸 가르칠 때 저는 보닛을 엽니다. Salesforce는 개체를 추가할 때마다 새 데이터베이스를 만들어 주지 않습니다. 자기 테이블에 레코드를 추가합니다. 개체 테이블, 필드 테이블, 데이터 테이블, 그리고 인덱스와 관계를 위한 피벗 테이블이 있고, 모두 당신 org의 데이터를 다른 모든 org와 분리하는 org 식별자로 키가 매겨져 있습니다. 그러니 필드를 추가하는 것은 항목을 하나 추가하는 것일 뿐입니다. 그래서 점심시간에, 운영 환경에서, 즉석으로 필드를 만들 수 있는 겁니다.
사람들이 걸려 넘어지는 것도 이것으로 설명됩니다. SELECT Id, Name, Special__c FROM Account라고 쓰면 테이블 하나처럼 보입니다. 그 아래에서는 표준 개체와 그 사용자 정의 필드를 서로 다른 구조에서 읽고 있으니, 플랫폼은 당신이 쓴 적 없는 조인을 하고 있습니다. 인덱스는 존재하지만 전통적인 데이터베이스 인덱스처럼 작동하지는 않습니다. 시험을 위해 내부 구조를 알 필요는 없습니다. 하지만 개체 관리자에서 보이는 것이 물리 테이블을 일대일로 비춘 그림이 아니라는 것, 그리고 그 추상화가 플랫폼의 힘이자 플랫폼이 그렇게 동작하는 이유라는 것은 알아야 합니다.
모선을 보라
섹션 제목: “모선을 보라 ”제가 수업에서 하는 말 중 하나는 모선을 보라입니다. Salesforce에서 무언가를 하는 복잡한 방법을 발명하기 전에, Salesforce 자신은 그것을 어떻게 하는지 보십시오.
계정을 보십시오. 당신이 만든 게 아니라 Salesforce가 만들었습니다. 하지만 필드를 추가하고, 그것을 중심으로 자동화하고, 레이아웃을 바꾸고, API로 노출하고, 다른 개체를 연결할 수 있습니다. 사용자 정의 개체도 같은 기계 위에서 돌아갑니다. 그래서 그 위에 무언가를 만들 때 표준 개체와 사용자 정의 개체가 그토록 비슷하게 느껴집니다. Apex에서는 기반 클래스, sObject까지 공유합니다.
이것이 이 장이 쌓아 올리는 습관이고, 다음 모듈에서 제대로 들여다봅니다. Salesforce가 이미 당신을 위해 만들어 둔 표준 데이터 모델을.
우리는 Salesforce 옆에 짓고 있는 게 아닙니다. Salesforce를 확장하고 있습니다.
API는 개체와 함께 왔다
섹션 제목: “API는 개체와 함께 왔다 ”전통적인 데이터베이스에 테이블을 만들면 테이블이 생깁니다. 다른 애플리케이션이 그것으로 일해야 한다면 누군가 할 일이 더 있습니다. Salesforce에 개체를 만들면 플랫폼은 이미 애플리케이션 층과 연동 층을 통해 그것을 이해합니다. 플랫폼은 같은 메타데이터로 REST와 SOAP API를 제공하므로, 개체가 존재하자마자 그 API를 통해 레코드를 생성, 조회, 갱신, 삭제할 수 있습니다(Platform Multitenant Architecture (opens in a new tab)).
개체를 만들었다고 API를 설계한 게 아닙니다. 플랫폼이 개체, 그 필드, 필드의 유형, 관계, 보안을 압니다. 그것이 Salesforce 개발이 그토록 빠른 이유 중 하나입니다. 동시에 개체를 만드는 것이 보이는 것보다 큰 결정인 이유이기도 합니다. 구조 하나를 애플리케이션 플랫폼 전체에 꽂는 것이니까요. 그리고 반대 방향으로도 작용합니다. SQL Server나 Oracle 출신들이 가끔 데이터베이스에 데이터를 직접 넣는 방법을 묻습니다. 그럴 수 없습니다. 모든 것은 API를 통해 들어옵니다.
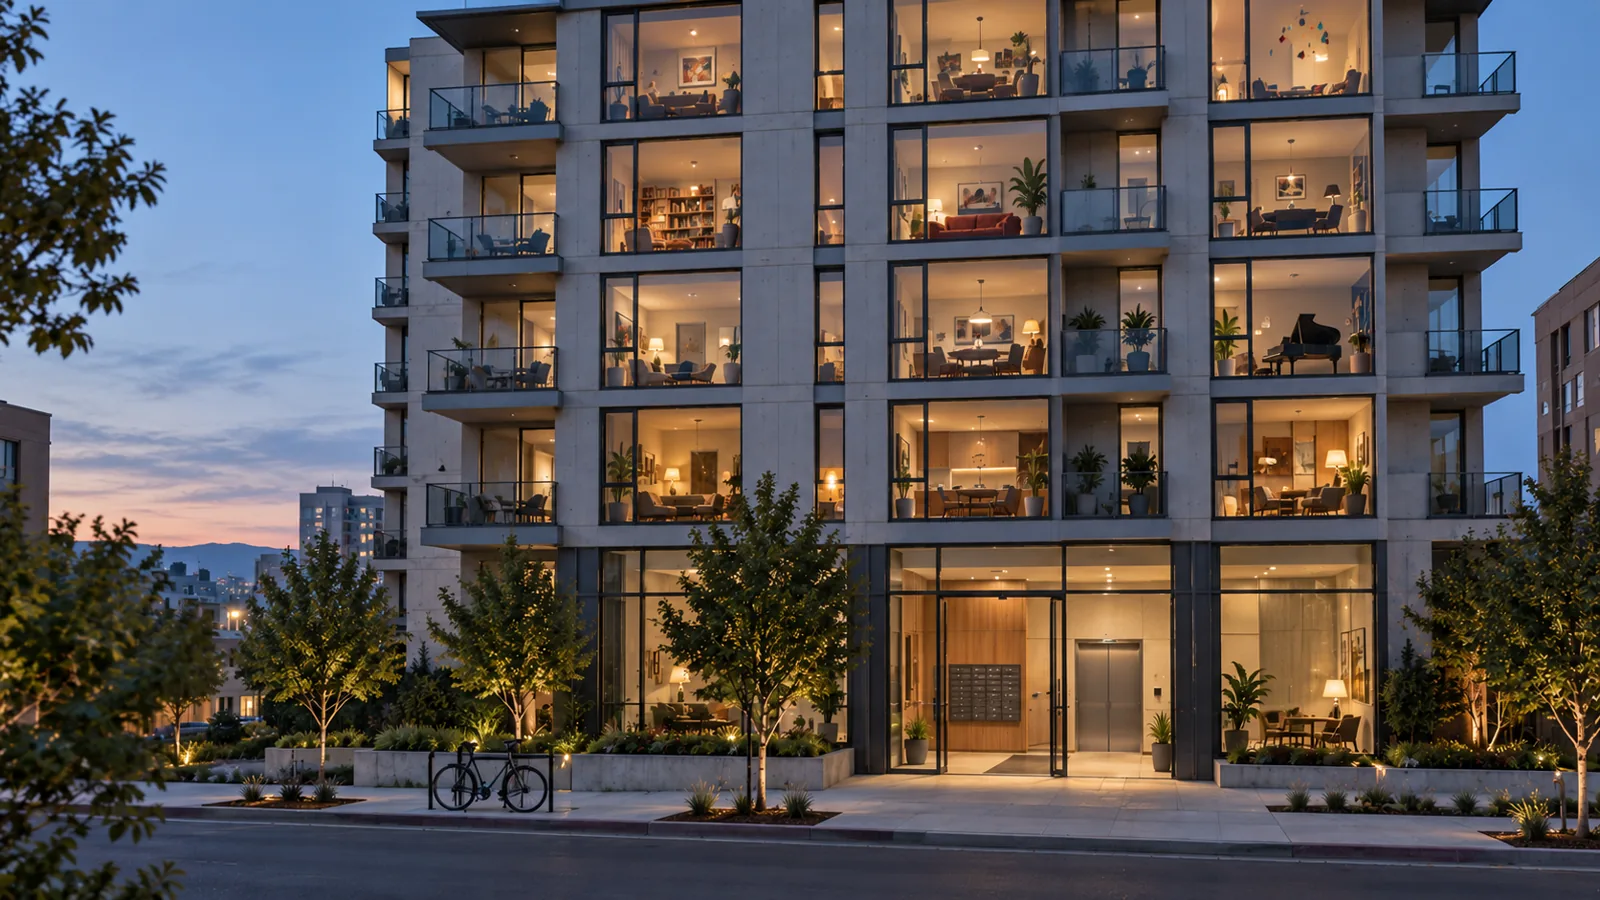
아파트 건물
섹션 제목: “아파트 건물 ”이제 늘 듣는 단어, 멀티테넌시입니다. 저는 아파트 건물로 생각합니다.
당신에게는 당신의 집이 있습니다. 가구는 당신 것이고, 당신의 열쇠로 제 문이 열려서는 안 됩니다. 하지만 우리는 건물을 공유합니다. 전기, 물, 엘리베이터, 로비. 당신의 org는 당신만의 환경처럼 느껴집니다. 당신의 데이터, 당신의 개체, 당신의 자동화. 그 아래에서 Salesforce는 각 org를 테넌트로 설명하며, 인프라와 서비스는 공유하면서 각 테넌트의 데이터, 메타데이터, 로직을 격리합니다(Platform Multitenant Architecture (opens in a new tab)). 그렇게 해서 고객마다 별도의 스택을 돌리지 않고도 모든 고객에게 그토록 커스터마이징 가능한 플랫폼을 줄 수 있습니다.
하지만 건물을 공유하면 결과가 따릅니다. 한 세입자가 거대한 에어컨을 사고 헤어드라이어와 오븐을 동시에 켜면 차단기가 내려가고, 층 전체가 캄캄해집니다.
엘리베이터를 독차지할 수 없다
섹션 제목: “엘리베이터를 독차지할 수 없다 ”건물에 조금만 더 머물러 봅시다. 한 주민이 “8시부터 정오까지 엘리베이터가 필요해요. 아무도 쓰지 마세요”라고 선언한다고 상상해 보십시오. 공유 건물에서는 통하지 않고, Salesforce에서도 통하지 않습니다. 한 테넌트가 공유 자원을 무제한으로 소비해 모두를 위한 플랫폼을 떨어뜨리게 둘 수는 없습니다.
그것이 거버너 제한(governor limits)의 출처입니다. Salesforce에서 개발해 봤다면 아마 외워야 할 숫자 목록으로 만났을 겁니다. 저는 여러분이 그렇게 생각하지 않기를 바랍니다. Salesforce는 한 테넌트의 워크로드가 공유 컴퓨팅을 독점하지 않도록 트랜잭션과 org 수준에서 제한을 적용합니다(Architecture Basics (opens in a new tab)). 그것이 아키텍처이고, 개별 제한은 그 구현일 뿐입니다. 과정 후반에는 특정 제한이 설계를 바꾸기 때문에 신경 쓰게 됩니다. 지금은 건물을 기억하십시오. 당신 집을 리모델링할 자유는 엄청나게 큽니다. 엘리베이터를 독차지할 수는 없습니다.
Salesforce ID는 추상화의 일부다
섹션 제목: “Salesforce ID는 추상화의 일부다 ”모든 Salesforce 레코드에는 플랫폼이 이해하는 정체성, 즉 레코드 ID가 있고, 그것은 UI, API, 보고서, 자동화 등 모든 기능에서 통합니다.
2장에서 좋은 키는 고유하고, 변하지 않고, 의미가 없고, 절대 개인정보가 아니어야 한다고 했습니다. Salesforce ID는 Salesforce 안에서 그 조건에 맞습니다. 하지만 비즈니스 키와 같은 것은 아닙니다. 회사에는 여전히 ERP 고객 번호, 사번, 파트너의 주문 번호처럼 시스템을 넘나들며 의미를 갖는 것이 있을 수 있습니다. “Salesforce는 이게 어느 레코드인지 안다”와 “기업은 이게 어떤 비즈니스 대상인지 안다”를 혼동하지 마십시오. 서로 다른 정체성 문제이고, 두 번째 것은 연동과 마스터 데이터에서 다시 나옵니다.
개체는 저장소 그 이상이다
섹션 제목: “개체는 저장소 그 이상이다 ”이 장의 나머지를 읽기 전에 해 주셨으면 하는 전환이 있습니다. 개체는 데이터를 저장하는 곳만이 아닙니다. 필드는 열만이 아니고, 관계는 외래 키만이 아닙니다. 저도 가르칠 때 데이터베이스 비유를 씁니다. 사람들이 이미 아는 것과 연결되니까요. 하지만 거기서 멈추면 아키텍처를 놓칩니다.
우리가 고르는 개체가 어떤 기능이 함께 오는지를 정합니다. 필드 유형은 유효성 검사, 연동, 검색, 보고, 다른 시스템이 데이터를 읽는 방식에 영향을 줍니다. 관계는 생명주기, 소유권, 공유, 삭제를 정합니다. 데이터를 어디에 두느냐는 스토리지, 성능, 규모에 영향을 줍니다. 그리고 이 모든 것이 공유 플랫폼에서 돌아가므로, 레코드 100건에서 무해한 선택이 1억 건에서는 전혀 다르게 동작할 수 있습니다. 그 결정들을 하나씩 다뤄 보겠습니다.
시험 너머: AI가 바꾸는 것. 오랫동안 좋은 이름과 설명은 다음 관리자나 개발자가 우리가 만든 것을 이해하도록 도왔습니다. 이제는 기계도 그 맥락을 읽습니다.
Flag2__c라는 필드로 일하는 AI 시스템은 새 개발자와 같은 문제를 겪습니다. 이게 대체 무슨 뜻이지? 메타데이터는 더 이상 장식이 아닙니다. 기계가 애플리케이션을 이해하는 방식의 일부입니다.
아키텍트가 여기서 결정하는 것
섹션 제목: “아키텍트가 여기서 결정하는 것 ”- 나는 실제로 쓰는 플랫폼을 위해 설계하고 있는가, 아니면 Salesforce를 범용 데이터베이스처럼 다루고 있는가?
- 설계의 어느 부분이 비즈니스 개념이고, 어느 부분이 Salesforce 구현 선택인가?
- 지금 만들려는 구조와 함께 어떤 플랫폼 동작이 따라오는가?
- 어떤 제한이 공유 아키텍처의 표현이며, 그중 어떤 것이 이 설계를 형성할까?
- 이 구조를 나중에 바꾸기 어렵다면, 나는 그것을 아키텍처적인 결정으로 다루고 있는가?
2장에서 설정 화면에서 설계하지 말라고 했습니다. 이제 또 하나의 이유를 압니다. 새 사용자 정의 개체를 클릭하면 테이블 하나가 생기는 게 아니라, 아키텍처의 한 조각이 메타데이터 기반 멀티테넌트 플랫폼에 연결됩니다. 하지만 어떤 개체를 만들지 정하기 전에 더 기본적인 질문이 있습니다. 이 데이터가 애초에 여기 있어야 하는가? 다음 주제입니다.
더 알아보기
섹션 제목: “더 알아보기 ”- Salesforce Architects, Platform Multitenant Architecture (opens in a new tab)(영어), 확인일 2026-10-02, 재확인일 2026-10-12: 개체와 필드 정의는 새 테이블이 아니라 메타데이터로 저장된다. OrgID로 키가 매겨진 공유 테이블(MT_Objects, MT_Fields, MT_Data, MT_Indexes)이 있고, 같은 메타데이터가 REST와 SOAP API를 제공한다.
- Salesforce Architects, Architecture Basics (opens in a new tab)(영어), 확인일 2026-10-02, 재확인일 2026-10-12: 코드와 트랜잭션이 “공유 컴퓨팅 자원을 독점하지 않도록” 하는 거버너 제한과 실행 제한.